Intégrer une base de connaissances, c'est relier votre documentation aux systèmes dans lesquels vos équipes et vos clients travaillent déjà : CRM, support, chat, finance et produit. Bien faite, l'intégration met la réponse validée à portée de main dans l'outil utilisé, et les assistants IA récupèrent des informations à jour au lieu de deviner. Mal faite, elle copie des contenus obsolètes dans encore plus d'endroits. La différence tient à trois décisions : quelles sources font autorité, qui peut voir quoi, et comment le contenu reste à jour.
Ce guide s'adresse aux fondateurs, COO et responsables Finance, Ventes et Customer Success d'éditeurs SaaS B2B de 20 à 200 personnes environ. Il explique quoi connecter, comment choisir votre source de vérité, comment fonctionne l'automatisation, comment l'IA peut utiliser le résultat en toute sécurité, et ce que les règles européennes impliquent pour la conception.
En bref
- Une intégration de base de connaissances place des réponses validées dans les fiches CRM, les tickets, le chat et les assistants IA, afin que personne n'ait à changer d'outil ni à maintenir une seconde copie.
- Commencez par un registre des sources : décidez quel système fait autorité pour quel type de question, et écartez les contenus obsolètes ou en double avant de connecter quoi que ce soit.
- Traitez les autorisations comme des données. Tout ce qu'un utilisateur ne peut pas ouvrir dans le système source, l'IA ne doit pas le récupérer pour lui.
- L'automatisation doit repérer les lacunes et rédiger des projets de mise à jour. Une personne doit valider ce qui est publié.
- Au regard du RGPD et du règlement européen sur l'IA, concevez dès le premier jour en tenant compte de la localisation des données, du contrôle d'accès et des journaux d'audit, et demandez à votre conseil juridique de confirmer leur application à votre situation.
Sommaire
- Ce que signifie réellement l'intégration d'une base de connaissances
- Définissez d'abord votre source de vérité
- Comment intégrer, étape par étape
- Où l'automatisation de la base de connaissances est utile
- Permettre à l'IA d'utiliser la base de connaissances en toute sécurité
- Là où l'IA n'a pas sa place
- RGPD, NIS2 et règlement européen sur l'IA dans la conception
- Point de vue : pourquoi nous construisons d'abord les données
- Travaillez avec NordOps Consulting
- Une checklist avant la mise en production
- FAQ
- Sources
Ce que signifie réellement l'intégration d'une base de connaissances
Une base de connaissances seule est une bibliothèque. Une intégration en fait un service. Au lieu de demander aux utilisateurs de consulter un centre d'aide ou un wiki, l'article ou la réponse adéquats apparaissent dans une fiche CRM, un ticket de support, un chat en direct, Slack ou Microsoft Teams, ou un chatbot IA. Un aperçu des intégrations décrit cela comme le fait d'apporter les articles et la documentation pertinents dans les outils que les clients, les agents et les équipes utilisent déjà.
Pour une entreprise SaaS, les bénéfices sont concrets :
- Les agents de support répondent plus vite, car l'article validé se trouve à côté du ticket.
- Les Customer Success managers voient les bons conseils d'onboarding ou d'utilisation du produit sur le compte qu'ils traitent.
- Les ventes intègrent à un deal les réponses actuelles sur le produit et la sécurité, au lieu de solliciter un collègue.
- Les clients trouvent des réponses dans le produit ou dans le chat avant d'ouvrir un ticket.
- Les assistants IA récupèrent du contenu validé au lieu de l'inventer.
Remarquez ce qui manque dans cette liste : un nouvel outil. Les meilleures intégrations n'ajoutent aucun endroit où chercher. Elles en suppriment un.
Définissez d'abord votre source de vérité
La plupart des intégrations échouent avant même qu'un connecteur ne soit construit. L'entreprise a la même règle tarifaire dans une page de wiki, un champ CRM, une présentation et une macro de support, et les quatre se contredisent. Connectez les quatre à un assistant IA, et il citera celle qui est la mieux classée.
Selon un guide d'architecture, une base de connaissances en production s'appuie généralement sur six familles de contenu : les référentiels de documents, les systèmes de tickets, les hébergeurs de code, les archives de communication, les systèmes d'enregistrement structurés et les contenus externes faisant autorité. Pour une entreprise SaaS, les systèmes d'enregistrement structurés comptent le plus : votre CRM et votre système financier contiennent les faits que les autres contenus ne font que décrire.
Établir un registre des sources
Avant de connecter quoi que ce soit, rédigez une ligne par référentiel. Les champs utiles comprennent :
- Propriétaire : une personne nommément désignée, pas une équipe.
- Public : interne uniquement, destiné aux clients ou destiné aux partenaires.
- Classification des données, y compris la présence éventuelle de données personnelles.
- Faisant autorité pour quelles questions, et quelles sources prévalent en cas de conflit.
- Date de revue et durée de conservation.
- Comment les suppressions parviennent à l'index.
Écartez ensuite ce qui n'a pas sa place : brouillons obsolètes, copies en double, notes personnelles et tout contenu dont le propriétaire ne peut pas dire s'il est toujours exact.
Laissez les systèmes d'enregistrement l'emporter
Une règle simple fonctionne bien : si un fait réside dans un système structuré, le système structuré fait foi. La valeur du contrat, la date de renouvellement, l'offre, le statut des factures et l'usage relèvent des données CRM et financières. Les articles expliquent comment les utiliser ou les interpréter. Ils ne les reprennent jamais.
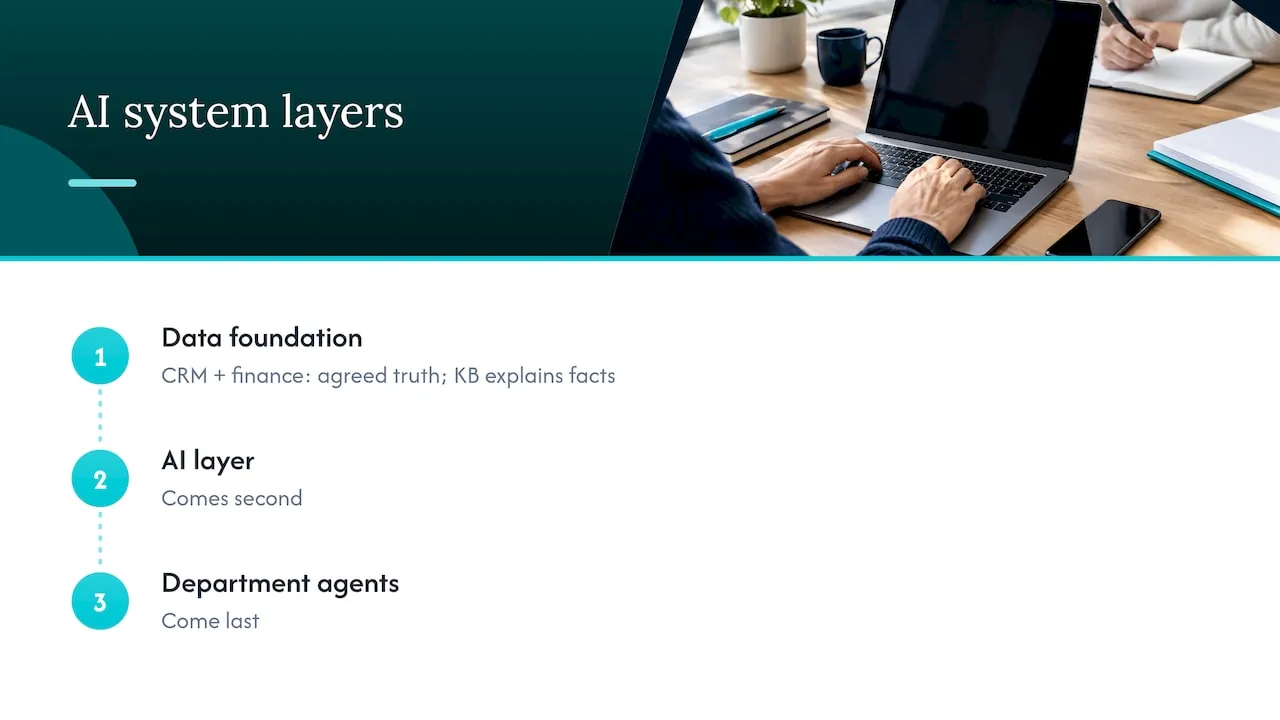
C'est le même ordre que nous suivons lorsque nous construisons de l'IA pour nos clients. La base de données vient en premier : les données CRM et financières comme version unique et convenue de la vérité, préparées par le Processor. La couche d'IA vient ensuite. Les agents par département viennent en dernier. Une base de connaissances s'insère dans cette structure comme couche explicative au-dessus de données fiables.
Comment intégrer, étape par étape
Une séquence pratique, s'appuyant sur les couches que partagent la plupart des déploiements en production : connecteurs, transformation, découpage et indexation, puis récupération et génération.
- Inventorier et classer les sources. Utilisez le registre ci-dessus.
- Connecter avec l'accès le plus restreint. Donnez à chaque connecteur les droits minimaux dont il a besoin. En lecture seule, sauf si un flux de travail réécrit réellement des données.
- Nettoyer et transformer. Supprimez les éléments de navigation superflus, normalisez les formats, conservez les titres, les responsables et les dates comme métadonnées.
- Découper selon le sens. Séparez le contenu aux limites naturelles, comme une procédure ou une clause de politique, et non selon un nombre arbitraire de caractères.
- Indexer avec des métadonnées. Enregistrez la source, l'horodatage, le public concerné et un indicateur de priorité afin que la récupération puisse privilégier le contenu faisant autorité.
- Tester la récupération avant la génération. Posez 50 questions réelles issues de votre historique de support et de ventes et vérifiez si le bon passage ressort. Ajoutez seulement ensuite une IA qui rédige les réponses.
- Déployer par étapes. D'abord un aperçu interne, puis un groupe restreint, puis un usage plus large.
Intégrez la fraîcheur et les autorisations à vos critères d'acceptation, et non à un nettoyage ultérieur. « Il renvoie la bonne réponse » ne suffit pas. Le test est : « Il renvoie la bonne réponse, à jour, et uniquement aux personnes autorisées à la voir. »
La conduite du changement compte autant que les connecteurs. Les équipes doivent savoir d'où viennent désormais les réponses et qui corrige une réponse erronée. Une formation au travail d'équipe et à la collaboration peut aider les équipes à s'accorder sur les responsabilités et à garder les contenus synchronisés entre les départements à mesure que le dispositif évolue.
Où l'automatisation de la base de connaissances est utile
L'automatisation est ce qui empêche une base de connaissances de se dégrader. La plupart des contenus deviennent obsolètes non par paresse, mais parce que personne n'est prévenu quand le produit a changé.
Les tâches d'automatisation courantes sont les suivantes :
- Rédiger de nouveaux articles à partir de tickets résolus, de transcriptions de chat ou de notes de version.
- Capturer les réponses qui apparaissent dans les fils Slack ou les réponses du support.
- Organiser le contenu en l'étiquetant et en repérant les quasi-doublons.
- Diffuser les articles dans le chat, dans le produit ou via un assistant IA.
- Actualiser le contenu en signalant les articles touchés par un changement de produit et en rédigeant les modifications.
Le choix de conception essentiel est la place de l'humain. Un guide sur les contenus de support qui se mettent à jour seuls fait le même constat : la partie automatique consiste à détecter les lacunes et à rédiger les modifications, et une personne relit avant toute mise en ligne. Nous construisons de la même façon. Le système propose, un responsable nommé approuve.
Un autre schéma mérite d'être connu : la boucle qui réinjecte les connaissances acquises. Les conversations sont capturées, converties en une forme consultable, utilisées pour répondre aux questions, et les nouvelles connaissances sont renvoyées dans le système de référence. Cette boucle ne fonctionne que si le système de référence est propre dès le départ.
Pour un examen plus approfondi d'un processus où cela est rentable, consultez notre article sur l'automatisation de l'onboarding pour les SaaS B2B.
Permettre à l'IA d'utiliser la base de connaissances en toute sécurité
Un assistant IA connecté à votre base de connaissances peut faire deux choses : lire et agir. Les deux exigent des garde-fous.
Lire : les autorisations suivent l'utilisateur
L'échec grave le plus fréquent est un assistant qui fait remonter un document que la personne à l'origine de la question n'avait jamais le droit d'ouvrir. La solution consiste à traiter les autorisations comme des données. Un article technique sur les intégrations sécurisées recommande qu'un agent comprenne et représente le modèle d'autorisations du système source avant de traiter une page, et que la récupération filtre les documents au moment de la requête selon l'identité de l'utilisateur courant. Il conseille aussi d'actualiser les listes d'accès aussi souvent que le contenu, car un document restreint ce matin ne doit pas être servi cet après-midi.
Le guide d'intégration des connecteurs Copilot publié par Microsoft donne une règle concrète à reprendre quelle que soit la plateforme : limiter l'accès aux personnes qui l'ont déjà plutôt qu'à « Tout le monde », et inclure au moins un test négatif sur votre contenu le plus sensible, par exemple des documents RH restreints. Si ce test renvoie du contenu, arrêtez le déploiement.
Agir : ancré, journalisé, borné
Lorsqu'un agent fait plus que répondre, par exemple mettre à jour un enregistrement ou déclencher un processus, le schéma est le même. AWS décrit un flux de travail d'agent ancré dans lequel l'agent détermine l'intention, consulte la politique dans la base de connaissances, n'appelle une action que si la demande est éligible, et le fait dans le respect de garde-fous et avec journalisation. Leurs recommandations sur l'ancrage et la récupération ajoutent des points de gouvernance à inscrire sur votre liste de contrôle : qualité des données sources, contrôle d'accès par identité et par rôle, politiques de versionnage et de fraîcheur, journalisation d'audit et boucles de retour pour les corrections.
Notre propre conception suit la même forme : les agents travaillent dans le cadre des autorisations, demandent une approbation lorsque l'action est importante et laissent une piste d'audit.
Réduire les réponses erronées
Pour les questions dont vous disposez déjà d'une réponse vérifiée, vous pouvez vous passer entièrement de la génération. AWS décrit un cache sémantique vérifié qui renvoie directement une réponse validée lorsqu'une requête correspond de près à une question connue, et ne recourt au modèle que pour les requêtes peu similaires. Le principe s'applique largement : lorsqu'une réponse approuvée existe, servez-la.
Là où l'IA n'a pas sa place
Être explicite sur les limites rend une intégration plus sûre et moins coûteuse.
- Tarifs, remises et conditions contractuelles. Servez-les à partir de l'enregistrement CRM ou financier, ou orientez vers une personne. Ne laissez pas un modèle les paraphraser.
- Les décisions qui affectent les droits ou les moyens de subsistance des personnes, comme le recrutement ou l'évaluation de crédit. Le règlement européen sur l'IA (EU AI Act) considère certains systèmes de ces domaines comme à haut risque, avec des obligations plus strictes.
- Conseils juridiques, fiscaux et médicaux. La récupération peut renvoyer vers le texte approuvé. Elle ne doit pas l'interpréter.
- Contenu sans responsable. Si personne ne peut se porter garant d'un document, il n'a pas sa place dans l'index.
- Publication sans relecture. L'IA peut rédiger. Un humain publie.
- Accès large et non délimité. Un assistant qui peut tout voir est une fuite de données en attente de la bonne question.
Adoptez un processus à la fois, en commençant par le plus coûteux. La déflexion du support ou les questionnaires de sécurité commerciaux sont souvent de bons premiers candidats, car le volume est élevé et les réponses approuvées existent déjà.
RGPD, NIS2 et règlement européen sur l'IA dans la conception
Si votre base de connaissances contient des données personnelles de personnes situées dans l'UE, sa conception doit tenir compte des règles européennes dès le départ, et non après le lancement. En termes généraux :
- Le GDPR s'applique dès que des données personnelles de personnes situées dans l'UE sont traitées. Cela couvre les noms de clients, les e-mails et le contenu des tickets présents dans votre index. Il faut réfléchir à l'endroit où les données sont stockées et traitées, aux prestataires qui agissent comme sous-traitants et nécessitent un accord de traitement des données, à la durée de conservation des contenus, et à la manière de supprimer les données d'une personne à la fois de la source et de l'index.
- La limitation des finalités compte dès lors qu'un fournisseur est impliqué. Vérifiez que les contenus que vous indexez pour la recherche ne sont pas réutilisés pour entraîner les propres modèles d'un prestataire.
- L'EU AI Act fixe des obligations selon la catégorie de risque. De nombreux cas d'usage de base de connaissances, comme répondre à des questions sur le produit, présentent un risque plus faible, mais les obligations de transparence et les catégories à haut risque méritent tout de même un examen.
- NIS2 concerne la gestion des risques de cybersécurité pour les entités concernées. Savoir si votre entreprise entre dans le champ d'application est une question à poser à votre conseiller juridique.
Ces cadres se recoupent en pratique. Le contrôle d'accès, la journalisation et les analyses de risques documentées servent plusieurs d'entre eux à la fois. Rien de tout cela ne constitue un avis juridique, et aucune architecture ne garantit la conformité. Demandez à votre conseil ou à votre délégué à la protection des données de confirmer ce qui s'applique à vous. Notre cadre de gouvernance de l'IA pour le SaaS B2B en détaille l'aspect pratique.
Point de vue : pourquoi nous construisons d'abord les données
On nous interroge sur les bases de connaissances lorsque quelque chose s'est déjà mal passé : un assistant a cité les tarifs de l'année dernière, un agent du support a collé une réponse contredisant le contrat, ou quelqu'un a trouvé un document interne dans une réponse de chat.
Dans presque tous les cas, la base de connaissances n'était pas le problème. Le problème, c'est que personne n'était responsable de la vérité. Le CRM disait une chose, le système financier une autre, et le wiki une troisième. Connecter un assistant IA aux trois n'a fait que rendre le désaccord plus rapide.
C'est pourquoi nous travaillons dans un ordre précis. D'abord le socle de données : les données CRM et financières réunies en une seule version de la vérité, validée par tous. Ensuite la couche IA, qui connecte ces données à l'assistant que votre entreprise utilise déjà. Puis les agents par département pour la Finance, les Ventes et le Customer Success, que vos propres équipes utilisent en langage courant, dans le cadre de leurs droits, avec validation là où c'est important et une piste d'audit.
Nous disons aussi où l'IA doit rester à l'écart : les conditions contractuelles, les décisions concernant des personnes, et tout contenu sans responsable. Une base de connaissances est utile lorsqu'elle est ciblée, à jour et soumise à des droits d'accès. Elle devient un risque lorsqu'elle est volumineuse et sans responsable.
L'entreprise conserve ce que nous construisons : code source, documentation et infrastructure sont transférés lors de la remise, et la construction, le pilote et les tests s'exécutent sur une infrastructure européenne auto-hébergée en Allemagne.
Claus Nielsen
Travaillez avec NordOps Consulting
Si vos équipes utilisent déjà l'IA mais que personne n'en est responsable, la première étape est généralement d'obtenir une vision claire de vos données et des endroits où l'IA est rentable. Notre AI Readiness Assessment démarre à partir de €4,500 et examine votre socle de données, vos processus et votre situation réglementaire. Pour une prise en charge continue, l'abonnement Chief AI Officer à temps partagé démarre à partir de €1,500 par mois au niveau Advisor, à partir de €3,250 au niveau Operating et à partir de €5,500 au niveau Embedded.
Les réalisations sont facturées à 30% de l'économie de la première année, une fois mesurée et prouvée, ou à un prix fixe convenu avant le début des travaux. Vous trouverez la liste complète sur la page des tarifs, ou vous pouvez commencer par un appel de découverte gratuit de 30 minutes. Nos agents IA pour la Finance, les Ventes et le Customer Success montrent à quoi ressemble la couche départementale une fois les données en ordre.
Une checklist avant la mise en production
- Chaque source a un responsable nommé, un public cible et une date de révision.
- Pour chaque type de question, une source est désignée comme faisant autorité.
- Les connecteurs utilisent par défaut les périmètres les plus restreints et un accès en lecture seule.
- Les droits d'accès sont synchronisés aussi souvent que les contenus, et les suppressions se répercutent dans l'index.
- Un test négatif sur vos contenus les plus sensibles est réussi.
- La recherche est testée sur de vraies questions avant que tout modèle ne rédige des réponses.
- L'IA rédige, les humains publient.
- Les actions sont journalisées et nécessitent une validation lorsque les enjeux sont élevés.
- La localisation des données, les sous-traitants et la durée de conservation sont documentés et examinés par votre conseiller juridique.
- Quelqu'un est responsable du dispositif après le lancement.
FAQ
À quoi sert l'intégration d'une base de connaissances ?
Elle place des réponses validées dans les outils que les équipes utilisent déjà, comme le CRM, le service d'assistance, la messagerie et les assistants IA. On gagne ainsi du temps en évitant de passer d'un outil à l'autre, et on évite de maintenir des copies en double. Elle offre aussi à l'IA une source contrôlée où puiser.
À quoi une base de connaissances peut-elle se connecter ?
Les sources courantes sont les référentiels de documents, les systèmes de tickets, les outils de communication, les plateformes d'hébergement de code et les systèmes de référence structurés comme le CRM et la finance. Pour les entreprises SaaS, les systèmes de référence doivent faire autorité pour des faits comme le forfait, le prix et la date de renouvellement. Les articles expliquent, et les enregistrements établissent les faits.
Les mises à jour d'une base de connaissances peuvent-elles être entièrement automatisées ?
La détection et la rédaction peuvent être automatisées : repérer les lacunes, proposer de nouveaux articles et signaler les contenus périmés. La publication doit rester à la charge d'un relecteur nommé, surtout pour tout ce qui s'adresse aux clients ou qu'une IA va citer.
Comment empêcher un assistant IA d'exposer des documents à accès restreint ?
Reprenez les droits d'accès du système source dans l'index et filtrez les résultats selon l'identité de la personne qui pose la question. Actualisez les droits aussi souvent que les contenus, et réalisez un test négatif sur vos contenus les plus sensibles avant le lancement.
Cela nécessite-t-il un examen juridique en Europe ?
Oui, en pratique. Le GDPR, NIS2 et l'EU AI Act peuvent chacun s'appliquer selon vos données et votre cas d'usage. Un conseiller juridique ou un délégué à la protection des données doit confirmer ce qui s'applique à vous.
Sources
- Intégrations de bases de connaissances : architecture et tests
- Enterprise Knowledge Base for AI: Architecture Guide
- AI Support Knowledge Base That Updates Itself
- Build Secure Knowledge Base Integrations for AI Agents (DZone)
- Microsoft Copilot Connector Knowledge Onboarding Runbook
- AWS Prescriptive Guidance: Grounded agent AI workflow
- AWS Prescriptive Guidance: Grounding and Retrieval Augmented Generation
- AWS Machine Learning Blog : réduire les hallucinations grâce à un cache sémantique vérifié