Integracja bazy wiedzy oznacza połączenie dokumentacji z systemami, w których Twój zespół i klienci już pracują: CRM, helpdeskiem, czatem, finansami i produktem. Dobrze wdrożona sprawia, że ludzie otrzymują zatwierdzoną odpowiedź w narzędziu, z którego korzystają, a asystenci AI pobierają aktualne informacje zamiast zgadywać. Źle wdrożona kopiuje nieaktualne treści w kolejne miejsca. Różnica sprowadza się do trzech decyzji: które źródła są wiarygodne, kto może co widzieć i jak treści pozostają aktualne.
Ten przewodnik jest przeznaczony dla założycieli, COO oraz szefów działów finansów, sprzedaży i Customer Success w firmach B2B SaaS zatrudniających mniej więcej od 20 do 200 osób. Opisuje, co warto połączyć, jak wybrać źródło prawdy, jak działa automatyzacja, jak AI może bezpiecznie wykorzystać efekt oraz co europejskie przepisy oznaczają dla projektu.
W skrócie
- Integracja bazy wiedzy umieszcza zatwierdzone odpowiedzi w rekordach CRM, zgłoszeniach, czacie i asystentach AI, dzięki czemu nikt nie musi przełączać narzędzi ani utrzymywać drugiej kopii.
- Zacznij od rejestru źródeł: ustal, który system jest wiarygodny dla jakiego typu pytań, i wyklucz nieaktualne lub zduplikowane treści, zanim cokolwiek połączysz.
- Traktuj uprawnienia jak dane. Czego użytkownik nie może otworzyć w systemie źródłowym, tego AI nie może pobrać w jego imieniu.
- Automatyzacja powinna wykrywać luki i przygotowywać projekty aktualizacji. To człowiek powinien zatwierdzać, co zostanie opublikowane.
- W kontekście RODO i EU AI Act od pierwszego dnia projektuj z myślą o lokalizacji danych, kontroli dostępu i ścieżkach audytu, a u swojego doradcy prawnego potwierdź, jak te przepisy dotyczą Twojej firmy.
Spis treści
- Co naprawdę oznacza integracja bazy wiedzy
- Najpierw ustal swoje źródło prawdy
- Jak przeprowadzić integrację krok po kroku
- Gdzie pomaga automatyzacja bazy wiedzy
- Jak pozwolić AI bezpiecznie korzystać z bazy wiedzy
- Gdzie AI nie ma zastosowania
- RODO, NIS2 i EU AI Act w projekcie
- Perspektywa: dlaczego najpierw budujemy dane
- Współpraca z NordOps Consulting
- Lista kontrolna przed uruchomieniem
- FAQ
- Źródła
Co naprawdę oznacza integracja bazy wiedzy
Sama baza wiedzy jest biblioteką. Integracja zmienia ją w usługę. Zamiast prosić ludzi o wejście do centrum pomocy lub wiki, właściwy artykuł albo odpowiedź pojawia się w rekordzie CRM, zgłoszeniu do wsparcia, czacie na żywo, w Slacku lub Microsoft Teams albo w chatbocie AI. Jeden z przeglądów integracji opisuje to jako udostępnianie odpowiednich artykułów i dokumentacji w narzędziach, z których już korzystają klienci, agenci i zespoły.
Dla firmy SaaS korzyści są praktyczne:
- Agenci wsparcia odpowiadają szybciej, bo zatwierdzony artykuł znajduje się obok zgłoszenia.
- Menedżerowie Customer Success widzą właściwe wskazówki dotyczące wdrożenia lub produktu na koncie, nad którym pracują.
- Sprzedaż pobiera aktualne odpowiedzi o produkcie i bezpieczeństwie do transakcji, zamiast pytać kolegę.
- Klienci znajdują odpowiedzi w produkcie lub na czacie, zanim otworzą zgłoszenie.
- Asystenci AI pobierają zatwierdzone treści zamiast je wymyślać.
Zwróć uwagę, czego na tej liście brakuje: nowego narzędzia. Najlepsze integracje nie dodają nowego miejsca, w którym trzeba szukać. Usuwają jedno.
Najpierw ustal swoje źródło prawdy
Większość nieudanych integracji zawodzi, zanim powstanie jakikolwiek konektor. Firma ma tę samą zasadę cenową na stronie wiki, w polu CRM, w prezentacji i w makrze wsparcia, a te cztery wersje się różnią. Połącz wszystkie cztery z asystentem AI, a zacytuje tę, która znajdzie się najwyżej w wynikach.
Według przewodnika po architekturze produkcyjna baza wiedzy zwykle czerpie z sześciu rodzin treści: repozytoriów dokumentów, systemów zgłoszeń, hostingów kodu, archiwów komunikacji, ustrukturyzowanych systemów ewidencyjnych oraz zewnętrznych treści o charakterze autorytatywnym. Dla firmy SaaS najważniejsze są ustrukturyzowane systemy ewidencyjne: Twój CRM i system finansowy zawierają fakty, które inne treści jedynie opisują.
Zbuduj rejestr źródeł
Zanim cokolwiek połączysz, zapisz jedną linię na każde repozytorium. Przydatne pola to:
- Właściciel: konkretna osoba, nie zespół.
- Odbiorcy: tylko wewnętrzni, klienci lub partnerzy.
- Klasyfikacja danych, w tym informacja, czy zawierają dane osobowe.
- Wiarygodność dla jakich pytań oraz które źródła mają pierwszeństwo w razie konfliktu.
- Data przeglądu i okres przechowywania.
- W jaki sposób usunięcia docierają do indeksu.
Następnie wyklucz to, czego tam być nie powinno: nieaktualne wersje robocze, zduplikowane kopie, osobiste notatki i wszystko, czego właściciel nie potrafi ocenić pod kątem aktualności.
Niech wygrywają systemy ewidencyjne
Sprawdza się prosta zasada: jeśli fakt znajduje się w systemie ustrukturyzowanym, to ten system ma pierwszeństwo. Wartość kontraktu, data odnowienia, plan, status faktury i zużycie należą do danych CRM i danych finansowych. Artykuły wyjaśniają, jak z nich korzystać i jak je interpretować. Nigdy ich nie powtarzają.
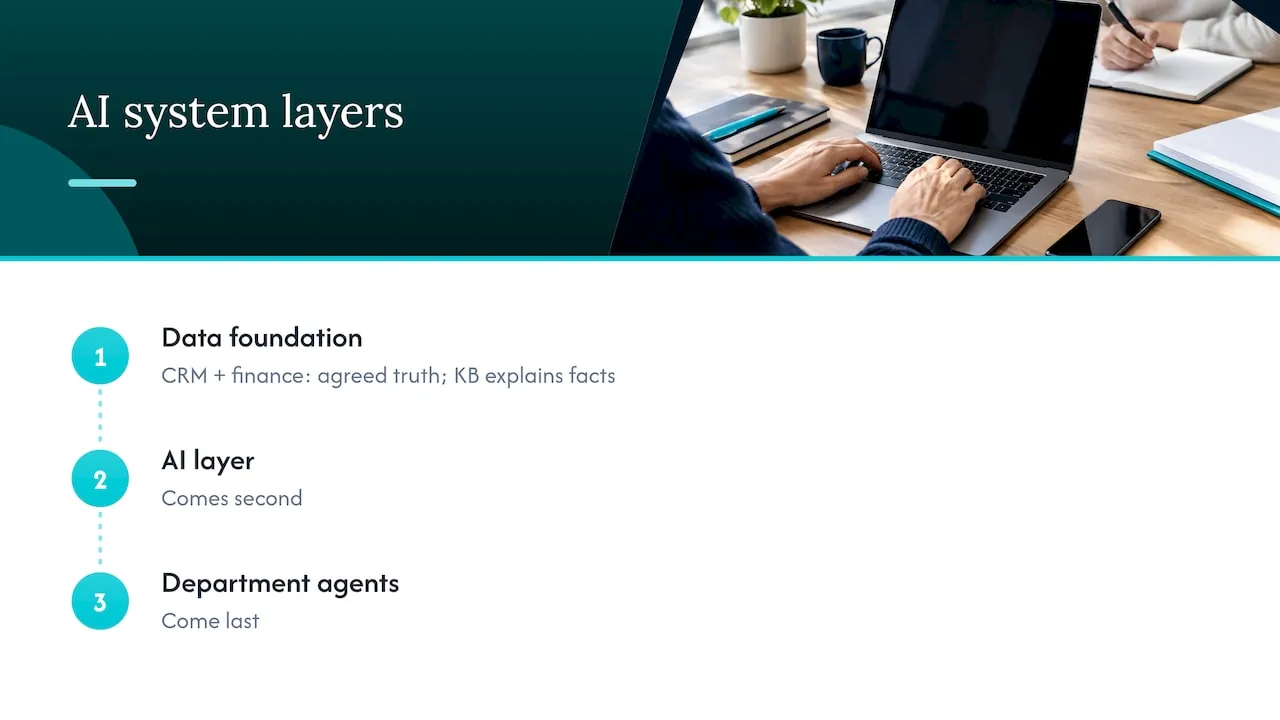
To ta sama kolejność, której używamy, budując AI dla klientów. Najpierw fundament danych: dane CRM i finansowe jako jedna uzgodniona wersja prawdy, przygotowane przez Processor. Warstwa AI jest druga. Agenci działowi są na końcu. Baza wiedzy mieści się w tej strukturze jako warstwa wyjaśniająca, osadzona na wiarygodnych danych.
Jak przeprowadzić integrację krok po kroku
Praktyczna sekwencja, oparta na warstwach, które ma większość wdrożeń produkcyjnych: konektory, transformacja, dzielenie na fragmenty i indeksowanie, a następnie wyszukiwanie i generowanie.
- Zinwentaryzuj źródła i uszereguj je według ważności. Skorzystaj z rejestru powyżej.
- Łącz z możliwie najwęższym dostępem. Nadaj każdemu konektorowi najmniejszy zakres uprawnień, jakiego potrzebuje. Tylko do odczytu, chyba że przepływ pracy naprawdę zapisuje dane z powrotem.
- Oczyść i przekształć. Usuń zbędne elementy nawigacji, ujednolić formaty, zachowaj tytuły, właścicieli i daty jako metadane.
- Dziel według znaczenia. Dziel treść w naturalnych miejscach, takich jak procedura lub klauzula polityki, a nie według dowolnej liczby znaków.
- Indeksuj z metadanymi. Zapisuj źródło, znacznik czasu, odbiorców i flagę priorytetu, aby wyszukiwanie mogło faworyzować treści autorytatywne.
- Testuj wyszukiwanie przed generowaniem. Zadaj 50 prawdziwych pytań z historii wsparcia i sprzedaży i sprawdź, czy wraca właściwy fragment. Dopiero potem dodaj AI, które pisze odpowiedzi.
- Wdrażaj etapami. Najpierw wewnętrzny podgląd, potem ograniczona grupa, następnie szersze użycie.
Uwzględnij aktualność i uprawnienia w kryteriach akceptacji, a nie w późniejszych porządkach. „Zwraca właściwą odpowiedź” to za mało. Testem jest: „zwraca właściwą, aktualną odpowiedź i tylko osobom, które mogą ją zobaczyć”.
Zarządzanie zmianą jest równie ważne jak konektory. Ludzie muszą wiedzieć, skąd teraz pochodzą odpowiedzi i kto poprawia błędną. Szkolenia z zakresu pracy zespołowej i współpracy mogą pomóc zespołom uzgodnić odpowiedzialność i utrzymać synchronizację treści między działami w miarę zmian w rozwiązaniu.
Gdzie pomaga automatyzacja bazy wiedzy
Automatyzacja to miejsce, w którym baza wiedzy przestaje się starzeć. Większość treści dezaktualizuje się nie dlatego, że ludzie są leniwi, ale dlatego, że nikt nie dowiaduje się o zmianie produktu.
Najczęstsze zadania automatyzacji to:
- Tworzenie szkiców nowych artykułów na podstawie rozwiązanych zgłoszeń, transkrypcji czatów lub informacji o wydaniach.
- Przechwytywanie odpowiedzi pojawiających się w wątkach na Slacku lub w odpowiedziach wsparcia.
- Porządkowanie treści przez tagowanie i wykrywanie niemal identycznych duplikatów.
- Udostępnianie artykułów na czacie, w produkcie lub przez asystenta AI.
- Odświeżanie treści przez oznaczanie artykułów, których dotyczy zmiana produktu, i przygotowywanie szkiców poprawek.
Ważnym wyborem projektowym jest to, gdzie w procesie jest człowiek. Przewodnik o samoaktualizujących się treściach wsparcia wskazuje to samo: automatyczne jest wykrywanie luk i przygotowywanie szkiców zmian, a przed opublikowaniem czegokolwiek weryfikuje je człowiek. My budujemy to tak samo. System proponuje, wskazany właściciel zatwierdza.
Warto znać jeszcze jeden wzorzec: pętlę, która zapisuje wnioski z powrotem. Rozmowy są przechwytywane, zamieniane na postać z możliwością przeszukiwania, wykorzystywane do odpowiadania na pytania, a nowa wiedza trafia z powrotem do systemu źródłowego. Ta pętla działa tylko wtedy, gdy system źródłowy jest od początku uporządkowany.
Aby dokładniej przyjrzeć się jednemu procesowi, w którym to się opłaca, zobacz nasz artykuł o automatyzacji onboardingu w B2B SaaS.
Jak pozwolić AI bezpiecznie korzystać z bazy wiedzy
Asystent AI połączony z Twoją bazą wiedzy może robić dwie rzeczy: czytać i działać. Obie wymagają zabezpieczeń.
Czytanie: uprawnienia podążają za użytkownikiem
Najczęstszą poważną awarią jest asystent, który pokazuje dokument, którego osoba pytająca nigdy nie miała prawa otworzyć. Rozwiązaniem jest traktowanie uprawnień jako danych. Jeden techniczny artykuł o bezpiecznych integracjach zaleca, aby agent rozumiał i odwzorowywał model uprawnień systemu źródłowego, zanim przetworzy jakąkolwiek stronę, oraz aby wyszukiwanie filtrowało dokumenty w momencie zapytania według tożsamości bieżącego użytkownika. Radzi też odświeżać listy dostępu równie często jak treści, ponieważ dokument, który rano był objęty ograniczeniem, nie powinien być udostępniany po południu.
Opublikowany przez Microsoft podręcznik wdrożenia konektorów Copilot podaje konkretną regułę, którą warto skopiować niezależnie od platformy: ogranicz dostęp do osób, które już go mają, zamiast do „Everyone”, i uwzględnij co najmniej jeden test negatywny na najbardziej wrażliwych treściach, takich jak materiały HR objęte ograniczeniem. Jeśli ten test zwróci treść, zatrzymaj wdrożenie.
Działanie: oparte na źródłach, rejestrowane, ograniczone
Gdy agent robi więcej niż odpowiada, na przykład aktualizuje rekord lub uruchamia proces, wzorzec jest ten sam. AWS opisuje przepływ pracy agenta opartego na źródłach, w którym agent ustala intencję, sprawdza politykę w bazie wiedzy, wywołuje akcję tylko wtedy, gdy żądanie się kwalifikuje, i robi to wszystko w ramach zabezpieczeń oraz z rejestrowaniem. Ich wytyczne dotyczące opierania na źródłach i wyszukiwania dodają elementy nadzoru warte umieszczenia na Twojej liście kontrolnej: jakość danych źródłowych, kontrolę dostępu według tożsamości i roli, polityki wersjonowania i aktualności, rejestrowanie audytowe oraz pętle informacji zwrotnej dla poprawek.
Nasz własny projekt ma ten sam kształt: agenci działają w ramach uprawnień, proszą o zatwierdzenie tam, gdzie działanie ma znaczenie, i pozostawiają ślad audytowy.
Ograniczanie błędnych odpowiedzi
W przypadku pytań, na które masz już zweryfikowaną odpowiedź, można całkowicie pominąć generowanie. AWS opisuje zweryfikowaną pamięć podręczną semantyczną, która zwraca wyselekcjonowaną odpowiedź bezpośrednio, gdy zapytanie ściśle odpowiada znanemu pytaniu, a do modelu przechodzi tylko przy zapytaniach o niskim podobieństwie. Zasada ma szerokie zastosowanie: jeśli istnieje zatwierdzona odpowiedź, udostępnij ją.
Gdzie AI nie ma zastosowania
Jasne określenie granic sprawia, że integracja jest bezpieczniejsza i tańsza.
- Ceny, rabaty i warunki umów. Udostępniaj je z rekordu w CRM lub w danych finansowych albo kieruj do człowieka. Nie pozwalaj, by model je parafrazował.
- Decyzje wpływające na prawa lub źródła utrzymania ludzi, takie jak rekrutacja czy ocena zdolności kredytowej. Akt w sprawie sztucznej inteligencji (EU AI Act) traktuje niektóre systemy w tych obszarach jako wysokiego ryzyka, z surowszymi obowiązkami.
- Porady prawne, podatkowe i medyczne. Wyszukiwanie może wskazać zatwierdzony tekst. Nie powinno go interpretować.
- Treści, których nikt nie posiada. Jeśli żadna osoba nie może poręczyć za dokument, nie należy on do indeksu.
- Publikowanie bez weryfikacji. AI może przygotować szkic. Publikuje człowiek.
- Szeroki dostęp bez zakresu. Asystent, który widzi wszystko, to naruszenie danych czekające na odpowiednie pytanie.
Wdrażaj jeden proces naraz, zaczynając od najkosztowniejszego. Dobrymi pierwszymi kandydatami są często odciążenie wsparcia lub kwestionariusze bezpieczeństwa w sprzedaży, ponieważ wolumen jest duży, a zatwierdzone odpowiedzi już istnieją.
RODO, NIS2 i EU AI Act w projekcie
Jeśli Państwa baza wiedzy zawiera dane osobowe osób w UE, projekt powinien uwzględniać przepisy europejskie od początku, a nie dopiero po uruchomieniu. Ogólnie rzecz biorąc:
- GDPR ma zastosowanie, gdy przetwarzane są dane osobowe osób w UE. Obejmuje to imiona i nazwiska klientów, adresy e-mail oraz treść zgłoszeń w Państwa indeksie. Należy zastanowić się, gdzie dane są przechowywane i przetwarzane, którzy dostawcy działają jako podmioty przetwarzające i wymagają umowy powierzenia przetwarzania danych, jak długo treści są przechowywane oraz jak usunąć dane jednej osoby zarówno ze źródła, jak i z indeksu.
- Ograniczenie celu ma znaczenie, gdy w grę wchodzi dostawca. Proszę sprawdzić, czy treści indeksowane na potrzeby wyszukiwania nie są ponownie wykorzystywane do trenowania własnych modeli dostawcy.
- EU AI Act nakłada obowiązki w zależności od kategorii ryzyka. Wiele zastosowań bazy wiedzy, takich jak odpowiadanie na pytania o produkt, wiąże się z niższym ryzykiem, ale obowiązki w zakresie przejrzystości i kategorie wysokiego ryzyka nadal wymagają sprawdzenia.
- NIS2 dotyczy zarządzania ryzykiem cyberbezpieczeństwa w podmiotach objętych jej zakresem. To, czy Państwa firma jest nim objęta, jest pytaniem do doradcy prawnego.
W praktyce te regulacje się przenikają. Kontrola dostępu, rejestrowanie zdarzeń i udokumentowane oceny ryzyka służą kilku z nich jednocześnie. Nic z tego nie stanowi porady prawnej, a żadna architektura nie gwarantuje zgodności. Proszę poprosić swojego radcę prawnego lub inspektora ochrony danych o potwierdzenie, co Państwa dotyczy. Nasze ramy zarządzania AI dla B2B SaaS omawiają stronę praktyczną.
Perspektywa: dlaczego najpierw budujemy dane
Pytania o bazy wiedzy otrzymujemy, gdy coś już poszło nie tak: asystent zacytował zeszłoroczny cennik, konsultant wsparcia wkleił odpowiedź sprzeczną z umową albo ktoś znalazł dokument wewnętrzny w odpowiedzi czatu.
Prawie zawsze problemem nie była baza wiedzy. Problem polegał na tym, że nikt nie odpowiadał za prawdę. CRM mówił jedno, system finansowy drugie, a wiki trzecie. Podłączenie asystenta AI do wszystkich trzech po prostu przyspieszyło tę niespójność.
Dlatego pracujemy w ustalonej kolejności. Najpierw fundament danych: dane z CRM i finansów przekształcone w jedną uzgodnioną wersję prawdy. Następnie warstwa AI, łącząca te dane z asystentem, z którego Państwa firma już korzysta. Potem agenci działowi dla Finansów, Sprzedaży i Customer Success, z których Państwa pracownicy korzystają zwykłym językiem, w ramach uprawnień, z zatwierdzaniem tam, gdzie to ważne, i ścieżką audytu.
Mówimy też, gdzie AI powinno się nie pojawiać: warunki umów, decyzje dotyczące ludzi i wszelkie treści bez właściciela. Baza wiedzy jest użyteczna, gdy jest wąska, aktualna i objęta uprawnieniami. Staje się obciążeniem, gdy jest duża i bez właściciela.
Firma zachowuje to, co zbudujemy: kod źródłowy, dokumentacja i infrastruktura są przekazywane przy przekazaniu projektu, a budowa, pilotaż i testy odbywają się na własnej, europejskiej infrastrukturze w Niemczech.
Claus Nielsen
Współpraca z NordOps Consulting
Jeśli Państwa zespół już korzysta z AI, ale nikt za nie nie odpowiada, pierwszym krokiem jest zwykle jasny obraz Państwa danych i miejsc, w których AI się opłaca. Nasz AI Readiness Assessment kosztuje od €4,500 i obejmuje fundament danych, procesy oraz sytuację regulacyjną. W zakresie stałej odpowiedzialności abonament Fractional Chief AI Officer zaczyna się od €1,500 miesięcznie na poziomie Advisor, od €3,250 na poziomie Operating i od €5,500 na poziomie Embedded.
Wdrożenia wyceniamy na 30% oszczędności w pierwszym roku, po ich zmierzeniu i potwierdzeniu, albo według stałej ceny uzgodnionej przed rozpoczęciem prac. Pełną listę zobaczą Państwo na stronie z cennikiem, można też zacząć od bezpłatnej 30-minutowej rozmowy wstępnej. Nasi agenci AI dla Finansów, Sprzedaży i Customer Success pokazują, jak wygląda warstwa działowa, gdy dane są uporządkowane.
Lista kontrolna przed uruchomieniem
- Każde źródło ma wskazanego właściciela, grupę odbiorców i datę przeglądu.
- Dla każdego typu pytania jedno źródło jest oznaczone jako wiarygodne.
- Konektory domyślnie używają najwęższych zakresów uprawnień i dostępu tylko do odczytu.
- Uprawnienia są synchronizowane równie często jak treści, a usunięcia trafiają do indeksu.
- Test negatywny na Państwa najbardziej wrażliwych treściach zostaje zaliczony.
- Wyszukiwanie jest testowane na prawdziwych pytaniach, zanim jakikolwiek model zacznie pisać odpowiedzi.
- AI przygotowuje szkice, ludzie publikują.
- Działania są rejestrowane i wymagają zatwierdzenia tam, gdzie stawka jest wysoka.
- Lokalizacja danych, podmioty przetwarzające i okresy przechowywania są udokumentowane i sprawdzone przez Państwa doradcę prawnego.
- Ktoś odpowiada za całość po uruchomieniu.
FAQ
Jaki jest cel integracji bazy wiedzy?
Umieszcza zatwierdzone odpowiedzi w narzędziach, z których ludzie już korzystają, takich jak CRM, system obsługi zgłoszeń, czat i asystenci AI. Oszczędza to czas na przełączanie się między narzędziami i pozwala uniknąć utrzymywania zduplikowanych kopii. Daje też AI kontrolowane źródło, z którego może pobierać informacje.
Z czym można połączyć bazę wiedzy?
Typowe źródła to repozytoria dokumentów, systemy zgłoszeń, narzędzia komunikacji, hosty kodu oraz ustrukturyzowane systemy rejestrowe, takie jak CRM i finanse. W firmach SaaS to systemy rejestrowe powinny być autorytatywnym źródłem faktów takich jak plan, cena i data odnowienia. Artykuły wyjaśniają, a rejestry stwierdzają.
Czy aktualizacje bazy wiedzy można w pełni zautomatyzować?
Wykrywanie i przygotowywanie szkiców można zautomatyzować: wskazywanie luk, proponowanie nowych artykułów i oznaczanie nieaktualnych. Publikacja powinna pozostać w rękach wskazanego recenzenta, zwłaszcza w przypadku wszystkiego, co jest skierowane do klientów lub co AI będzie cytować.
Jak zapobiec ujawnianiu przez asystenta AI dokumentów o ograniczonym dostępie?
Należy przenieść uprawnienia systemu źródłowego do indeksu i filtrować wyniki według tożsamości osoby zadającej pytanie. Uprawnienia trzeba odświeżać równie często jak treści, a przed uruchomieniem przeprowadzić test negatywny na najbardziej wrażliwych materiałach.
Czy wymaga to przeglądu prawnego w Europie?
Tak, w praktyce tak. GDPR, NIS2 i EU AI Act mogą mieć zastosowanie, każde zależnie od Państwa danych i przypadku użycia. Doradca prawny lub inspektor ochrony danych powinien potwierdzić, co Państwa dotyczy.
Źródła
- Integracje bazy wiedzy: architektura i testowanie
- Enterprise Knowledge Base for AI: Architecture Guide
- AI Support Knowledge Base That Updates Itself
- Build Secure Knowledge Base Integrations for AI Agents (DZone)
- Microsoft Copilot Connector Knowledge Onboarding Runbook
- AWS Prescriptive Guidance: Grounded agent AI workflow
- AWS Prescriptive Guidance: Grounding and Retrieval Augmented Generation
- AWS Machine Learning Blog: Ograniczanie halucynacji dzięki zweryfikowanej pamięci podręcznej semantycznej