Knowledge base-integratie betekent dat u uw documentatie koppelt aan de systemen waarin uw team en klanten al werken: CRM, supportdesk, chat, finance en product. Als het goed gebeurt, krijgen mensen het goedgekeurde antwoord in de tool die ze gebruiken, en halen AI-assistenten actuele informatie op in plaats van te gokken. Als het slecht gebeurt, kopieert u verouderde content naar nog meer plekken. Het verschil komt neer op drie beslissingen: welke bronnen leidend zijn, wie wat mag zien en hoe content actueel blijft.
Deze gids is geschreven voor oprichters, COO's en hoofden Finance, Sales en Customer Success bij B2B SaaS-bedrijven met ongeveer 20 tot 200 medewerkers. Hij behandelt wat u moet koppelen, hoe u uw bron van waarheid kiest, hoe automatisering werkt, hoe AI het resultaat veilig kan gebruiken en wat Europese regels betekenen voor het ontwerp.
Kort samengevat
- Een knowledge base-integratie brengt goedgekeurde antwoorden naar CRM-records, tickets, chat en AI-assistenten, zodat niemand van tool hoeft te wisselen of een tweede kopie hoeft bij te houden.
- Begin met een bronnenregister: bepaal welk systeem leidend is voor welk type vraag en sluit verouderde of dubbele content uit voordat u iets koppelt.
- Behandel rechten als data. Wat een gebruiker in het bronsysteem niet kan openen, mag de AI niet voor die gebruiker ophalen.
- Automatisering moet hiaten signaleren en updates opstellen. Een mens moet goedkeuren wat wordt gepubliceerd.
- Ontwerp onder de AVG en de EU AI Act vanaf dag één voor datalocatie, toegangsbeheer en audittrails, en vraag uw juridisch adviseur te bevestigen hoe ze op u van toepassing zijn.
Inhoudsopgave
- Wat knowledge base-integratie in de praktijk betekent
- Bepaal eerst uw bron van waarheid
- Integreren in stappen
- Waar automatisering van de knowledge base helpt
- AI de knowledge base veilig laten gebruiken
- Waar AI niet thuishoort
- AVG, NIS2 en de EU AI Act in het ontwerp
- Perspectief: waarom wij eerst de data op orde brengen
- Werk samen met NordOps Consulting
- Een checklist voordat u live gaat
- FAQ
- Bronnen
Wat knowledge base-integratie in de praktijk betekent
Een knowledge base op zich is een bibliotheek. Een integratie maakt er een dienst van. In plaats van mensen te vragen een helpcenter of wiki te bezoeken, verschijnt het juiste artikel of antwoord in een CRM-record, een supportticket, een livechat, Slack of Microsoft Teams, of een AI-chatbot. Een overzicht van integraties beschrijft dit als het brengen van relevante artikelen en documentatie naar de tools die klanten, medewerkers en teams al gebruiken.
Voor een SaaS-bedrijf is de opbrengst praktisch:
- Supportmedewerkers antwoorden sneller omdat het goedgekeurde artikel naast het ticket staat.
- Customer Success managers zien de juiste onboarding- of productbegeleiding bij het account waaraan ze werken.
- Sales haalt actuele product- en beveiligingsantwoorden in een deal binnen in plaats van een collega te vragen.
- Klanten vinden antwoorden in het product of in chat voordat ze een ticket openen.
- AI-assistenten halen goedgekeurde content op in plaats van die te verzinnen.
Let op wat er in dat lijstje ontbreekt: een nieuwe tool. De beste integraties voegen geen nieuwe plek toe om te zoeken. Ze halen er een weg.
Bepaal eerst uw bron van waarheid
De meeste mislukte integraties mislukken voordat er een connector is gebouwd. Het bedrijf heeft dezelfde prijsregel in een wikipagina, een CRM-veld, een presentatie en een supportmacro, en die vier spreken elkaar tegen. Koppel ze alle vier aan een AI-assistent en die citeert degene die het hoogst scoort.
Een knowledge base in productie put volgens een architectuurgids doorgaans uit zes soorten content: documentopslagplaatsen, ticketsystemen, codehosts, communicatiearchieven, gestructureerde registratiesystemen en externe gezaghebbende content. Voor een SaaS-bedrijf zijn de gestructureerde registratiesystemen het belangrijkst: uw CRM en uw financiële systeem bevatten de feiten die andere content slechts beschrijft.
Bouw een bronnenregister
Schrijf voordat u iets koppelt één regel per opslagplaats. Nuttige velden zijn:
- Eigenaar: een benoemde persoon, geen team.
- Doelgroep: alleen intern, voor klanten of voor partners.
- Dataclassificatie, inclusief of er persoonsgegevens in staan.
- Leidend voor welke vragen, en welke bronnen zwaarder wegen bij tegenstrijdigheid.
- Reviewdatum en bewaartermijn.
- Hoe verwijderingen de index bereiken.
Sluit vervolgens uit wat er niet in thuishoort: verouderde concepten, dubbele kopieën, persoonlijke notities en alles waarvan de eigenaar niet kan zeggen of het nog klopt.
Laat registratiesystemen winnen
Een eenvoudige regel werkt goed: als een feit in een gestructureerd systeem staat, wint het gestructureerde systeem. Contractwaarde, verlengingsdatum, abonnement, factuurstatus en gebruik horen thuis in de CRM- en financiële data. Artikelen leggen uit hoe u ze gebruikt of interpreteert. Ze herhalen ze nooit.
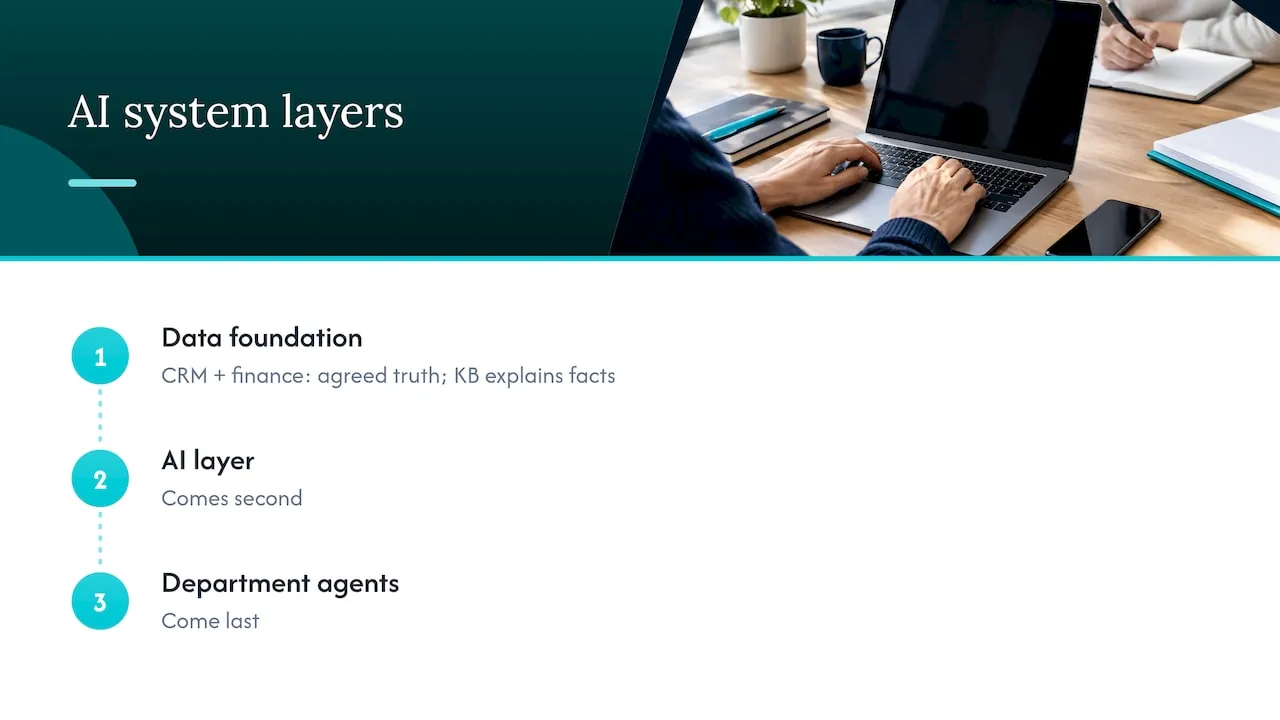
Dit is dezelfde volgorde die wij hanteren wanneer wij AI voor klanten bouwen. Eerst komt het datafundament: CRM- en financiële data als de ene afgestemde versie van de waarheid, voorbereid door de Processor. Daarna komt de AI-laag. Als laatste komen de afdelingsagents. Een kennisbank maakt deel uit van die structuur als verklarende laag boven betrouwbare data.
Integreren in stappen
Een praktische volgorde, gebaseerd op de lagen die de meeste productieomgevingen gemeen hebben: connectoren, transformatie, chunking en indexering, en daarna retrieval en generatie.
- Inventariseer en rangschik bronnen. Gebruik het register hierboven.
- Koppel met de smalst mogelijke toegang. Geef elke connector de kleinste rechten die nodig zijn. Alleen-lezen, tenzij een workflow echt terugschrijft.
- Opschonen en transformeren. Verwijder navigatieruis, normaliseer formaten, bewaar titels, eigenaren en datums als metadata.
- Chunk op betekenis. Splits content op natuurlijke grenzen, zoals een procedure of een beleidsclausule, niet op willekeurige tekenaantallen.
- Indexeer met metadata. Sla bron, tijdstempel, doelgroep en een prioriteitsvlag op, zodat retrieval gezaghebbende content kan voortrekken.
- Test retrieval vóór generatie. Stel 50 echte vragen uit uw support- en salesgeschiedenis en controleer of de juiste passage terugkomt. Voeg pas daarna een AI toe die antwoorden schrijft.
- Rol gefaseerd uit. Eerst een interne preview, dan een beperkte groep, daarna breder gebruik.
Neem actualiteit en rechten op in uw acceptatiecriteria, niet in een latere opschoning. “Het geeft het juiste antwoord” is niet genoeg. “Het geeft het juiste, actuele antwoord, en alleen aan mensen die het mogen zien” is de toets.
Verandermanagement is net zo belangrijk als connectoren. Mensen moeten weten waar antwoorden nu vandaan komen en wie een fout antwoord herstelt. Een training in teamwork en samenwerking kan teams helpen het eens te worden over eigenaarschap en content gesynchroniseerd te houden tussen afdelingen naarmate de opzet verandert.
Waar automatisering van de knowledge base helpt
Automatisering is waar een kennisbank ophoudt te verouderen. De meeste content raakt verouderd, niet omdat mensen lui zijn, maar omdat niemand wordt verteld wanneer het product is veranderd.
De gebruikelijke automatiseringstaken zijn:
- Opstellen van nieuwe artikelen uit opgeloste tickets, chattranscripten of release notes.
- Vastleggen van antwoorden die in Slack-threads of supportreacties verschijnen.
- Ordenen van content door die te taggen en bijna-duplicaten op te sporen.
- Aanbieden van artikelen in chat, in het product of via een AI-assistent.
- Verversen van content door artikelen te markeren die door een productwijziging zijn geraakt en wijzigingen op te stellen.
De belangrijke ontwerpkeuze is waar de mens zit. Een gids over zelfupdatende supportcontent maakt hetzelfde punt: het automatische deel is het opsporen van hiaten en het opstellen van wijzigingen, en een persoon beoordeelt voordat iets live gaat. Wij bouwen het op dezelfde manier. Het systeem stelt voor, een benoemde eigenaar keurt goed.
Nog een patroon dat het kennen waard is, is de lus die inzichten terugschrijft. Gesprekken worden vastgelegd, omgezet naar doorzoekbare vorm, gebruikt om vragen te beantwoorden, en de nieuwe kennis wordt teruggezet in het systeem van record. Die lus werkt alleen als het systeem van record vanaf het begin schoon is.
Voor een diepere blik op een proces waarbij dit loont, zie ons artikel over onboardingautomatisering voor B2B SaaS.
AI de knowledge base veilig laten gebruiken
Een AI-assistent die met uw kennisbank is verbonden, kan twee dingen doen: lezen en handelen. Beide vragen om vangrails.
Lezen: rechten volgen de gebruiker
De meest voorkomende ernstige fout is een assistent die een document toont dat de vragensteller nooit had mogen openen. De oplossing is rechten als data te behandelen. Een technische uiteenzetting over veilige integraties raadt aan dat een agent het rechtenmodel van het bronsysteem begrijpt en weergeeft voordat hij een pagina verwerkt, en dat retrieval documenten op het moment van de query filtert op de identiteit van de huidige gebruiker. Ook wordt aangeraden toegangslijsten even vaak te verversen als content, omdat een document dat vanochtend beperkt was, vanmiddag niet mag worden getoond.
Het gepubliceerde onboarding-runbook voor Copilot-connectoren van Microsoft geeft een concrete regel die het kopiëren waard is, welk platform u ook gebruikt: beperk toegang tot mensen die die al hebben in plaats van “Everyone”, en neem minstens één negatieve test op tegen uw meest gevoelige content, zoals beperkt HR-materiaal. Als die test content teruggeeft, stop dan de uitrol.
Handelen: gegrond, gelogd, begrensd
Wanneer een agent meer doet dan antwoorden, bijvoorbeeld een record bijwerken of een proces starten, is het patroon hetzelfde. AWS beschrijft een gegronde agent-workflow waarin de agent de intentie vaststelt, beleid opzoekt in de kennisbank, alleen een actie aanroept als het verzoek in aanmerking komt, en dit alles doet binnen vangrails en met logging. Hun richtlijnen over grounding en retrieval voegen governance-punten toe die op uw checklist thuishoren: kwaliteit van brondata, toegangscontrole op basis van identiteit en rol, versie- en actualiteitsbeleid, auditlogging en feedbacklussen voor correcties.
Ons eigen ontwerp volgt dezelfde vorm: agents werken binnen rechten, vragen om goedkeuring waar de actie ertoe doet en laten een audittrail achter.
Foute antwoorden verminderen
Voor vragen waarvoor u al een geverifieerd antwoord hebt, kunt u generatie helemaal overslaan. AWS beschrijft een geverifieerde semantische cache die direct een gecureerd antwoord teruggeeft wanneer een query sterk overeenkomt met een bekende vraag, en alleen voor queries met lage gelijkenis terugvalt op het model. Het principe geldt breed: waar een goedgekeurd antwoord bestaat, geef dat.
Waar AI niet thuishoort
Expliciet zijn over grenzen maakt een integratie veiliger en goedkoper.
- Prijzen, kortingen en contractvoorwaarden. Haal deze uit het CRM- of financiële record, of verwijs door naar een persoon. Laat een model ze niet parafraseren.
- Beslissingen die de rechten of het levensonderhoud van mensen raken, zoals werving of kredietbeoordeling. De EU AI Act beschouwt sommige systemen op deze gebieden als hoog risico, met strengere verplichtingen.
- Juridisch, fiscaal en medisch advies. Retrieval kan wijzen naar de goedgekeurde tekst. Het mag die niet interpreteren.
- Content zonder eigenaar. Als niemand voor een document kan instaan, hoort het niet in de index.
- Publiceren zonder review. AI kan opstellen. Een mens publiceert.
- Brede, onafgebakende toegang. Een assistent die alles kan zien, is een datalek dat wacht op de juiste vraag.
Voer één proces tegelijk in, te beginnen met het duurste. Supportdeflectie of securityvragenlijsten in sales zijn vaak goede eerste kandidaten, omdat het volume hoog is en de goedgekeurde antwoorden al bestaan.
AVG, NIS2 en de EU AI Act in het ontwerp
Als uw kennisbank persoonsgegevens bevat van mensen in de EU, moet het ontwerp vanaf het begin rekening houden met de Europese regels, en niet pas na de lancering. In grote lijnen:
- GDPR is van toepassing wanneer persoonsgegevens van mensen in de EU worden verwerkt. Dat omvat klantnamen, e-mailadressen en ticketinhoud in uw index. Denk na over waar gegevens worden opgeslagen en verwerkt, welke leveranciers als verwerker optreden en een verwerkersovereenkomst nodig hebben, hoe lang inhoud wordt bewaard en hoe u de gegevens van één persoon verwijdert uit zowel de bron als de index.
- Doelbinding is van belang zodra een leverancier betrokken is. Controleer dat inhoud die u voor zoekdoeleinden indexeert, niet opnieuw wordt gebruikt om de eigen modellen van een aanbieder te trainen.
- De EU AI Act legt verplichtingen op per risicocategorie. Veel toepassingen van een kennisbank, zoals het beantwoorden van productvragen, vallen in een lagere risicoklasse, maar de transparantieplichten en de categorieën met hoog risico verdienen nog steeds aandacht.
- NIS2 gaat over het beheer van cyberbeveiligingsrisico’s voor entiteiten die onder het toepassingsgebied vallen. Of uw bedrijf daaronder valt, is een vraag voor uw juridisch adviseur.
Deze kaders overlappen elkaar in de praktijk. Toegangsbeheer, logging en gedocumenteerde risicobeoordelingen dienen er meerdere tegelijk. Niets hiervan is juridisch advies, en geen enkele architectuur garandeert naleving. Laat uw juridisch adviseur of functionaris voor gegevensbescherming bevestigen wat voor u geldt. Ons AI-governanceraamwerk voor B2B SaaS behandelt de praktische kant.
Perspectief: waarom wij eerst de data op orde brengen
We krijgen vragen over kennisbanken wanneer er al iets is misgegaan: een assistent citeerde de prijzen van vorig jaar, een supportmedewerker plakte een antwoord dat het contract tegensprak, of iemand trof een intern document aan in een chatantwoord.
Vrijwel altijd was de kennisbank niet het probleem. Het probleem was dat niemand eigenaar was van de waarheid. Het CRM zei het ene, het financiële systeem het andere en de wiki weer iets anders. Een AI-assistent aan alle drie koppelen maakte de tegenstrijdigheid alleen sneller zichtbaar.
Daarom werken we in een vaste volgorde. Eerst het datafundament: CRM- en financiële data omgezet in één afgesproken versie van de waarheid. Dan de AI-laag, die die data koppelt aan de assistent die uw bedrijf al gebruikt. Daarna afdelingsagenten voor Finance, Sales en Customer Success die uw eigen mensen in gewone taal gebruiken, binnen hun rechten, met goedkeuring waar het ertoe doet en met een audittrail.
We zeggen ook waar AI buiten moet blijven: contractvoorwaarden, beslissingen over mensen en alle inhoud zonder eigenaar. Een kennisbank is nuttig wanneer hij smal, actueel en voorzien van rechten is. Hij is een risico wanneer hij groot is en geen eigenaar heeft.
Het bedrijf behoudt wat wij bouwen: broncode, documentatie en infrastructuur worden bij oplevering overgedragen, en bouw, pilot en tests draaien op zelfgehoste Europese infrastructuur in Duitsland.
Claus Nielsen
Werk samen met NordOps Consulting
Als uw team al AI gebruikt maar niemand er eigenaar van is, is de eerste stap meestal een helder beeld van uw data en van waar AI loont. Onze AI Readiness Assessment start vanaf €4,500 en kijkt naar uw datafundament, uw processen en uw regelgevende positie. Voor doorlopend eigenaarschap start het abonnement voor de Fractional Chief AI Officer vanaf €1,500 per maand in het niveau Advisor, vanaf €3,250 in het niveau Operating en vanaf €5,500 in het niveau Embedded.
Bouwtrajecten worden geprijsd op 30% van de besparing in het eerste jaar, zodra die is gemeten en bewezen, of tegen een vaste prijs die vóór de start van het werk is afgesproken. De volledige lijst vindt u op de prijspagina, of u begint met een gratis kennismakingsgesprek van 30 minuten. Onze AI-agenten voor Finance, Sales en Customer Success laten zien hoe de afdelingslaag eruitziet zodra de data op orde is.
Een checklist voordat u live gaat
- Elke bron heeft een benoemde eigenaar, een doelgroep en een controledatum.
- Per vraagtype is één bron als gezaghebbend aangemerkt.
- Connectoren gebruiken standaard de smalste scopes en alleen-lezen toegang.
- Rechten worden even vaak gesynchroniseerd als inhoud, en verwijderingen bereiken de index.
- Een negatieve test op uw meest gevoelige inhoud slaagt.
- Retrieval wordt getest op echte vragen voordat een model antwoorden schrijft.
- AI schrijft concepten, mensen publiceren.
- Acties worden gelogd en vereisen goedkeuring waar de inzet hoog is.
- Gegevenslocatie, verwerkers en bewaartermijnen zijn gedocumenteerd en beoordeeld door uw juridisch adviseur.
- Iemand is na de lancering eigenaar.
FAQ
Wat is het doel van een integratie van een kennisbank?
Ze brengt goedgekeurde antwoorden naar de tools die mensen al gebruiken, zoals CRM, supportdesk, chat en AI-assistenten. Dat bespaart tijd die verloren gaat aan wisselen tussen tools en voorkomt dat dubbele kopieën moeten worden bijgehouden. Ook krijgt AI daarmee een gecontroleerde bron om uit op te halen.
Waarmee kan een kennisbank worden gekoppeld?
Gangbare bronnen zijn documentopslag, ticketsystemen, communicatietools, codeplatforms en gestructureerde registratiesystemen zoals CRM en finance. Voor SaaS-bedrijven zouden de registratiesystemen leidend moeten zijn voor feiten als abonnement, prijs en verlengingsdatum. Artikelen leggen uit, en registraties stellen vast.
Kunnen updates van de kennisbank volledig worden geautomatiseerd?
Opsporen en opstellen kunnen worden geautomatiseerd: hiaten signaleren, nieuwe artikelen voorstellen en verouderde artikelen markeren. Publiceren moet bij een benoemde beoordelaar blijven, zeker voor alles wat klantgericht is of wat een AI zal citeren.
Hoe voorkomen we dat een AI-assistent beperkte documenten prijsgeeft?
Neem de rechten van het bronsysteem over in de index en filter resultaten op de identiteit van de persoon die de vraag stelt. Ververs rechten even vaak als inhoud en voer vóór de lancering een negatieve test uit op uw gevoeligste materiaal.
Is hiervoor in Europa een juridische toetsing nodig?
Ja, in de praktijk wel. GDPR, NIS2 en de EU AI Act kunnen elk van toepassing zijn, afhankelijk van uw data en uw toepassing. Een juridisch adviseur of functionaris voor gegevensbescherming moet bevestigen wat voor u geldt.
Bronnen
- Integraties van kennisbanken: architectuur en testen
- Enterprise Knowledge Base for AI: Architecture Guide
- AI Support Knowledge Base That Updates Itself
- Build Secure Knowledge Base Integrations for AI Agents (DZone)
- Microsoft Copilot Connector Knowledge Onboarding Runbook
- AWS Prescriptive Guidance: Grounded agent AI workflow
- AWS Prescriptive Guidance: Grounding and Retrieval Augmented Generation
- AWS Machine Learning Blog: Hallucinaties verminderen met een geverifieerde semantische cache