Un entrepôt de données opérationnel rassemble en un seul endroit les données actuelles de vos systèmes métier, comme le CRM, la facturation et le support, afin que les équipes puissent analyser ce qui se passe maintenant, et non le mois dernier. Pour une entreprise SaaS B2B de 20 à 200 personnes, la question n’est que rarement de savoir quel produit d’entrepôt acheter. Il s’agit de savoir quelles données doivent être fraîches, à quel point, et qui est responsable de la version unique et convenue de ces données. Si vous y parvenez, le reporting fonctionne. C’est aussi l’étape qui détermine si l’IA donne à vos équipes des réponses auxquelles elles peuvent se fier.
En bref
- Un entrepôt de données opérationnel (ou operational data store, ODS) conserve les données actuelles de plusieurs systèmes pour le reporting quotidien. Un entrepôt classique conserve un historique consolidé pour l’analyse.
- « Quasi temps réel » signifie généralement des minutes, pas des millisecondes. Les tableaux de bord destinés aux humains en demandent rarement plus, et aller plus vite coûte plus cher à exploiter.
- Choisissez la fraîcheur selon l’usage : une revue financière, une prévision commerciale et une action automatisée n’ont pas les mêmes besoins.
- Se mettre d’accord sur une version unique des données CRM et financières compte plus que les outils. Les agents IA lisent cette version : les erreurs qui s’y trouvent deviennent des réponses fausses.
- La sécurité, la journalisation et les règles d’accès s’appliquent à la copie de vos données opérationnelles exactement comme à l’original. Cela inclut les obligations du RGPD.
Sommaire
- Ce qu’est un entrepôt de données opérationnel
- Base de données opérationnelle, ODS, entrepôt de données : les différences
- Comment fonctionne l’architecture de reporting opérationnel
- Ce que signifie « quasi temps réel » en chiffres
- Quand vous en avez besoin, et quand ce n’est pas le cas
- Les arbitrages qui déterminent la conception
- Pourquoi le socle de données passe avant l’IA
- Là où l'IA n'a pas sa place
- Où résident les données
- Comment nous pouvons vous aider
- FAQ
- Sources
Ce qu’est un entrepôt de données opérationnel
Le terme est employé de façon souple. En pratique, il désigne un référentiel qui centralise les données opérationnelles actuelles de systèmes tels que le CRM, la comptabilité et les ventes, ainsi que des flux externes, afin que vous puissiez produire des rapports sans interroger chaque système séparément.
Pour une entreprise SaaS, les sources sont bien connues :
- CRM : comptes, contacts, pipeline, renouvellements.
- Finance : factures, paiements, abonnements, échéanciers de revenus.
- Produit : usage, licences, adoption des fonctionnalités.
- Support : tickets, escalades, signaux de santé du compte.
La valeur ne réside pas dans le stockage. Elle tient au fait qu’une question comme « quels comptes en renouvellement ce trimestre ont des escalades ouvertes et des factures impayées ? » obtient une seule réponse, et non trois feuilles de calcul qui se contredisent.
Base de données opérationnelle, ODS, entrepôt de données : les différences
Quatre termes sont souvent confondus. Voici comment les distinguer.
| Base de données opérationnelle | Operational data store (ODS) | Entrepôt de données | |
|---|---|---|---|
| Objectif | Fait tourner un système transactionnel, comme votre CRM ou votre outil de facturation | Données actuelles et détaillées issues de plusieurs systèmes, pour le reporting opérationnel | Historique consolidé et nettoyé pour l’analyse |
| Fraîcheur | En production | De quelques secondes à quelques minutes ou heures | De quelques heures à quelques jours |
| Historique | Ce que l’application conserve | Court : données actuelles ou récentes | Long : de plusieurs mois à plusieurs années |
| Question type | « Mettre à jour cet enregistrement » | « Qu’est-ce qui est ouvert aujourd’hui ? » | « Comment le churn a-t-il évolué sur trois ans ? » |
Les distinctions suivent des descriptions publiées : une base de données opérationnelle est intégrée à un système transactionnel, un ODS récupère des données de transaction détaillées auprès de plusieurs systèmes avec des mises à jour fréquentes, et un entrepôt de données est une archive à long terme plus statique. Un ODS se situe entre les systèmes transactionnels et l’entrepôt analytique, et contient des données actuelles ou récentes actualisées toutes les quelques minutes à quelques heures, pour répondre à des questions comme les ventes du jour ou les tickets de support actifs.
Les latences typiques vont de quelques secondes à quelques minutes, avec une conservation de quelques jours à quelques semaines pour un ODS, contre des heures à des jours, avec des mois à des années de conservation, pour un entrepôt de données. Un ODS reprend généralement la structure des systèmes sources et convient à un reporting opérationnel léger, tandis qu’un entrepôt de données applique des transformations plus poussées et conserve un historique volumineux.
Les entrepôts cloud modernes brouillent la frontière. Ils peuvent offrir une disponibilité des données en temps réel et rendre inutile un ODS distinct. Il vaut donc mieux lire « entrepôt de données opérationnel » comme la description d’une fonction, et non d’un produit : des données actuelles et intégrées, suffisamment fiables pour piloter l’entreprise.
Comment fonctionne l’architecture de reporting opérationnel
Quels que soient les outils, l’architecture comporte les mêmes couches.
- Sources. CRM, facturation, base de données produit, outil de support.
- Ingestion. Les données quittent les sources. La capture des données de changement (CDC) n’envoie que les insertions, mises à jour et suppressions, ce qui réduit le volume transféré ainsi que la charge sur le réseau et les systèmes sources.
- Traitement. Les données sont nettoyées, rapprochées entre les systèmes (un client, un identifiant) et mises en forme selon des définitions convenues.
- Exposition. Un espace de stockage qui répond rapidement aux requêtes des personnes et des outils qui l’utilisent.
- Consommation. Tableaux de bord, rapports, alertes et assistants IA.
Un schéma en couches courant consiste en un ODS contenant des données brutes quasi temps réel pour les rapports opérationnels, avec des couches en aval qui nettoient, agrègent et exposent les données. Une conception fréquente alimente des files d’attente à partir des bases transactionnelles, puis les couches de l’entrepôt, afin que le reporting ne ralentisse pas les systèmes dans lesquels travaille votre équipe. Cette séparation est la principale raison de ne pas brancher directement les tableaux de bord sur votre CRM ou votre base de facturation.
Si vos systèmes publient déjà les changements sous forme d’événements, le même flux peut s’appuyer dessus. Notre guide sur l’architecture pilotée par les événements explique son fonctionnement et son champ d’application.
Ce que signifie « quasi temps réel » en chiffres
La plupart des équipes qui demandent du temps réel ont besoin de quelque chose de plus modeste. Un cadre proposé par un praticien distingue des niveaux de fraîcheur : inférieur à la seconde, de quelques secondes à environ une minute, et de quelques minutes à une fois par jour. Un autre décrit le quasi temps réel comme environ une à 15 minutes, au moyen de micro-lots ou de CDC.
Deux exemples réels montrent ce qui est réalisable :
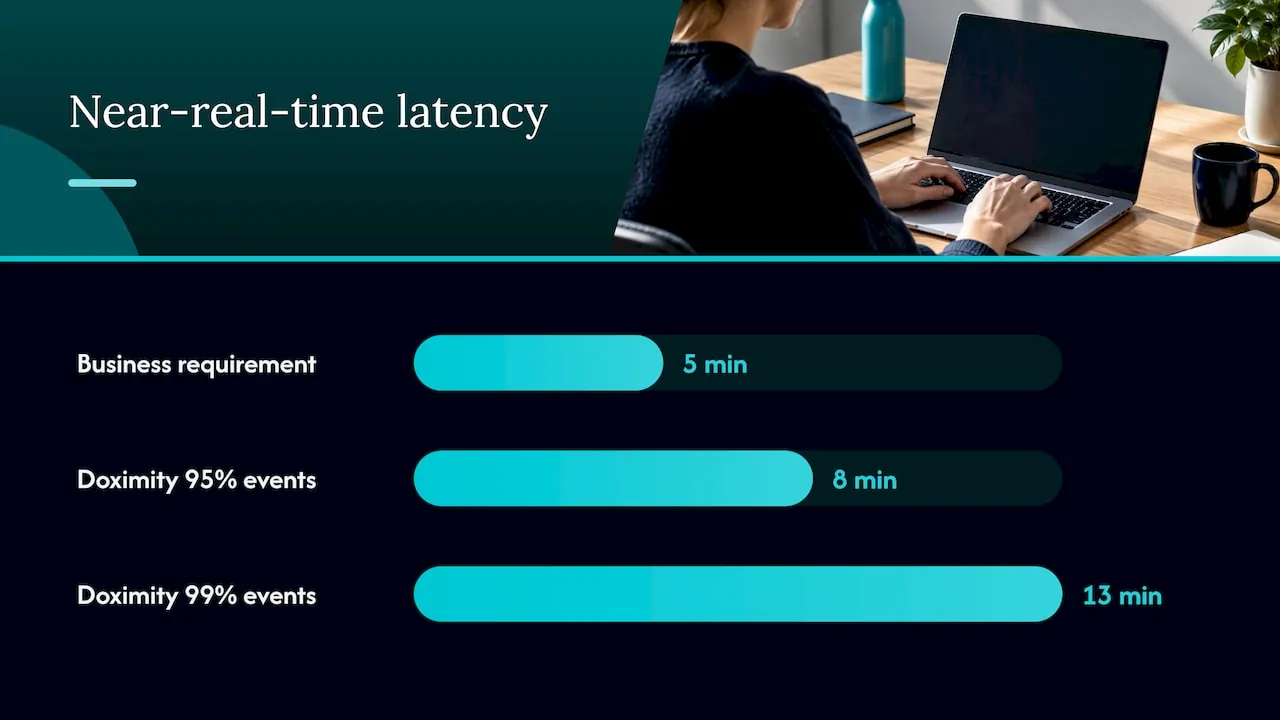
- Une équipe d’ingénieurs de Doximity a indiqué que son pipeline CDC rendait les changements interrogeables en quelques minutes. Sur un échantillon de 12 jours, 95 % des événements ont atteint la couche interrogeable en moins de huit minutes et 99 % en moins de 13 minutes.
- Un mémoire universitaire a mis en place un pipeline CDC avec une latence moyenne de bout en bout de 0.6 seconde pour environ 30,000 enregistrements par seconde, tout en notant que l’exigence de reporting métier était de cinq minutes.
Le second exemple est le plus utile. L’ingénierie peut dépasser largement l’exigence, et la vitesse supplémentaire n’apporte rien à l’entreprise.
Il existe aussi une différence entre agir sur des données en mouvement et interroger des données arrivées récemment. Les actions automatisées de détection de fraude ou de tarification peuvent exiger la première, alors que les tableaux de bord consultés par des humains n’ont généralement besoin que de données récentes. Un responsable commercial qui examine le pipeline ou un responsable financier qui vérifie les encaissements consulte un tableau de bord humain.
Quand vous en avez besoin, et quand ce n’est pas le cas
Les décisions opérationnelles sensibles au temps en sont le cas d’usage. Une étude sur les entrepôts de données opérationnels cite les stocks, les effectifs, les prévisions de demande et les tableaux de bord de performance comme exemples reposant sur des données infrajournalières ou horaires. Parmi les usages courants du reporting figurent les tableaux de bord de ventes en direct, l’exécution des commandes, les vues client unifiées et la supervision.
Une couche d’exposition opérationnelle dédiée est justifiée lorsque le délai d’actualisation de l’entrepôt est trop long pour des tableaux de bord en direct, des contrôles anti-fraude ou le contexte d’une IA, et inutile lorsque tous les utilisateurs sont des analystes pour qui des heures ou des jours sont acceptables.
Pour une entreprise SaaS de 20 à 200 personnes, une règle applicable :
- Reporting de gestion hebdomadaire ou mensuel : une actualisation quotidienne vers un espace de stockage consolidé suffit.
- Gestion de comptes, renouvellements, recouvrement : une fraîcheur horaire ou de l’ordre de la minute entre le CRM, la finance et le support est là où se trouve la valeur.
- Actions automatisées qui modifient des enregistrements ou déclenchent des processus : fraîcheur, ainsi que permissions et validation, abordées ci-dessous.
- Streaming inférieur à la seconde : rarement justifié à votre taille.
Les arbitrages qui déterminent la conception
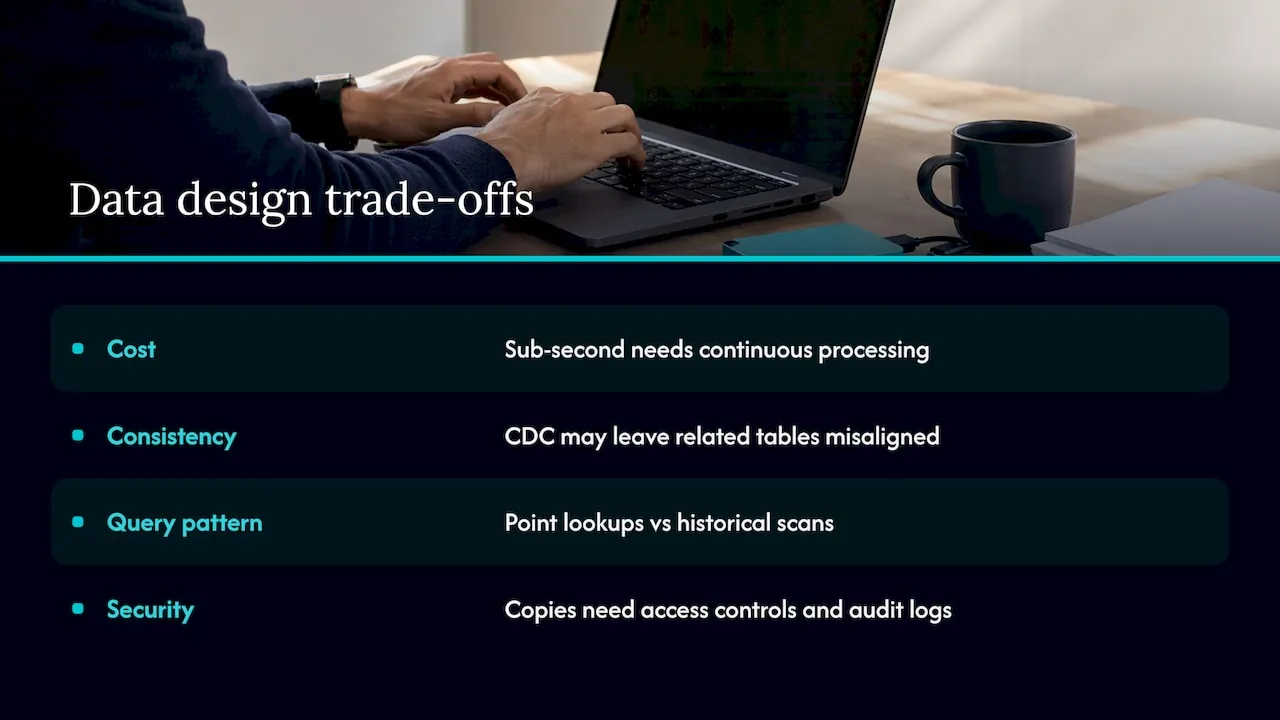
Le coût suit la latence. Une fraîcheur inférieure à la seconde exige une ingestion, un traitement et une exposition à faible latence qui fonctionnent en continu, alors que le traitement par lots peut s’arrêter lorsqu’il est inactif. Le streaming demande aussi des compétences en gestion des changements de schéma, surveillance du retard, données tardives et reprise. Le conseil est de choisir la pile la plus légère qui répond à l’exigence de l’utilisateur, et de formaliser cette exigence par écrit avant de construire.
Frais ne veut pas dire cohérent. La CDC peut rendre chaque table plus fraîche sans garantir que les tables liées reflètent exactement le même instant. Le total d’une facture et un enregistrement d’abonnement peuvent brièvement diverger. Décidez quels rapports exigent un instantané cohérent et lesquels peuvent accepter un léger décalage.
Les schémas de requête diffèrent. Une couche de streaming précalcule de petits jeux de résultats pour des recherches ponctuelles, alors qu’un entrepôt de données parcourt l’historique pour des analyses ad hoc. Leurs coûts dépendent de facteurs différents, c’est donc le mode d’accès qui doit guider le choix.
La sécurité suit les données. Une copie répliquée n’est pas une copie informelle. Les contrôles recommandés comprennent l’accès par rôle, table, colonne et ligne, le chiffrement au repos et en transit, la journalisation des accès et le suivi de la lignée des données. Si les données comprennent des données personnelles de clients de l’UE, le RGPD s’applique à la copie de la même manière. Votre délégué à la protection des données ou votre conseil juridique doit confirmer ce que cela implique pour votre configuration, car cet article ne constitue pas un avis juridique.
Pourquoi le socle de données passe avant l’IA
La plupart des équipes SaaS qui s’interrogent sur un entrepôt de données opérationnel ont un second motif : elles veulent que l’IA réponde à des questions sur l’entreprise. La question de l’entrepôt devient alors une question de qualité des données.
Un assistant IA qui lit deux systèmes avec deux définitions du « client actif » donne deux réponses assurées. La solution n’est pas un meilleur modèle. Il s’agit de convenir du système qui fait foi pour chaque information, généralement le CRM pour le client et la finance pour l’argent, et de nettoyer les données en conséquence. Nous abordons ce sujet dans CRM et data foundation avant les agents IA et dans notre guide de stratégie d’intégration des données pour les équipes SaaS.
Voici l’ordre dans lequel nous travaillons :
- Data foundation. Le CRM, les systèmes qui l’entourent et le Processor qui transforme les données en une version unique et convenue de la vérité. Le Processor est l’endroit où ce travail s’effectue.
- Couche IA. MCP relie ces données à l’assistant IA que votre entreprise utilise déjà.
- Agents par département. Des agents conçus pour la Finance, les Ventes et le Customer Success, que vos équipes utilisent en langage courant pour extraire des données (demander, produire un rapport, rechercher) et en envoyer (mettre à jour des enregistrements, déclencher des processus, provisionner des accès), dans le cadre des permissions, avec validation si nécessaire et une piste d’audit. Voir Agents IA pour la Finance, les Ventes et le Customer Success.
C’est côté finance que des données fraîches et intégrées portent leurs fruits en premier. Le recouvrement, les prévisions de trésorerie et le suivi budgétaire dépendent tous de la concordance entre les données de facturation, du CRM et de la banque. Pour des exemples concrets de tableaux de bord et de décisions financières, regardez comment les prévisions de flux de trésorerie et le reporting de performance dépendent de chiffres à jour.
Là où l'IA n'a pas sa place
Être explicite sur ce point permet d’économiser de l’argent.
- Quand les données ne font pas l'objet d'un accord. Si les équipes commerciales et la finance ne s'accordent pas sur le chiffre d'affaires, commencez par corriger les définitions. Superposer de l'IA ne fait que masquer le désaccord.
- Les décisions qui exigent une action en moins d'une seconde sur l'argent ou les accès sans validation ni piste d'audit. Gardez une personne dans la boucle.
- Le jugement juridique. L'IA peut préparer l'information. Elle ne décide pas de ce que le RGPD, NIS2 ou l'EU AI Act exigent de vous.
- Les processus peu coûteux qui fonctionnent déjà. L'IA s'adopte processus par processus, en commençant par le plus coûteux, pas par le plus à la mode.
NIS2 est la directive européenne sur la sécurité des réseaux et de l'information, et l'EU AI Act fixe des obligations selon le niveau de risque d'un système d'IA. Le mieux est de traiter les deux comme des exigences de conception dès le départ, avec journalisation, contrôle d'accès et documentation intégrés. Aucun outil ni aucune architecture ne garantit à lui seul la conformité.
Où résident les données
Pour les entreprises SaaS européennes, l'emplacement de la copie compte autant que sa structure. Lorsque nous construisons, pilotons et testons, nous utilisons une infrastructure européenne auto-hébergée en Allemagne, et ce que nous construisons vous est transféré : code source, documentation et infrastructure. Voir les logiciels opérationnels sur mesure, hébergés et détenus dans l'UE et pourquoi posséder vos systèmes opérationnels évite la dépendance vis-à-vis d'un fournisseur.
Notre point de vue
Un entrepôt de données est un moyen. L'objectif est que vos données CRM et financières concordent, que les personnes qui dirigent la Finance, les Ventes et le Customer Success puissent poser une question en langage courant et obtenir une réponse fiable, et que quelqu'un soit responsable du résultat.
C'est pourquoi nous construisons dans un ordre précis : d'abord la fondation de données, puis la couche d'IA qui la lit, puis les agents par département. Inversez l'ordre et vous obtenez des réponses rapides sur des données qui ne font l'objet d'aucun accord. Une fraîcheur différente selon les consommateurs est une décision de conception, et elle doit être prise par une seule personne qui comprend à la fois la stratégie et le système, ce qui est le rôle d'un Chief AI Officer à temps partagé doté d'une expérience opérationnelle.
Nous commençons par le processus le plus coûteux, nous le mesurons, et nous ne construisons que là où l'IA est rentable.
Claus Nielsen
Comment nous pouvons vous aider
Si l'IA est déjà utilisée dans votre entreprise mais que personne n'en est responsable, commencez par une vue de ce qui est rentable et de ce que vos données permettent de soutenir. L'AI Readiness Assessment démarre à partir de €4,500, en paiement unique. Si vous souhaitez qu'une personne désignée soit responsable de l'IA dans la durée, le forfait Chief AI Officer à temps partagé démarre à partir de €3,000 par mois. Vous pouvez aussi réserver un appel de découverte gratuit de 30 minutes via notre site.
Les réalisations sont facturées soit à hauteur de 30% de l'économie de la première année, une fois mesurée et prouvée, soit à un prix fixe convenu avant le début des travaux. Voir les tarifs pour plus de détails.
FAQ
Un entrepôt de données opérationnel est-il la même chose qu'un operational data store ?
Pas exactement, même si les termes se recoupent. Un ODS contient des données détaillées et actuelles issues de plusieurs systèmes pour le reporting opérationnel. Un entrepôt conserve un historique consolidé à des fins d'analyse. Certains entrepôts modernes assurent les deux fonctions, c'est pourquoi les équipes emploient souvent « entrepôt de données opérationnel » pour désigner un système unique qui fait les deux.
Quelle fraîcheur les données de reporting doivent-elles avoir ?
Adaptez-la à la personne ou au système qui les utilise. Les personnes qui consultent des tableaux de bord ont généralement besoin de données vieilles de quelques minutes à quelques heures. Seules les actions automatisées sur des données à évolution rapide ont tendance à exiger des secondes. Définissez l'exigence avant de choisir les outils, car chaque pas vers le temps réel augmente le coût d'exploitation et l'effort opérationnel.
Puis-je produire mes rapports directement depuis mon CRM ou mon système de facturation ?
Pour un seul système et une petite équipe, oui. Dès que vous combinez les données CRM, financières et produit, ou que des rapports lourds commencent à ralentir les systèmes dans lesquels les équipes travaillent, une couche distincte sépare le reporting des transactions quotidiennes et vous donne un jeu unique de définitions convenues.
Un operational data store me rend-il conforme au RGPD ?
Aucun outil n'y parvient à lui seul. Une copie de données personnelles reste une donnée personnelle : le contrôle d'accès, la journalisation et une base légale s'y appliquent donc. Parlez de votre configuration spécifique à votre délégué à la protection des données ou à votre conseil juridique.
Sources
- Présentation de l'operational data store
- Operational data store et entrepôt de données : comparaison
- Types et architectures d'entrepôts de données
- Operational data stores : finalité, avantages et cas d'usage
- Approche moderne de l'operational data store
- Conception de l'architecture des systèmes HTAP
- Comment concevoir une architecture d'analytique en temps réel
- Analytique en temps réel : quand en avez-vous besoin et quand non
- Des instantanés par lots aux données en quasi-temps réel
- Pipeline de données en quasi-temps réel avec capture des données modifiées
- Rapport TDWI sur l'entreposage de données opérationnel
- Couche de données opérationnelle et entrepôt de données
- Services de CFO à temps partagé et de reporting financier