Tietopankin integrointi tarkoittaa dokumentaation yhdistämistä järjestelmiin, joissa tiimisi ja asiakkaasi jo työskentelevät: CRM, asiakastuki, chat, talous ja tuote. Kun integrointi tehdään hyvin, ihmiset saavat hyväksytyn vastauksen suoraan käyttämäänsä työkaluun, ja tekoälyavustajat hakevat ajantasaista tietoa arvailun sijaan. Huonosti tehtynä vanhentunut sisältö vain kopioituu useampaan paikkaan. Ero ratkeaa kolmessa päätöksessä: mitkä lähteet ovat ensisijaisia, kuka saa nähdä mitä ja miten sisältö pysyy tuoreena.
Tämä opas on kirjoitettu perustajille, COO:ille sekä talouden, myynnin ja asiakasmenestyksen (Customer Success) johtajille B2B SaaS -yrityksissä, joissa on noin 20–200 työntekijää. Se käsittelee sitä, mitä kannattaa yhdistää, miten valitset ensisijaisen tietolähteen, miten automaatio toimii, miten tekoäly voi käyttää lopputulosta turvallisesti ja mitä eurooppalaiset säännöt tarkoittavat suunnittelun kannalta.
Tiivistelmä
- Tietopankin integrointi tuo hyväksytyt vastaukset CRM-tietueisiin, tiketteihin, chattiin ja tekoälyavustajiin, jolloin kenenkään ei tarvitse vaihtaa työkalua tai ylläpitää toista kopiota.
- Aloita lähderekisteristä: päätä, mikä järjestelmä on ensisijainen minkäkin tyyppisissä kysymyksissä, ja jätä vanhentunut tai päällekkäinen sisältö pois, ennen kuin yhdistät mitään.
- Käsittele käyttöoikeuksia datana. Mitä käyttäjä ei voi avata lähdejärjestelmässä, sitä tekoäly ei saa hakea hänelle.
- Automaation tulisi havaita aukot ja luonnostella päivityksiä. Ihmisen tulisi hyväksyä, mitä julkaistaan.
- GDPR:n ja EU:n tekoälyasetuksen (EU AI Act) osalta suunnittele tietojen sijainti, käyttöoikeuksien hallinta ja auditointijäljet alusta alkaen, ja pyydä oikeudellista neuvonantajaasi vahvistamaan, miten ne koskevat yritystäsi.
Sisällysluettelo
- Mitä tietopankin integrointi todella tarkoittaa
- Päätä ensin ensisijainen tietolähde
- Integrointi vaihe vaiheelta
- Missä tietopankin automaatio auttaa
- Tekoälyn turvallinen käyttö tietopankin kanssa
- Missä tekoäly ei kuulu
- GDPR, NIS2 ja EU AI Act suunnittelussa
- Näkökulma: miksi rakennamme datan ensin
- Tee yhteistyötä NordOps Consultingin kanssa
- Tarkistuslista ennen käyttöönottoa
- UKK
- Lähteet
Mitä tietopankin integrointi todella tarkoittaa
Pelkkä tietopankki on kirjasto. Integrointi tekee siitä palvelun. Sen sijaan, että ihmisiä pyydettäisiin käymään ohjekeskuksessa tai wikissä, oikea artikkeli tai vastaus ilmestyy CRM-tietueeseen, asiakastukitikettiin, live-chattiin, Slackiin tai Microsoft Teamsiin tai tekoälychatbotille. Yksi integraatiokatsaus kuvaa tätä niin, että olennaiset artikkelit ja dokumentaatio tuodaan työkaluihin, joita asiakkaat, tukihenkilöt ja tiimit jo käyttävät.
SaaS-yritykselle hyöty on käytännöllinen:
- Asiakastuen agentit vastaavat nopeammin, kun hyväksytty artikkeli on tiketin vieressä.
- Customer Success -managerit näkevät oikean käyttöönotto- tai tuoteohjeistuksen tilillä, jonka parissa he työskentelevät.
- Myynti saa ajantasaiset tuote- ja tietoturvavastaukset kauppaan ilman, että kollegalta tarvitsee kysyä.
- Asiakkaat löytävät vastaukset tuotteesta tai chatista ennen kuin avaavat tiketin.
- Tekoälyavustajat hakevat hyväksyttyä sisältöä sen sijaan, että keksisivät sitä.
Huomaa, mikä tästä luettelosta puuttuu: uusi työkalu. Parhaat integraatiot eivät lisää uutta paikkaa, josta katsoa. Ne poistavat yhden.
Päätä ensin ensisijainen tietolähde
Useimmat epäonnistuneet integraatiot epäonnistuvat jo ennen kuin yhtään liitintä on rakennettu. Yrityksellä on sama hinnoittelusääntö wiki-sivulla, CRM-kentässä, esityksessä ja asiakastuen makrossa, ja nämä neljä ovat keskenään ristiriidassa. Yhdistä kaikki neljä tekoälyavustajaan, ja se lainaa sitä, joka sijoittuu hakutuloksissa korkeimmalle.
Tuotantokäytössä oleva tietopankki hyödyntää tyypillisesti kuutta sisältöperhettä, kuten yksi arkkitehtuurioppaista toteaa: dokumenttitietovarastot, tikettijärjestelmät, koodin hostauspalvelut, viestintäarkistot, rakenteiset tietojärjestelmät (systems of record) ja ulkoinen auktoritatiivinen sisältö. SaaS-yrityksessä tärkeimpiä ovat rakenteiset tietojärjestelmät: CRM ja talousjärjestelmä sisältävät ne tosiasiat, joita muu sisältö vain kuvaa.
Rakenna lähderekisteri
Ennen kuin yhdistät mitään, kirjoita jokaisesta tietovarastosta yksi rivi. Hyödyllisiä kenttiä ovat:
- Omistaja, nimetty henkilö, ei tiimi.
- Kohderyhmä: vain sisäinen, asiakkaille tarkoitettu tai kumppaneille tarkoitettu.
- Tietoluokitus, mukaan lukien se, sisältääkö aineisto henkilötietoja.
- Ensisijainen mihin kysymyksiin, ja mitkä lähteet ohittavat sen ristiriitatilanteissa.
- Tarkistuspäivä ja säilytysaika.
- Miten poistot välittyvät hakemistoon.
Sulje sitten pois se, minkä ei pitäisi olla mukana: vanhentuneet luonnokset, kaksoiskappaleet, henkilökohtaiset muistiinpanot ja kaikki, minkä omistaja ei osaa sanoa olevan yhä oikein.
Anna tietojärjestelmien (systems of record) voittaa
Yksinkertainen sääntö toimii hyvin: jos tieto sijaitsee jäsennellyssä järjestelmässä, jäsennelty järjestelmä voittaa. Sopimuksen arvo, uusimispäivä, tilaus, laskun tila ja käyttö kuuluvat CRM- ja talousdataan. Artikkelit selittävät, miten niitä käytetään tai tulkitaan. Ne eivät koskaan toista niitä.
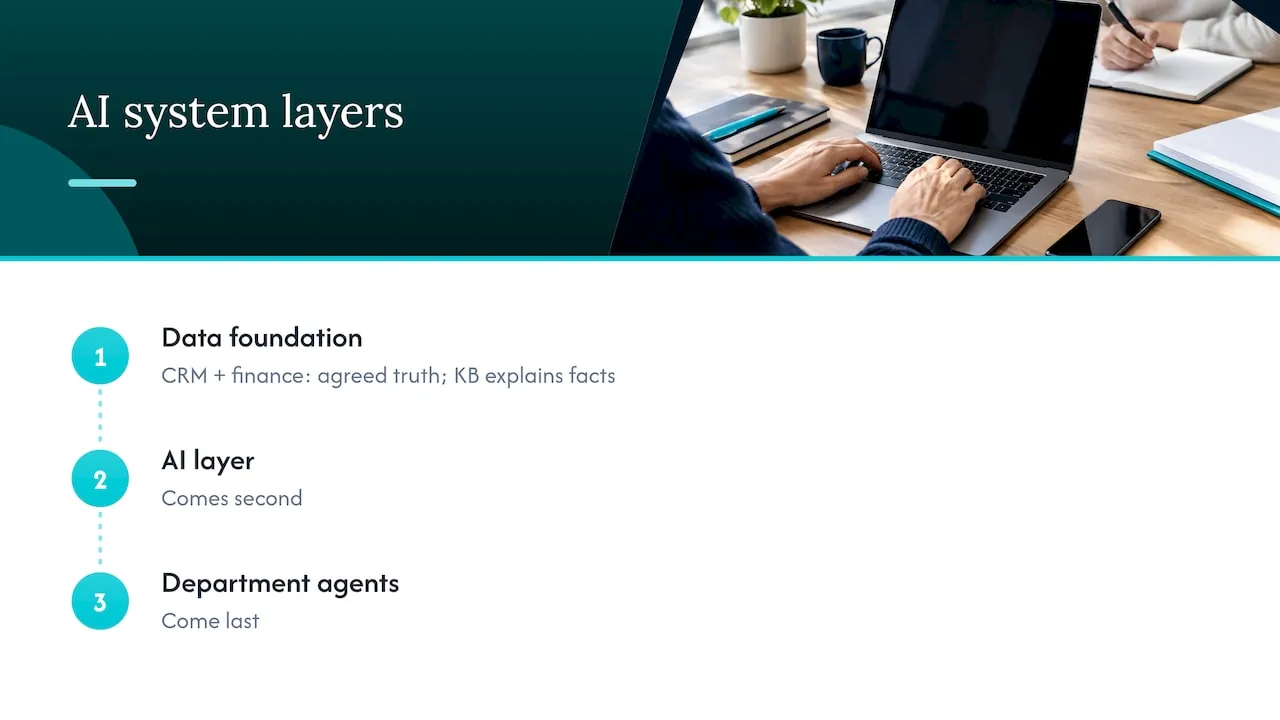
Samassa järjestyksessä rakennamme tekoälyä asiakkaillemme. Ensin tulee dataperusta: CRM- ja talousdata yhtenä yhteisesti sovittuna totuutena, jonka valmistelee Processor. Toisena tulee tekoälykerros. Viimeisenä tulevat osastokohtaiset agentit. Tietopankki sijoittuu tähän rakenteeseen selittäväksi kerrokseksi luotettavan datan päälle.
Integrointi vaihe vaiheelta
Käytännön eteneminen, joka perustuu kerroksiin, jotka useimmilla tuotantokäytössä olevilla toteutuksilla ovat yhteisiä: liittimet, muunnos, pilkkominen ja indeksointi, sitten haku ja generointi.
- Kartoita ja priorisoi lähteet. Käytä yllä olevaa rekisteriä.
- Yhdistä suppeimmilla mahdollisilla oikeuksilla. Anna jokaiselle liittimelle vain tarvitsemansa pienimmät oikeudet. Vain lukuoikeus, ellei työnkulku todella kirjoita takaisin.
- Puhdista ja muunna. Poista navigaatiosälä, yhdenmukaista muodot ja säilytä otsikot, omistajat ja päivämäärät metadatana.
- Pilko merkityksen mukaan. Jaa sisältö luonnollisista kohdista, kuten menettelystä tai käytännön lausekkeesta, älä mielivaltaisten merkkimäärien kohdalta.
- Indeksoi metadatan kanssa. Tallenna lähde, aikaleima, kohdeyleisö ja prioriteettilippu, jotta haku voi suosia auktoritatiivista sisältöä.
- Testaa haku ennen generointia. Esitä 50 todellista kysymystä tukenne ja myyntinne historiasta ja tarkista, palautuuko oikea kohta. Lisää vasta sitten tekoäly, joka kirjoittaa vastaukset.
- Ota käyttöön vaiheittain. Ensin sisäinen esikatselu, sitten rajattu ryhmä ja lopuksi laajempi käyttö.
Pidä tietojen ajantasaisuus ja käyttöoikeudet hyväksymiskriteereissä, älä myöhemmässä siivouksessa. “Se palauttaa oikean vastauksen” ei riitä. Testi on: “Se palauttaa oikean, ajantasaisen vastauksen, ja vain niille, joilla on oikeus nähdä se.”
Muutosjohtaminen on yhtä tärkeää kuin liittimet. Ihmisten on tiedettävä, mistä vastaukset nyt tulevat ja kuka korjaa väärän. Koulutus aiheesta tiimityö ja yhteistyö voi auttaa tiimejä sopimaan omistajuudesta ja pitämään sisällön synkronoituna osastojen välillä, kun toteutus muuttuu.
Missä tietopankin automaatio auttaa
Automaatio on se kohta, jossa tietopankki lakkaa rapistumasta. Suurin osa sisällöstä vanhenee, ei siksi että ihmiset olisivat laiskoja, vaan koska kukaan ei saa tietoa tuotteen muuttumisesta.
Yleisimmät automaatiotehtävät ovat:
- Luonnostelu: uusien artikkelien laatiminen ratkaistuista tiketeistä, chat-keskusteluista tai julkaisutiedotteista.
- Tallentaminen: Slack-keskusteluissa tai tukivastauksissa esiintyvien vastausten talteenotto.
- Järjestäminen: sisällön luokittelu tunnisteilla ja lähes päällekkäisten kohteiden havaitseminen.
- Tarjoaminen: artikkelien välittäminen chatissa, tuotteessa tai tekoälyavustajan kautta.
- Päivittäminen: tuotemuutoksen koskettamien artikkelien merkitseminen ja muutosehdotusten luonnostelu.
Tärkeä suunnitteluvalinta on, missä kohdassa ihminen on mukana. Itsestään päivittyvää tukisisältöä käsittelevä opas esittää saman asian: automaattista on aukkojen havaitseminen ja muutosten luonnostelu, ja ihminen tarkistaa ennen kuin mikään julkaistaan. Rakennamme sen samalla tavalla. Järjestelmä ehdottaa, nimetty omistaja hyväksyy.
Yksi tunnettava toimintamalli on silmukka, joka kirjoittaa oivallukset takaisin. Keskustelut tallennetaan, muunnetaan haettavaan muotoon, käytetään kysymyksiin vastaamiseen, ja uusi tieto viedään takaisin ensisijaiseen tietojärjestelmään. Silmukka toimii vain, jos ensisijainen tietojärjestelmä on alun perin puhdas.
Jos haluat tarkemmin tutustua yhteen prosessiin, jossa tämä tuottaa tulosta, lue artikkelimme B2B SaaS -yritysten käyttöönoton automaatiosta.
Tekoälyn turvallinen käyttö tietopankin kanssa
Tietopankkiinne yhdistetty tekoälyavustaja voi tehdä kaksi asiaa: lukea ja toimia. Molemmat tarvitsevat suojakaiteet.
Lukeminen: käyttöoikeudet seuraavat käyttäjää
Yleisin vakava virhe on avustaja, joka nostaa esiin dokumentin, jota kysyjällä ei ole koskaan ollut oikeutta avata. Ratkaisu on kohdella käyttöoikeuksia datana. Eräässä suojattuja integraatioita käsittelevässä tekniikkakirjoituksessa suositellaan, että agentti ymmärtää ja esittää lähdejärjestelmän käyttöoikeusmallin ennen minkään sivun käsittelyä ja että haku suodattaa dokumentit kyselyhetkellä nykyisen käyttäjän identiteetin perusteella. Siinä neuvotaan myös päivittämään käyttöoikeuslistat yhtä usein kuin sisältö, sillä aamulla rajoitettua dokumenttia ei pidä tarjota iltapäivällä.
Microsoftin julkaisema Copilot-liittimien käyttöönoton ohjekirja antaa konkreettisen säännön, jonka kannattaa kopioida alustasta riippumatta: rajaa pääsy niihin, joilla se jo on, älä “kaikille”, ja sisällytä vähintään yksi negatiivinen testi arkaluonteisinta sisältöänne vastaan, kuten rajoitettua HR-aineistoa. Jos testi palauttaa sisältöä, keskeytä käyttöönotto.
Toimiminen: perusteltu, kirjattu, rajattu
Kun agentti tekee muutakin kuin vastaa, esimerkiksi päivittää tietueen tai käynnistää prosessin, toimintamalli on sama. AWS kuvaa perustellun agentin työnkulun, jossa agentti selvittää aikomuksen, hakee käytännön tietopankista, kutsuu toimintoa vain jos pyyntö on oikeutettu, ja tekee tämän kaiken suojakaiteiden sisällä ja kirjausta pitäen. Heidän ohjeensa perustamisesta ja hausta lisää hallintakohtia, jotka kannattaa ottaa tarkistuslistalle: lähdedatan laatu, pääsynhallinta identiteetin ja roolin mukaan, versiointi- ja ajantasaisuuskäytännöt, auditointilokit ja palautesilmukat korjauksia varten.
Oma suunnittelumme noudattaa samaa muotoa: agentit toimivat käyttöoikeuksiensa puitteissa, pyytävät hyväksyntää silloin kun toiminnolla on merkitystä ja jättävät jälkeensä auditointijäljen.
Väärien vastausten vähentäminen
Kysymyksissä, joihin teillä on jo varmennettu vastaus, generoinnin voi jättää kokonaan pois. AWS kuvaa varmennetun semanttisen välimuistin, joka palauttaa kuratoidun vastauksen suoraan, kun kysely vastaa läheisesti tunnettua kysymystä, ja turvautuu malliin vain heikosti vastaavien kyselyjen kohdalla. Periaate pätee laajasti: kun hyväksytty vastaus on olemassa, tarjoa se.
Missä tekoäly ei kuulu
Rajojen selkeä määrittely tekee integraatiosta turvallisemman ja edullisemman.
- Hinnoittelu, alennukset ja sopimusehdot. Tarjoa nämä CRM- tai talousjärjestelmän tietueesta tai ohjaa ihmiselle. Älä anna mallin parafraasata niitä.
- Päätökset, jotka vaikuttavat ihmisten oikeuksiin tai toimeentuloon, kuten rekrytointi tai luottokelpoisuuden arviointi. EU:n tekoälysäädös (EU AI Act) luokittelee joitakin näiden alojen järjestelmiä korkean riskin järjestelmiksi, joihin kohdistuu tiukempia velvoitteita.
- Oikeudellinen, verotuksellinen ja lääketieteellinen neuvonta. Haku voi osoittaa hyväksytyn tekstin. Sen ei pidä tulkita sitä.
- Sisältö, jolla ei ole omistajaa. Jos kukaan ei voi taata dokumentin oikeellisuutta, se ei kuulu indeksiin.
- Tarkistamaton julkaiseminen. Tekoäly voi luonnostella. Ihminen julkaisee.
- Laaja, rajaamaton pääsy. Avustaja, joka näkee kaiken, on tietomurto, joka odottaa oikeaa kysymystä.
Ota käyttöön yksi prosessi kerrallaan ja aloita kalleimmasta. Tukikyselyjen ohjaaminen pois tuesta tai myynnin turvallisuuskyselyt ovat usein hyviä ensimmäisiä kohteita, koska määrät ovat suuria ja hyväksytyt vastaukset ovat jo olemassa.
GDPR, NIS2 ja EU AI Act suunnittelussa
Jos tietämyskantanne sisältää EU:ssa olevien henkilöiden henkilötietoja, suunnittelussa tulee huomioida eurooppalaiset säännöt alusta alkaen eikä vasta käyttöönoton jälkeen. Yleisellä tasolla:
- GDPR soveltuu, kun käsitellään EU:ssa olevien henkilöiden henkilötietoja. Tämä kattaa indeksissänne olevat asiakkaiden nimet, sähköpostiosoitteet ja tukipyyntöjen sisällön. Pohtikaa, missä tietoja tallennetaan ja käsitellään, mitkä palveluntarjoajat toimivat henkilötietojen käsittelijöinä ja tarvitsevat tietojenkäsittelysopimuksen, kuinka kauan sisältöä säilytetään ja miten yhden henkilön tiedot poistetaan sekä lähteestä että indeksistä.
- Käyttötarkoitussidonnaisuus on tärkeä, kun mukana on toimittaja. Varmistakaa, ettei hakua varten indeksoimaanne sisältöä käytetä palveluntarjoajan omien mallien kouluttamiseen.
- EU:n tekoälyasetus asettaa velvoitteita riskiluokittain. Monet tietämyskannan käyttötapaukset, kuten tuotekysymyksiin vastaaminen, kuuluvat matalampaan riskiluokkaan, mutta läpinäkyvyysvelvoitteet ja korkean riskin luokat on silti syytä tarkistaa.
- NIS2 koskee soveltamisalaan kuuluvien toimijoiden kyberturvallisuuden riskienhallintaa. Kuuluuko yrityksenne soveltamisalaan, on kysymys, joka kannattaa osoittaa lakineuvonantajallenne.
Nämä kehykset menevät käytännössä osittain päällekkäin. Pääsynhallinta, lokitus ja dokumentoidut riskiarvioinnit palvelevat useita niistä samanaikaisesti. Mikään tästä ei ole juridista neuvontaa, eikä mikään arkkitehtuuri takaa vaatimustenmukaisuutta. Pyytäkää lakimiestänne tai tietosuojavastaavaanne vahvistamaan, mitä teihin sovelletaan. B2B SaaS -yritysten tekoälyn hallintamallimme käsittelee käytännön puolta.
Näkökulma: miksi rakennamme datan ensin
Meiltä kysytään tietämyskannoista, kun jokin on jo mennyt pieleen: avustaja siteerasi viime vuoden hinnoittelua, tukihenkilö liitti vastauksen, joka oli ristiriidassa sopimuksen kanssa, tai joku löysi sisäisen dokumentin chat-vastauksesta.
Lähes aina tietämyskanta ei ollut ongelma. Ongelma oli se, ettei kukaan omistanut totuutta. CRM kertoi yhtä, talousjärjestelmä toista ja wiki kolmatta. Tekoälyavustajan yhdistäminen kaikkiin kolmeen vain nopeutti ristiriitaa.
Siksi työskentelemme kiinteässä järjestyksessä. Ensin datan perusta: CRM- ja talousdata muutetaan yhdeksi sovituksi totuudeksi. Sitten tekoälykerros, joka yhdistää datan avustajaan, jota yrityksenne jo käyttää. Sen jälkeen talouden, myynnin ja asiakkuuksien (Customer Success) osastoagentit, joita oman väkenne käyttää selkokielellä, käyttöoikeuksien puitteissa, hyväksyntämenettelyllä siellä missä sillä on merkitystä ja auditointijäljellä.
Kerromme myös, mistä tekoälyn tulee pysyä erossa: sopimusehdoista, ihmisiä koskevista päätöksistä ja kaikesta sisällöstä, jolla ei ole omistajaa. Tietämyskanta on hyödyllinen, kun se on rajattu, ajantasainen ja käyttöoikeuksilla hallittu. Se on riski, kun se on laaja ja vailla omistajaa.
Yritys pitää rakentamamme: lähdekoodi, dokumentaatio ja infrastruktuuri siirtyvät luovutuksessa, ja rakennus, pilotti ja testaus toimivat itse ylläpidetyllä eurooppalaisella infrastruktuurilla Saksassa.
Claus Nielsen
Tee yhteistyötä NordOps Consultingin kanssa
Jos tiiminne käyttää jo tekoälyä mutta kukaan ei omista sitä, ensimmäinen askel on yleensä selkeä kuva datastanne ja siitä, missä tekoäly tuottaa tulosta. AI Readiness Assessment alkaa hinnasta €4,500, ja siinä tarkastellaan datanne perustaa, prosessejanne ja sääntelyasemaanne. Jatkuvaan omistajuuteen tarkoitettu osa-aikainen Chief AI Officer -sopimus alkaa hinnasta €1,500 kuukaudessa Advisor-tasolla, €3,250 Operating-tasolla ja €5,500 Embedded-tasolla.
Toteutukset hinnoitellaan 30%:iin ensimmäisen vuoden säästöstä, kun se on mitattu ja todennettu, tai ennen työn alkua sovittuun kiinteään hintaan. Koko hinnaston näette hinnoittelusivulla, tai voitte aloittaa ilmaisella 30 minuutin tutustumiskeskustelulla. Tekoälyagenttimme taloudelle, myynnille ja asiakkuuksille näyttävät, millainen osastokerros on, kun data on kunnossa.
Tarkistuslista ennen käyttöönottoa
- Jokaisella lähteellä on nimetty omistaja, kohderyhmä ja tarkistuspäivä.
- Kunkin kysymystyypin kohdalla yksi lähde on merkitty ensisijaiseksi.
- Liittimet käyttävät suppeimpia mahdollisia oikeuksia ja oletuksena vain lukuoikeutta.
- Käyttöoikeudet synkronoidaan yhtä usein kuin sisältö, ja poistot välittyvät indeksiin.
- Arkaluonteisinta sisältöänne vastaan tehty negatiivinen testi läpäistään.
- Haku testataan oikeilla kysymyksillä ennen kuin mikään malli kirjoittaa vastauksia.
- Tekoäly luonnostelee, ihmiset julkaisevat.
- Toiminnot kirjataan lokiin, ja ne vaativat hyväksynnän siellä, missä panokset ovat korkeat.
- Datan sijainti, käsittelijät ja säilytysajat on dokumentoitu, ja lakineuvonantajanne on tarkistanut ne.
- Joku omistaa kokonaisuuden käyttöönoton jälkeen.
UKK
Mikä on tietämyskantaintegraation tarkoitus?
Se tuo hyväksytyt vastaukset työkaluihin, joita ihmiset jo käyttävät, kuten CRM:ään, tukipalvelun työkaluun, chattiin ja tekoälyavustajiin. Tämä säästää aikaa, kun työkalujen välillä ei tarvitse vaihdella, ja välttää päällekkäisten kopioiden ylläpidon. Se antaa tekoälylle myös hallitun lähteen, josta hakea tietoa.
Mihin tietämyskanta voi yhdistyä?
Yleisiä lähteitä ovat dokumenttivarastot, tukipyyntöjärjestelmät, viestintätyökalut, koodin isännöintipalvelut sekä jäsennellyt tietojärjestelmät, kuten CRM ja talous. SaaS-yrityksissä näiden tietojärjestelmien tulisi olla ensisijainen lähde esimerkiksi tilauspaketin, hinnan ja uusimispäivän kaltaisille tosiasioille. Artikkelit selittävät, ja tietueet toteavat.
Voiko tietämyskannan päivitykset automatisoida täysin?
Havaitseminen ja luonnostelu voidaan automatisoida: aukkojen tunnistaminen, uusien artikkelien ehdottaminen ja vanhentuneiden merkitseminen. Julkaisun tulee pysyä nimetyllä tarkistajalla, erityisesti kaiken asiakkaille näkyvän tai tekoälyn siteeraaman sisällön osalta.
Miten estämme tekoälyavustajaa paljastamasta rajoitettuja dokumentteja?
Siirtäkää lähdejärjestelmän käyttöoikeudet indeksiin ja suodattakaa tulokset kysyjän henkilöllisyyden mukaan. Päivittäkää käyttöoikeudet yhtä usein kuin sisältö ja tehkää negatiivinen testi arkaluonteisimmalle aineistollenne ennen käyttöönottoa.
Tarvitaanko tähän juridinen tarkastus Euroopassa?
Käytännössä kyllä. GDPR, NIS2 ja EU:n tekoälyasetus voivat kukin soveltua datanne ja käyttötapauksenne mukaan. Lakineuvonantajan tai tietosuojavastaavan tulisi vahvistaa, mitä teihin sovelletaan.
Lähteet
- Tietämyskantaintegraatiot: arkkitehtuuri ja testaus
- Enterprise Knowledge Base for AI: Architecture Guide
- AI Support Knowledge Base That Updates Itself
- Build Secure Knowledge Base Integrations for AI Agents (DZone)
- Microsoft Copilot Connector Knowledge Onboarding Runbook
- AWS Prescriptive Guidance: Grounded agent AI workflow
- AWS Prescriptive Guidance: Grounding and Retrieval Augmented Generation
- AWS Machine Learning Blog: Hallusinaatioiden vähentäminen varmennetun semanttisen välimuistin avulla