Integrar una base de conocimiento significa conectar su documentación con los sistemas en los que su equipo y sus clientes ya trabajan: CRM, servicio de soporte, chat, finanzas y producto. Bien hecho, las personas reciben la respuesta aprobada dentro de la herramienta que están usando, y los asistentes de IA recuperan información actual en lugar de adivinar. Mal hecho, se copia contenido obsoleto en más lugares. La diferencia se reduce a tres decisiones: qué fuentes son la referencia, quién puede ver qué y cómo se mantiene el contenido al día.
Esta guía está escrita para fundadores, COO y responsables de Finanzas, Ventas y Customer Success de empresas SaaS B2B de entre 20 y 200 personas, aproximadamente. Explica qué conectar, cómo elegir su fuente de verdad, cómo funciona la automatización, cómo puede la IA usar el resultado de forma segura y qué implican las normas europeas para el diseño.
Resumen
- Una integración de la base de conocimiento lleva las respuestas aprobadas a los registros del CRM, los tickets, el chat y los asistentes de IA, de modo que nadie tenga que cambiar de herramienta ni mantener una segunda copia.
- Empiece con un registro de fuentes: decida qué sistema es la referencia para cada tipo de pregunta y excluya el contenido obsoleto o duplicado antes de conectar nada.
- Trate los permisos como datos. Todo lo que un usuario no pueda abrir en el sistema de origen, la IA no debe recuperarlo para él.
- La automatización debe detectar lagunas y redactar actualizaciones. Una persona debe aprobar lo que se publica.
- Bajo el RGPD y la Ley de IA de la UE, diseñe desde el primer día pensando en la ubicación de los datos, el control de acceso y los registros de auditoría, y pida a su asesor jurídico que confirme cómo se aplican a su caso.
Índice
- Qué significa realmente integrar una base de conocimiento
- Decida primero su fuente de verdad
- Cómo integrar paso a paso
- Dónde ayuda la automatización de la base de conocimiento
- Cómo dejar que la IA use la base de conocimiento de forma segura
- Dónde no tiene cabida la IA
- El RGPD, la NIS2 y la Ley de IA de la UE en el diseño
- Perspectiva: por qué construimos primero los datos
- Trabaje con NordOps Consulting
- Una lista de comprobación antes de la puesta en marcha
- FAQ
- Fuentes
Qué significa realmente integrar una base de conocimiento
Una base de conocimiento por sí sola es una biblioteca. Una integración la convierte en un servicio. En lugar de pedir a las personas que visiten un centro de ayuda o un wiki, el artículo o la respuesta adecuados aparecen en un registro del CRM, un ticket de soporte, un chat en directo, Slack o Microsoft Teams, o un chatbot de IA. Una visión general de integraciones lo describe como llevar los artículos y la documentación relevantes a las herramientas que clientes, agentes y equipos ya utilizan.
Para una empresa SaaS, el beneficio es práctico:
- Los agentes de soporte responden más rápido porque el artículo aprobado está junto al ticket.
- Los responsables de Customer Success ven la guía de incorporación o de producto adecuada en la cuenta en la que están trabajando.
- Ventas incorpora a una oportunidad respuestas actuales sobre producto y seguridad en lugar de preguntar a un compañero.
- Los clientes encuentran respuestas en el producto o en el chat antes de abrir un ticket.
- Los asistentes de IA recuperan contenido aprobado en lugar de inventarlo.
Fíjese en lo que falta en esa lista: una herramienta nueva. Las mejores integraciones no añaden ningún lugar nuevo donde buscar. Eliminan uno.
Decida primero su fuente de verdad
La mayoría de las integraciones fallidas fallan antes de construir ningún conector. La empresa tiene la misma regla de precios en una página del wiki, un campo del CRM, una presentación y una macro de soporte, y las cuatro no coinciden. Conecte las cuatro a un asistente de IA y citará la que quede mejor posicionada.
Según una guía de arquitectura, una base de conocimiento en producción suele nutrirse de seis familias de contenido: repositorios de documentos, sistemas de tickets, repositorios de código, archivos de comunicación, sistemas de registro estructurados y contenido externo de referencia. Para una empresa SaaS, los sistemas de registro estructurados son los más importantes: su CRM y su sistema financiero contienen los hechos que el resto del contenido solo describe.
Elabore un registro de fuentes
Antes de conectar nada, escriba una línea por cada repositorio. Algunos campos útiles son:
- Responsable: una persona concreta, no un equipo.
- Audiencia: solo interna, orientada al cliente u orientada a partners.
- Clasificación de los datos, incluido si contienen datos personales.
- Referencia para qué preguntas, y qué fuentes prevalecen sobre ella cuando entran en conflicto.
- Fecha de revisión y plazo de conservación.
- Cómo llegan las eliminaciones al índice.
Después, excluya lo que no debería estar: borradores obsoletos, copias duplicadas, notas personales y todo aquello cuyo responsable no pueda decir si sigue siendo correcto.
Deje que los sistemas de registro prevalezcan
Una regla sencilla funciona bien: si un dato reside en un sistema estructurado, prevalece el sistema estructurado. El valor del contrato, la fecha de renovación, el plan, el estado de las facturas y el uso pertenecen al CRM y a los datos financieros. Los artículos explican cómo utilizarlos o interpretarlos. Nunca los repiten.
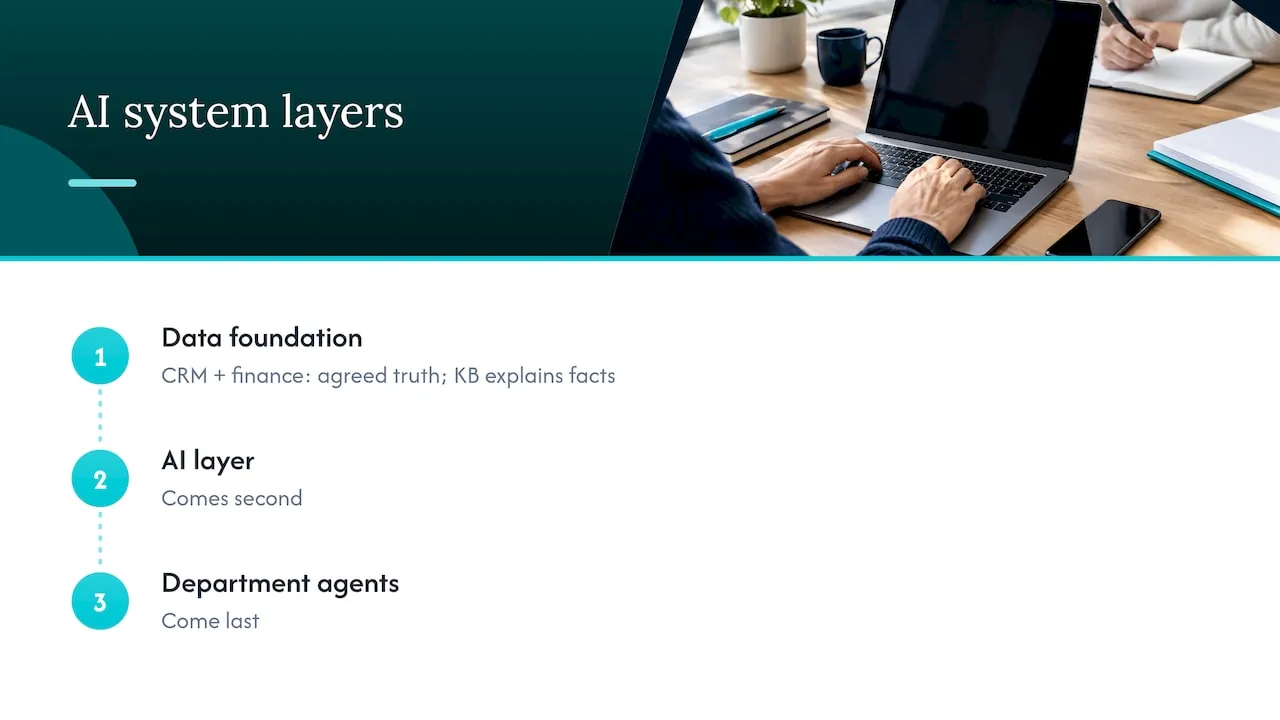
Es el mismo orden que seguimos cuando construimos IA para nuestros clientes. Primero, la base de datos: los datos del CRM y de finanzas como la única versión acordada de la verdad, preparados por el Processor. Después, la capa de IA. Por último, los agentes de departamento. Dentro de esa estructura, la base de conocimiento actúa como capa explicativa sobre datos fiables.
Cómo integrar paso a paso
Una secuencia práctica, basada en las capas que comparten la mayoría de las configuraciones en producción: conectores, transformación, fragmentación e indexación, y después recuperación y generación.
- Inventariar y priorizar las fuentes. Utilice el registro anterior.
- Conectar con el acceso más restringido. Dé a cada conector los permisos mínimos que necesite. Solo lectura, salvo que un flujo de trabajo realmente escriba de vuelta.
- Limpiar y transformar. Elimine el ruido de navegación, normalice los formatos y conserve títulos, responsables y fechas como metadatos.
- Fragmentar por significado. Divida el contenido en límites naturales, como un procedimiento o una cláusula de una política, no según un recuento arbitrario de caracteres.
- Indexar con metadatos. Almacene la fuente, la marca de tiempo, el público destinatario y un indicador de prioridad para que la recuperación pueda favorecer el contenido de referencia.
- Probar la recuperación antes de la generación. Formule 50 preguntas reales de su historial de soporte y ventas y compruebe si se recupera el pasaje correcto. Solo entonces añada una IA que redacte respuestas.
- Desplegar por fases. Primero una vista previa interna, luego un grupo limitado y después un uso más amplio.
Incluya la actualidad de los datos y los permisos en sus criterios de aceptación, no en una limpieza posterior. «Devuelve la respuesta correcta» no basta. La prueba es: «Devuelve la respuesta correcta y vigente, y solo a las personas autorizadas a verla».
La gestión del cambio importa tanto como los conectores. Las personas necesitan saber de dónde proceden ahora las respuestas y quién corrige una respuesta errónea. La formación en trabajo en equipo y colaboración puede ayudar a que los equipos acuerden las responsabilidades y mantengan el contenido sincronizado entre departamentos a medida que cambia la configuración.
Dónde ayuda la automatización de la base de conocimiento
La automatización es lo que impide que una base de conocimiento se deteriore. La mayor parte del contenido se queda obsoleto no porque las personas sean perezosas, sino porque nadie les avisa de que el producto ha cambiado.
Las tareas de automatización más habituales son:
- Redactar nuevos artículos a partir de tickets resueltos, transcripciones de chat o notas de versión.
- Capturar las respuestas que aparecen en hilos de Slack o en respuestas de soporte.
- Organizar el contenido etiquetándolo y detectando duplicados casi idénticos.
- Ofrecer artículos en el chat, en el producto o mediante un asistente de IA.
- Actualizar el contenido señalando los artículos afectados por un cambio de producto y redactando las modificaciones.
La decisión de diseño importante es dónde interviene la persona. Una guía sobre contenido de soporte que se actualiza solo subraya lo mismo: la parte automática consiste en detectar lagunas y redactar cambios, y una persona revisa antes de que nada se publique. Nosotros lo construimos de la misma manera. El sistema propone, un responsable designado aprueba.
Otro patrón que conviene conocer es el bucle que devuelve el conocimiento al sistema. Se capturan las conversaciones, se convierten a un formato en el que se pueda buscar, se usan para responder preguntas y el nuevo conocimiento se devuelve al sistema de registro. Ese bucle solo funciona si el sistema de registro está limpio desde el principio.
Para profundizar en un proceso en el que esto resulta rentable, consulte nuestro artículo sobre la automatización del onboarding en SaaS B2B.
Cómo dejar que la IA use la base de conocimiento de forma segura
Un asistente de IA conectado a su base de conocimiento puede hacer dos cosas: leer y actuar. Ambas requieren salvaguardas.
Leer: los permisos siguen al usuario
El fallo grave más común es un asistente que muestra un documento que la persona que pregunta nunca tuvo permiso para abrir. La solución es tratar los permisos como datos. Un artículo técnico sobre integraciones seguras recomienda que un agente comprenda y represente el modelo de permisos del sistema de origen antes de procesar cualquier página, y que la recuperación filtre los documentos en el momento de la consulta según la identidad del usuario actual. También aconseja actualizar las listas de acceso con la misma frecuencia que el contenido, ya que un documento restringido por la mañana no debería mostrarse por la tarde.
El runbook de incorporación para conectores de Copilot publicado por Microsoft ofrece una regla concreta que merece la pena copiar con independencia de la plataforma: limite el acceso a quienes ya lo tienen en lugar de «Todos» e incluya al menos una prueba negativa con su contenido más sensible, como material restringido de RR. HH. Si esa prueba devuelve contenido, detenga el despliegue.
Actuar: fundamentado, registrado, acotado
Cuando un agente hace algo más que responder, por ejemplo actualizar un registro o desencadenar un proceso, el patrón es el mismo. AWS describe un flujo de trabajo de agente fundamentado en el que el agente determina la intención, consulta la política en la base de conocimiento, ejecuta una acción solo si la solicitud es admisible, y hace todo ello dentro de salvaguardas y con registro. Su guía sobre fundamentación y recuperación añade elementos de gobernanza que conviene incluir en su lista de comprobación: calidad de los datos de origen, control de acceso por identidad y rol, políticas de versionado y actualidad, registro de auditoría y bucles de retroalimentación para las correcciones.
Nuestro propio diseño sigue la misma estructura: los agentes trabajan dentro de los permisos, solicitan aprobación cuando la acción es relevante y dejan un rastro de auditoría.
Reducir las respuestas erróneas
Para las preguntas en las que ya dispone de una respuesta verificada, puede prescindir por completo de la generación. AWS describe una caché semántica verificada que devuelve directamente una respuesta curada cuando una consulta coincide estrechamente con una pregunta conocida, y recurre al modelo solo para consultas de baja similitud. El principio se aplica de forma general: si existe una respuesta aprobada, ofrézcala.
Dónde no tiene cabida la IA
Ser explícito sobre los límites hace que una integración sea más segura y más económica.
- Precios, descuentos y condiciones contractuales. Ofrézcalos desde el registro del CRM o de finanzas, o derive a una persona. No permita que un modelo los parafrasee.
- Decisiones que afectan a los derechos o al sustento de las personas, como la contratación o la evaluación crediticia. El EU AI Act considera de alto riesgo algunos sistemas en estos ámbitos, con obligaciones más estrictas.
- Asesoramiento jurídico, fiscal y médico. La recuperación puede señalar el texto aprobado. No debe interpretarlo.
- Contenido sin responsable. Si ninguna persona puede avalar un documento, no pertenece al índice.
- Publicación sin revisión. La IA puede redactar. Una persona publica.
- Acceso amplio y sin acotar. Un asistente que lo ve todo es una filtración de datos a la espera de la pregunta adecuada.
Adopte un proceso cada vez, empezando por el más costoso. La reducción de consultas de soporte o los cuestionarios de seguridad en ventas suelen ser buenos primeros candidatos porque el volumen es alto y las respuestas aprobadas ya existen.
El RGPD, la NIS2 y la Ley de IA de la UE en el diseño
Si su base de conocimiento incluye datos personales de personas en la UE, el diseño debe tener en cuenta la normativa europea desde el principio y no después del lanzamiento. En términos generales:
- El GDPR se aplica cuando se tratan datos personales de personas en la UE. Esto incluye nombres de clientes, correos electrónicos y el contenido de los tickets dentro de su índice. Conviene pensar dónde se almacenan y se tratan los datos, qué proveedores actúan como encargados del tratamiento y requieren un contrato de encargado del tratamiento, cuánto tiempo se conserva el contenido y cómo se eliminan los datos de una persona tanto de la fuente como del índice.
- La limitación de la finalidad es importante cuando interviene un proveedor. Compruebe que el contenido que indexa para la búsqueda no se reutiliza para entrenar los modelos propios del proveedor.
- El EU AI Act establece obligaciones según la categoría de riesgo. Muchos casos de uso de una base de conocimiento, como responder preguntas sobre el producto, son de menor riesgo, pero aun así conviene revisar las obligaciones de transparencia y las categorías de alto riesgo.
- NIS2 trata de la gestión de riesgos de ciberseguridad de las entidades incluidas en su ámbito de aplicación. Si su empresa entra en ese ámbito es una cuestión para su asesor jurídico.
En la práctica, estos marcos se solapan. El control de accesos, el registro de actividad y las evaluaciones de riesgos documentadas sirven a varios de ellos a la vez. Nada de esto constituye asesoramiento jurídico, y ninguna arquitectura garantiza el cumplimiento. Pida a su asesor jurídico o a su delegado de protección de datos que confirme qué le aplica. Nuestro marco de gobernanza de la IA para SaaS B2B aborda el lado práctico.
Perspectiva: por qué construimos primero los datos
Nos preguntan por las bases de conocimiento cuando algo ya ha salido mal: un asistente citó los precios del año pasado, un agente de soporte pegó una respuesta que contradecía el contrato o alguien encontró un documento interno en una respuesta de un chat.
Casi siempre, la base de conocimiento no era el problema. El problema era que nadie era responsable de la verdad. El CRM decía una cosa, el sistema financiero otra y el wiki una tercera. Conectar un asistente de IA a los tres solo hizo que el desacuerdo fuera más rápido.
Por eso trabajamos en un orden fijo. Primero, la base de datos: los datos del CRM y de finanzas convertidos en una única versión acordada de la verdad. Después, la capa de IA, que conecta esos datos con el asistente que su empresa ya utiliza. Y luego, agentes por departamento para Finanzas, Ventas y Éxito del Cliente que su propio equipo usa en lenguaje natural, dentro de los permisos, con aprobación donde importa y con un registro de auditoría.
También decimos dónde debe quedarse fuera la IA: los términos de los contratos, las decisiones sobre personas y cualquier contenido sin responsable. Una base de conocimiento es útil cuando es acotada, actual y está sujeta a permisos. Es un riesgo cuando es grande y no tiene responsable.
La empresa se queda con lo que construimos: el código fuente, la documentación y la infraestructura se transfieren en la entrega, y el desarrollo, el piloto y las pruebas se ejecutan en infraestructura europea autoalojada en Alemania.
Claus Nielsen
Trabaje con NordOps Consulting
Si su equipo ya usa IA pero nadie es responsable de ella, el primer paso suele ser tener una imagen clara de sus datos y de dónde aporta valor la IA. Nuestro AI Readiness Assessment parte de €4,500 y examina su base de datos, sus procesos y su situación regulatoria. Para una responsabilidad continuada, el servicio de Chief AI Officer a tiempo parcial parte de €1,500 al mes en el nivel Advisor, de €3,250 en el nivel Operating y de €5,500 en el nivel Embedded.
Los desarrollos se facturan al 30% del ahorro del primer año, una vez medido y demostrado, o a un precio fijo acordado antes de empezar el trabajo. Puede ver la lista completa en la página de precios, o empezar con una llamada de descubrimiento gratuita de 30 minutos. Nuestros agentes de IA para Finanzas, Ventas y Éxito del Cliente muestran cómo es la capa departamental una vez que los datos están en orden.
Una lista de comprobación antes de la puesta en marcha
- Cada fuente tiene un responsable designado, una audiencia y una fecha de revisión.
- Para cada tipo de pregunta, una fuente está marcada como autoritativa.
- Los conectores usan los ámbitos más restringidos y, por defecto, acceso de solo lectura.
- Los permisos se sincronizan con la misma frecuencia que el contenido, y las eliminaciones llegan al índice.
- Se supera una prueba negativa contra su contenido más sensible.
- La recuperación se prueba con preguntas reales antes de que cualquier modelo redacte respuestas.
- La IA redacta, las personas publican.
- Las acciones se registran y requieren aprobación cuando lo que está en juego es importante.
- La ubicación de los datos, los encargados del tratamiento y la conservación están documentados y revisados por su asesor jurídico.
- Alguien es responsable del sistema después del lanzamiento.
FAQ
¿Cuál es el objetivo de integrar una base de conocimiento?
Pone respuestas aprobadas dentro de las herramientas que la gente ya usa, como el CRM, el servicio de soporte, el chat y los asistentes de IA. Esto ahorra el tiempo de cambiar entre herramientas y evita mantener copias duplicadas. También ofrece a la IA una fuente controlada de la que recuperar información.
¿A qué se puede conectar una base de conocimiento?
Las fuentes habituales son repositorios de documentos, sistemas de tickets, herramientas de comunicación, plataformas de alojamiento de código y sistemas de registro estructurados como el CRM y los de finanzas. En las empresas SaaS, los sistemas de registro deben ser la autoridad para datos como el plan, el precio y la fecha de renovación. Los artículos explican y los registros afirman.
¿Se pueden automatizar por completo las actualizaciones de la base de conocimiento?
La detección y la redacción se pueden automatizar: detectar lagunas, proponer artículos nuevos y señalar los obsoletos. La publicación debe seguir en manos de un revisor designado, sobre todo para todo lo que vea el cliente o lo que vaya a citar una IA.
¿Cómo evitamos que un asistente de IA exponga documentos restringidos?
Traslade los permisos del sistema de origen al índice y filtre los resultados según la identidad de quien pregunta. Actualice los permisos con la misma frecuencia que el contenido y ejecute una prueba negativa sobre su material más sensible antes del lanzamiento.
¿Requiere esto una revisión jurídica en Europa?
Sí, en la práctica. El GDPR, NIS2 y el EU AI Act pueden aplicarse, cada uno según sus datos y su caso de uso. Un asesor jurídico o un delegado de protección de datos debe confirmar qué le aplica.
Fuentes
- Integraciones de bases de conocimiento: arquitectura y pruebas
- Enterprise Knowledge Base for AI: Architecture Guide
- AI Support Knowledge Base That Updates Itself
- Build Secure Knowledge Base Integrations for AI Agents (DZone)
- Microsoft Copilot Connector Knowledge Onboarding Runbook
- AWS Prescriptive Guidance: Grounded agent AI workflow
- AWS Prescriptive Guidance: Grounding and Retrieval Augmented Generation
- AWS Machine Learning Blog: Reducción de alucinaciones con una caché semántica verificada