Die Integration einer Wissensdatenbank bedeutet, Ihre Dokumentation mit den Systemen zu verbinden, in denen Ihr Team und Ihre Kunden ohnehin arbeiten: CRM, Support-Desk, Chat, Finanzen und Produkt. Gut umgesetzt, erhalten Mitarbeitende die freigegebene Antwort direkt in dem Tool, das sie gerade nutzen, und KI-Assistenten greifen auf aktuelle Informationen zurück, statt zu raten. Schlecht umgesetzt, kopieren Sie veraltete Inhalte an noch mehr Orte. Der Unterschied hängt an drei Entscheidungen: Welche Quellen sind maßgeblich, wer darf was sehen und wie bleiben Inhalte aktuell.
Dieser Leitfaden richtet sich an Gründer, COOs und Leiter von Finance, Sales und Customer Success in B2B-SaaS-Unternehmen mit etwa 20 bis 200 Mitarbeitenden. Er behandelt, was Sie anbinden sollten, wie Sie Ihre maßgebliche Quelle bestimmen, wie Automatisierung funktioniert, wie KI das Ergebnis sicher nutzen kann und was die europäischen Vorgaben für die Gestaltung bedeuten.
Kurz gefasst
- Eine Integration der Wissensdatenbank bringt freigegebene Antworten in CRM-Datensätze, Tickets, Chat und KI-Assistenten, sodass niemand das Tool wechseln oder eine zweite Kopie pflegen muss.
- Beginnen Sie mit einem Quellenregister: Legen Sie fest, welches System für welche Art von Fragen maßgeblich ist, und schließen Sie veraltete oder doppelte Inhalte aus, bevor Sie irgendetwas anbinden.
- Behandeln Sie Berechtigungen als Daten. Was ein Nutzer im Quellsystem nicht öffnen kann, darf die KI für ihn auch nicht abrufen.
- Automatisierung sollte Lücken erkennen und Aktualisierungen entwerfen. Ein Mensch sollte freigeben, was veröffentlicht wird.
- Planen Sie unter DSGVO und EU AI Act von Anfang an Datenstandort, Zugriffskontrolle und Prüfpfade ein, und lassen Sie sich von Ihrer Rechtsberatung bestätigen, wie diese Regeln für Sie gelten.
Inhaltsverzeichnis
- Was die Integration einer Wissensdatenbank tatsächlich bedeutet
- Legen Sie zuerst Ihre maßgebliche Quelle fest
- So integrieren Sie Schritt für Schritt
- Wo die Automatisierung der Wissensdatenbank hilft
- KI die Wissensdatenbank sicher nutzen lassen
- Wo KI nicht hingehört
- DSGVO, NIS2 und EU AI Act im Design
- Perspektive: Warum wir zuerst die Daten aufbauen
- Arbeiten Sie mit NordOps Consulting zusammen
- Eine Checkliste vor dem Go-live
- FAQ
- Quellen
Was die Integration einer Wissensdatenbank tatsächlich bedeutet
Eine Wissensdatenbank allein ist eine Bibliothek. Eine Integration macht daraus einen Service. Statt Menschen zu bitten, ein Help Center oder Wiki aufzurufen, erscheint der passende Artikel oder die passende Antwort in einem CRM-Datensatz, einem Support-Ticket, einem Live-Chat, in Slack oder Microsoft Teams oder in einem KI-Chatbot. Eine Übersicht zu Integrationen beschreibt dies als das Einbringen relevanter Artikel und Dokumentation in die Tools, die Kunden, Agenten und Teams bereits nutzen.
Für ein SaaS-Unternehmen ist der Nutzen praktisch:
- Support-Mitarbeitende antworten schneller, weil der freigegebene Artikel direkt neben dem Ticket steht.
- Customer-Success-Manager sehen die passende Onboarding- oder Produktanleitung im Account, an dem sie gerade arbeiten.
- Der Vertrieb holt aktuelle Produkt- und Sicherheitsantworten in einen Deal, statt einen Kollegen zu fragen.
- Kunden finden Antworten im Produkt oder im Chat, bevor sie ein Ticket eröffnen.
- KI-Assistenten rufen freigegebene Inhalte ab, statt sie zu erfinden.
Beachten Sie, was in dieser Liste fehlt: ein neues Tool. Die besten Integrationen schaffen keinen neuen Ort, an dem man suchen muss. Sie beseitigen einen.
Legen Sie zuerst Ihre maßgebliche Quelle fest
Die meisten gescheiterten Integrationen scheitern, bevor ein Konnektor gebaut wird. Das Unternehmen hat dieselbe Preisregel in einer Wiki-Seite, einem CRM-Feld, einer Präsentation und einem Support-Makro, und die vier widersprechen sich. Verbinden Sie alle vier mit einem KI-Assistenten, zitiert er diejenige, die am höchsten rankt.
Laut einem Architektur-Leitfaden speist sich eine produktive Wissensdatenbank typischerweise aus sechs Inhaltsfamilien: Dokumentenablagen, Ticketsysteme, Code-Hosting-Plattformen, Kommunikationsarchive, strukturierte Leitsysteme (Systems of Record) und externe maßgebliche Inhalte. Für ein SaaS-Unternehmen sind die strukturierten Systems of Record am wichtigsten: Ihr CRM und Ihr Finanzsystem enthalten die Fakten, die andere Inhalte nur beschreiben.
Ein Quellenregister aufbauen
Bevor Sie etwas anbinden, schreiben Sie pro Ablage eine Zeile. Nützliche Felder sind:
- Verantwortlicher: eine namentlich genannte Person, kein Team.
- Zielgruppe: nur intern, kundenorientiert oder partnerorientiert.
- Datenklassifizierung, einschließlich der Angabe, ob personenbezogene Daten enthalten sind.
- Maßgeblich für welche Fragen und welche Quellen bei Widersprüchen Vorrang haben.
- Prüfdatum und Aufbewahrungsfrist.
- Wie Löschungen den Index erreichen.
Schließen Sie dann aus, was nicht dorthin gehört: veraltete Entwürfe, doppelte Kopien, persönliche Notizen und alles, bei dem der Verantwortliche nicht sagen kann, ob es noch korrekt ist.
Systems of Record den Vorrang geben
Eine einfache Regel hat sich bewährt: Wenn ein Fakt in einem strukturierten System liegt, hat das strukturierte System Vorrang. Vertragswert, Verlängerungsdatum, Tarif, Rechnungsstatus und Nutzung gehören in die CRM- und Finanzdaten. Artikel erklären, wie man sie nutzt oder interpretiert. Sie geben sie nie wieder.
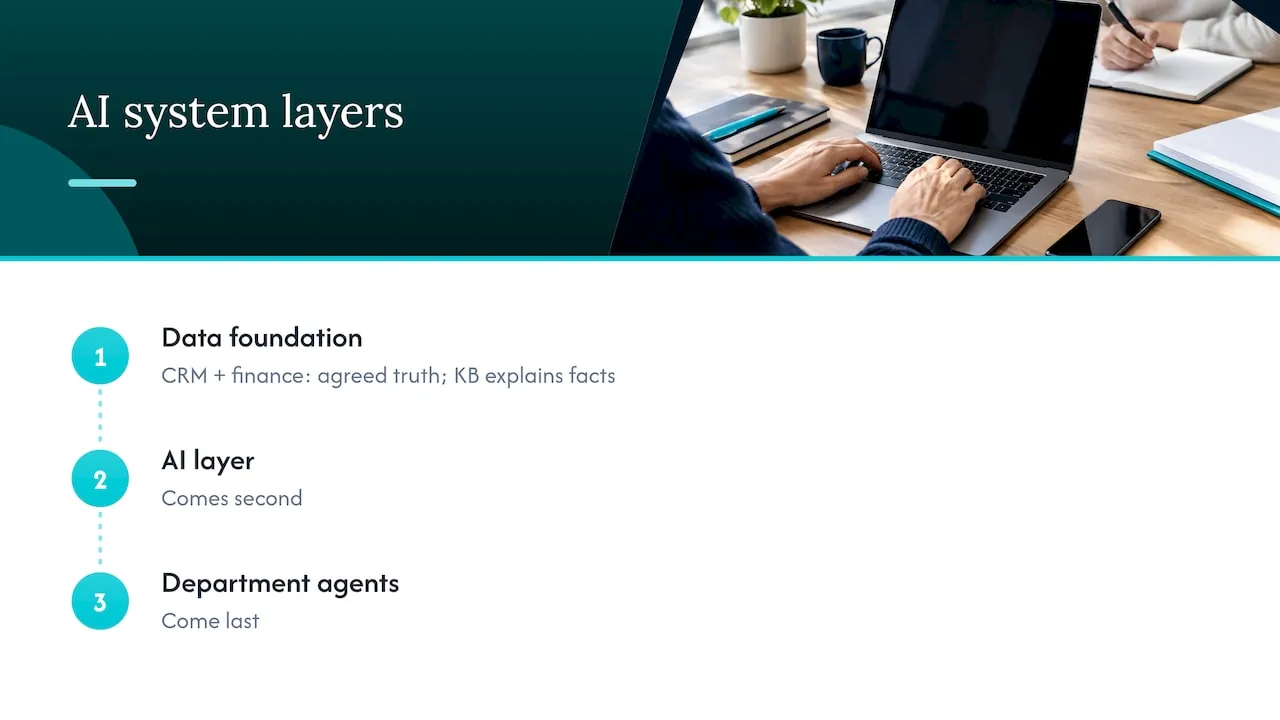
Dieselbe Reihenfolge verwenden wir, wenn wir KI für Kunden aufbauen. Zuerst kommt das Datenfundament: CRM- und Finanzdaten als die eine abgestimmte Version der Wahrheit, aufbereitet vom Processor. Die KI-Schicht folgt an zweiter Stelle. Die Agenten der Fachabteilungen kommen zuletzt. Eine Wissensdatenbank sitzt innerhalb dieser Struktur als erklärende Schicht über verlässlichen Daten.
So integrieren Sie Schritt für Schritt
Eine praktische Abfolge, die sich an den Schichten orientiert, die die meisten Produktivsysteme gemeinsam haben: Konnektoren, Transformation, Chunking und Indexierung, dann Retrieval und Generierung.
- Quellen inventarisieren und priorisieren. Nutzen Sie dafür das obige Register.
- Mit dem engsten Zugriff anbinden. Geben Sie jedem Konnektor nur die kleinsten Berechtigungen, die er braucht. Nur lesend, es sei denn, ein Workflow schreibt tatsächlich zurück.
- Bereinigen und transformieren. Entfernen Sie Navigationsballast, vereinheitlichen Sie Formate und behalten Sie Titel, Verantwortliche und Datumsangaben als Metadaten.
- Nach Bedeutung in Chunks teilen. Teilen Sie Inhalte an natürlichen Grenzen wie einer Anleitung oder einer Richtlinienklausel, nicht an willkürlichen Zeichenzahlen.
- Mit Metadaten indexieren. Speichern Sie Quelle, Zeitstempel, Zielgruppe und ein Prioritätskennzeichen, damit das Retrieval verbindliche Inhalte bevorzugen kann.
- Retrieval testen, bevor generiert wird. Stellen Sie 50 echte Fragen aus Ihrem Support- und Vertriebsverlauf und prüfen Sie, ob die richtige Passage zurückkommt. Erst dann fügen Sie eine KI hinzu, die Antworten formuliert.
- Stufenweise ausrollen. Zuerst eine interne Vorschau, dann eine begrenzte Gruppe, dann breitere Nutzung.
Nehmen Sie Aktualität und Berechtigungen in Ihre Abnahmekriterien auf, nicht in eine spätere Bereinigung. „Es liefert die richtige Antwort“ genügt nicht. „Es liefert die richtige, aktuelle Antwort, und nur an Personen, die sie sehen dürfen“ ist der Test.
Change Management ist so wichtig wie Konnektoren. Die Menschen müssen wissen, woher Antworten jetzt kommen und wer eine falsche korrigiert. Schulungen zu Teamarbeit und Zusammenarbeit können Teams helfen, sich auf Verantwortlichkeiten zu einigen und Inhalte abteilungsübergreifend synchron zu halten, wenn sich das Setup ändert.
Wo die Automatisierung der Wissensdatenbank hilft
Automatisierung ist der Punkt, an dem eine Wissensdatenbank aufhört zu veralten. Die meisten Inhalte veralten nicht, weil Menschen nachlässig sind, sondern weil niemand erfährt, wann sich das Produkt geändert hat.
Die gängigen Automatisierungsaufgaben sind:
- Entwerfen neuer Artikel aus gelösten Tickets, Chat-Transkripten oder Release Notes.
- Erfassen von Antworten, die in Slack-Threads oder Support-Antworten auftauchen.
- Organisieren von Inhalten durch Tagging und das Erkennen von Beinahe-Duplikaten.
- Ausspielen von Artikeln im Chat, im Produkt oder über einen KI-Assistenten.
- Aktualisieren von Inhalten, indem von einer Produktänderung betroffene Artikel markiert und Änderungen entworfen werden.
Die wichtige Designentscheidung ist, wo der Mensch eingebunden ist. Ein Leitfaden zu sich selbst aktualisierenden Support-Inhalten macht denselben Punkt: Automatisch ist das Erkennen von Lücken und das Entwerfen von Änderungen, und eine Person prüft, bevor etwas live geht. So bauen wir es auch. Das System schlägt vor, ein benannter Verantwortlicher genehmigt.
Ein weiteres Muster, das man kennen sollte, ist die Schleife, die Erkenntnisse zurückschreibt. Gespräche werden erfasst, in durchsuchbare Form umgewandelt, zur Beantwortung von Fragen genutzt, und das neue Wissen wird in das führende System zurückgespielt. Diese Schleife funktioniert nur, wenn das führende System von Anfang an sauber ist.
Einen tieferen Einblick in einen Prozess, bei dem sich das auszahlt, finden Sie in unserem Beitrag zur Onboarding-Automatisierung für B2B-SaaS.
KI die Wissensdatenbank sicher nutzen lassen
Ein KI-Assistent, der mit Ihrer Wissensdatenbank verbunden ist, kann zwei Dinge tun: lesen und handeln. Beides braucht Leitplanken.
Lesen: Berechtigungen folgen dem Nutzer
Der häufigste schwerwiegende Fehler ist ein Assistent, der ein Dokument anzeigt, das die fragende Person nie öffnen durfte. Die Lösung besteht darin, Berechtigungen als Daten zu behandeln. Ein technischer Beitrag zu sicheren Integrationen empfiehlt, dass ein Agent das Berechtigungsmodell des Quellsystems versteht und abbildet, bevor er eine Seite verarbeitet, und dass das Retrieval Dokumente zur Abfragezeit nach der Identität des aktuellen Nutzers filtert. Außerdem rät er, Zugriffslisten so oft zu aktualisieren wie Inhalte, denn ein Dokument, das heute Morgen eingeschränkt wurde, sollte heute Nachmittag nicht mehr ausgeliefert werden.
Das veröffentlichte Onboarding-Runbook für Copilot-Konnektoren von Microsoft enthält eine konkrete Regel, die man auf jeder Plattform übernehmen sollte: Den Zugriff auf Personen beschränken, die ihn ohnehin schon haben, statt auf „Everyone“, und mindestens einen Negativtest gegen Ihre sensibelsten Inhalte einschließen, etwa vertrauliche HR-Unterlagen. Liefert dieser Test Inhalte zurück, stoppen Sie den Rollout.
Handeln: fundiert, protokolliert, begrenzt
Wenn ein Agent mehr tut als zu antworten, zum Beispiel einen Datensatz zu aktualisieren oder einen Prozess auszulösen, gilt dasselbe Muster. AWS beschreibt einen fundierten Agenten-Workflow, in dem der Agent die Absicht ermittelt, die Richtlinie in der Wissensdatenbank nachschlägt, eine Aktion nur aufruft, wenn die Anfrage berechtigt ist, und all das innerhalb von Leitplanken und mit Protokollierung erledigt. Ihre Hinweise zu Grounding und Retrieval ergänzen Governance-Punkte, die auf Ihre Checkliste gehören: Qualität der Quelldaten, Zugriffskontrolle nach Identität und Rolle, Richtlinien für Versionierung und Aktualität, Audit-Protokollierung und Feedbackschleifen für Korrekturen.
Unser eigenes Design folgt derselben Form: Agenten arbeiten innerhalb von Berechtigungen, holen Freigaben ein, wo die Aktion von Bedeutung ist, und hinterlassen einen Prüfpfad.
Falsche Antworten reduzieren
Bei Fragen, für die Sie bereits eine verifizierte Antwort haben, können Sie die Generierung ganz überspringen. AWS beschreibt einen verifizierten semantischen Cache, der direkt eine kuratierte Antwort liefert, wenn eine Anfrage einer bekannten Frage stark ähnelt, und nur bei Anfragen mit geringer Ähnlichkeit auf das Modell zurückgreift. Das Prinzip gilt allgemein: Wo eine freigegebene Antwort existiert, liefern Sie sie aus.
Wo KI nicht hingehört
Wer Grenzen klar benennt, macht eine Integration sicherer und günstiger.
- Preise, Rabatte und Vertragsbedingungen. Liefern Sie diese aus dem CRM- oder Finanzdatensatz aus oder leiten Sie an eine Person weiter. Lassen Sie ein Modell sie nicht umformulieren.
- Entscheidungen, die die Rechte oder die Existenzgrundlage von Menschen betreffen, etwa bei Einstellung oder Kreditprüfung. Der EU AI Act stuft einige Systeme in diesen Bereichen als Hochrisiko ein, mit strengeren Pflichten.
- Rechts-, Steuer- und medizinische Beratung. Retrieval kann auf den freigegebenen Text verweisen. Es sollte ihn nicht auslegen.
- Inhalte ohne Verantwortlichen. Wenn keine Person für ein Dokument einstehen kann, gehört es nicht in den Index.
- Ungeprüftes Veröffentlichen. KI kann entwerfen. Ein Mensch veröffentlicht.
- Breiter, unbegrenzter Zugriff. Ein Assistent, der alles sehen kann, ist ein Datenleck, das nur auf die richtige Frage wartet.
Führen Sie einen Prozess nach dem anderen ein und beginnen Sie mit dem teuersten. Support-Deflection oder Sicherheitsfragebögen im Vertrieb sind oft gute erste Kandidaten, weil das Volumen hoch ist und die freigegebenen Antworten bereits existieren.
DSGVO, NIS2 und EU AI Act im Design
Wenn Ihre Wissensdatenbank personenbezogene Daten von Menschen in der EU berührt, sollte das Design europäische Vorgaben von Anfang an berücksichtigen und nicht erst nach dem Start. Allgemein gilt:
- Die DSGVO gilt, sobald personenbezogene Daten von Menschen in der EU verarbeitet werden. Dazu zählen Kundennamen, E-Mail-Adressen und Ticketinhalte in Ihrem Index. Klären Sie, wo Daten gespeichert und verarbeitet werden, welche Anbieter als Auftragsverarbeiter agieren und einen Auftragsverarbeitungsvertrag benötigen, wie lange Inhalte aufbewahrt werden und wie Sie die Daten einer Person sowohl in der Quelle als auch im Index löschen.
- Die Zweckbindung ist wichtig, sobald ein Anbieter beteiligt ist. Prüfen Sie, dass Inhalte, die Sie für die Suche indizieren, nicht zum Training der eigenen Modelle eines Anbieters wiederverwendet werden.
- Der EU AI Act legt Pflichten nach Risikokategorie fest. Viele Anwendungsfälle für Wissensdatenbanken, etwa die Beantwortung von Produktfragen, haben ein geringeres Risiko, doch Transparenzpflichten und die Hochrisiko-Kategorien sollten Sie dennoch prüfen.
- NIS2 betrifft das Management von Cybersicherheitsrisiken für Einrichtungen im Anwendungsbereich. Ob Ihr Unternehmen darunter fällt, ist eine Frage für Ihre Rechtsberatung.
Diese Regelwerke überschneiden sich in der Praxis. Zugriffskontrolle, Protokollierung und dokumentierte Risikobewertungen dienen mehreren davon zugleich. Nichts davon ist Rechtsberatung, und keine Architektur garantiert Compliance. Lassen Sie sich von Ihrer Rechtsberatung oder Ihrem Datenschutzbeauftragten bestätigen, was für Sie gilt. Unser AI-Governance-Framework für B2B SaaS behandelt die praktische Seite.
Perspektive: Warum wir zuerst die Daten aufbauen
Zu Wissensdatenbanken werden wir gefragt, wenn bereits etwas schiefgelaufen ist: Ein Assistent hat die Preise des Vorjahres genannt, ein Support-Mitarbeiter hat eine Antwort eingefügt, die dem Vertrag widersprach, oder jemand hat ein internes Dokument in einer Chat-Antwort gefunden.
Fast immer war nicht die Wissensdatenbank das Problem. Das Problem war, dass niemand die Wahrheit verantwortete. Das CRM sagte das eine, das Finanzsystem das andere und das Wiki ein drittes. Einen KI-Assistenten mit allen dreien zu verbinden, hat den Widerspruch nur schneller gemacht.
Deshalb arbeiten wir in einer festen Reihenfolge. Zuerst das Datenfundament: CRM- und Finanzdaten werden zu einer abgestimmten Version der Wahrheit. Dann die KI-Schicht, die diese Daten mit dem Assistenten verbindet, den Ihr Unternehmen bereits nutzt. Dann Abteilungs-Agenten für Finance, Sales und Customer Success, die Ihre eigenen Mitarbeitenden in einfacher Sprache nutzen, innerhalb ihrer Berechtigungen, mit Freigabe dort, wo es darauf ankommt, und mit einem Prüfprotokoll.
Wir sagen auch, wo KI draußen bleiben sollte: bei Vertragsbedingungen, bei Entscheidungen über Menschen und bei allen Inhalten ohne Verantwortlichen. Eine Wissensdatenbank ist nützlich, wenn sie fokussiert, aktuell und berechtigungsgesteuert ist. Sie ist ein Risiko, wenn sie groß ist und niemandem gehört.
Das Unternehmen behält, was wir bauen: Quellcode, Dokumentation und Infrastruktur werden bei der Übergabe übertragen, und Aufbau, Pilot und Tests laufen auf selbst gehosteter europäischer Infrastruktur in Deutschland.
Claus Nielsen
Arbeiten Sie mit NordOps Consulting zusammen
Wenn Ihr Team bereits KI nutzt, aber niemand dafür verantwortlich ist, besteht der erste Schritt meist in einem klaren Bild Ihrer Daten und der Stellen, an denen sich KI auszahlt. Unser AI Readiness Assessment beginnt bei €4,500 und betrachtet Ihr Datenfundament, Ihre Prozesse und Ihre regulatorische Lage. Für dauerhafte Verantwortung beginnt das Retainer-Modell Fractional Chief AI Officer ab €1,500 pro Monat in der Stufe Advisor, ab €3,250 in der Stufe Operating und ab €5,500 in der Stufe Embedded.
Builds werden mit 30% der Einsparung im ersten Jahr berechnet, sobald diese gemessen und belegt ist, oder zu einem Festpreis, der vor Arbeitsbeginn vereinbart wird. Die vollständige Liste finden Sie auf der Preisseite, oder Sie beginnen mit einem kostenlosen 30-minütigen Erstgespräch. Unsere KI-Agenten für Finance, Sales und Customer Success zeigen, wie die Abteilungsebene aussieht, sobald die Daten in Ordnung sind.
Eine Checkliste vor dem Go-live
- Jede Quelle hat einen benannten Verantwortlichen, eine Zielgruppe und ein Prüfdatum.
- Für jeden Fragetyp ist eine Quelle als maßgeblich gekennzeichnet.
- Konnektoren nutzen standardmäßig die engsten Berechtigungsbereiche und reinen Lesezugriff.
- Berechtigungen werden so oft synchronisiert wie Inhalte, und Löschungen erreichen den Index.
- Ein Negativtest gegen Ihre sensibelsten Inhalte wird bestanden.
- Das Retrieval wird an echten Fragen getestet, bevor ein Modell Antworten schreibt.
- KI entwirft, Menschen veröffentlichen.
- Aktionen werden protokolliert und erfordern eine Freigabe, wo viel auf dem Spiel steht.
- Datenstandort, Auftragsverarbeiter und Aufbewahrung sind dokumentiert und werden von Ihrer Rechtsberatung geprüft.
- Jemand ist nach dem Start für das Ganze verantwortlich.
FAQ
Was ist der Zweck einer Integration der Wissensdatenbank?
Sie bringt freigegebene Antworten in die Tools, die Mitarbeitende ohnehin nutzen, etwa CRM, Support-Desk, Chat und KI-Assistenten. Das spart Zeit beim Wechsel zwischen Tools und vermeidet die Pflege doppelter Kopien. Außerdem erhält die KI eine kontrollierte Quelle, aus der sie abrufen kann.
Womit kann sich eine Wissensdatenbank verbinden?
Übliche Quellen sind Dokumentenablagen, Ticketsysteme, Kommunikationstools, Code-Hosting-Plattformen und strukturierte Systeme of Record wie CRM und Finanzsysteme. Bei SaaS-Unternehmen sollten die Systeme of Record maßgeblich sein für Fakten wie Tarif, Preis und Verlängerungsdatum. Artikel erklären, Datensätze legen fest.
Lassen sich Aktualisierungen der Wissensdatenbank vollständig automatisieren?
Erkennung und Entwurf lassen sich automatisieren: Lücken erkennen, neue Artikel vorschlagen und veraltete markieren. Die Veröffentlichung sollte bei einem benannten Prüfer bleiben, besonders bei allem, was für Kunden sichtbar ist oder was eine KI zitieren wird.
Wie verhindern wir, dass ein KI-Assistent eingeschränkte Dokumente preisgibt?
Übernehmen Sie die Berechtigungen des Quellsystems in den Index und filtern Sie die Ergebnisse nach der Identität der fragenden Person. Aktualisieren Sie Berechtigungen so oft wie Inhalte, und führen Sie vor dem Start einen Negativtest mit Ihrem sensibelsten Material durch.
Ist in Europa eine rechtliche Prüfung nötig?
In der Praxis ja. DSGVO, NIS2 und der EU AI Act können je nach Ihren Daten und Ihrem Anwendungsfall jeweils gelten. Eine Rechtsberatung oder ein Datenschutzbeauftragter sollte bestätigen, was für Sie gilt.
Quellen
- Integrationen von Wissensdatenbanken: Architektur und Tests
- Enterprise Knowledge Base for AI: Architecture Guide
- AI Support Knowledge Base That Updates Itself
- Build Secure Knowledge Base Integrations for AI Agents (DZone)
- Microsoft Copilot Connector Knowledge Onboarding Runbook
- AWS Prescriptive Guidance: Grounded agent AI workflow
- AWS Prescriptive Guidance: Grounding and Retrieval Augmented Generation
- AWS Machine Learning Blog: Halluzinationen reduzieren mit einem verifizierten semantischen Cache