Ein operatives Data Warehouse führt aktuelle Daten aus Ihren Geschäftssystemen, etwa CRM, Billing und Support, an einem Ort zusammen, damit Teams über das berichten können, was jetzt passiert, und nicht über den letzten Monat. Für ein B2B-SaaS-Unternehmen mit 20 bis 200 Mitarbeitenden lautet die Frage selten, welches Warehouse-Produkt man kaufen soll. Sie lautet: Welche Daten müssen aktuell sein, wie aktuell, und wer verantwortet die eine abgestimmte Version davon? Wenn das stimmt, funktioniert das Reporting. Es ist zugleich der Schritt, der darüber entscheidet, ob AI Ihrem Team Antworten liefert, denen Sie vertrauen können.
Kurz gefasst
- Ein operatives Data Warehouse (oder Operational Data Store, ODS) hält aktuelle Daten aus mehreren Systemen für das tägliche Reporting vor. Ein klassisches Warehouse hält konsolidierte Historie für Analysen vor.
- „Nahezu in Echtzeit“ bedeutet meist Minuten, nicht Millisekunden. Dashboards für Menschen brauchen selten mehr, und schnellere Aktualisierung verursacht höhere Betriebskosten.
- Legen Sie die Aktualität je nach Abnehmer fest: Ein Finance-Review, eine Sales-Prognose und eine automatisierte Aktion haben unterschiedliche Anforderungen.
- Sich auf eine Version der CRM- und Finanzdaten zu einigen, ist wichtiger als die Tools. AI-Agenten lesen diese Version, deshalb werden Fehler dort zu falschen Antworten.
- Sicherheit, Protokollierung und Zugriffsregeln gelten für die Kopie Ihrer operativen Daten genauso wie für das Original. Das schließt Pflichten nach der DSGVO ein.
Inhaltsverzeichnis
- Was ein operatives Data Warehouse ist
- Operative Datenbank, ODS, Data Warehouse: die Unterschiede
- Wie die Architektur für operatives Reporting funktioniert
- Was „nahezu in Echtzeit“ in Zahlen bedeutet
- Wann Sie eines brauchen und wann nicht
- Die Zielkonflikte, die das Design bestimmen
- Warum das Datenfundament vor AI kommt
- Wo KI nicht hingehört
- Wo die Daten liegen
- Wie wir helfen können
- FAQ
- Quellen
Was ein operatives Data Warehouse ist
Der Begriff wird unscharf verwendet. In der Praxis meint er ein Repository, das aktuelle operative Daten aus Systemen wie CRM, Buchhaltung und Vertrieb zentralisiert, ergänzt um externe Datenquellen, sodass Sie darauf berichten können, ohne jedes System einzeln abzufragen.
Für ein SaaS-Unternehmen sind die Quellen vertraut:
- CRM: Accounts, Kontakte, Pipeline, Verlängerungen.
- Finance: Rechnungen, Zahlungen, Abonnements, Umsatzpläne.
- Produkt: Nutzung, Seats, Feature-Nutzung.
- Support: Tickets, Eskalationen, Health-Signale.
Der Wert liegt nicht im Speicher. Er liegt darin, dass eine Frage wie „Welche Accounts, die in diesem Quartal verlängern, haben offene Eskalationen und unbezahlte Rechnungen?“ eine Antwort bekommt und nicht drei Tabellen, die sich widersprechen.
Operative Datenbank, ODS, Data Warehouse: die Unterschiede
Vier Begriffe werden häufig vermischt. So grenzen sie sich ab.
| Operative Datenbank | Operational Data Store (ODS) | Data Warehouse | |
|---|---|---|---|
| Zweck | Betreibt ein Transaktionssystem, etwa Ihr CRM oder Ihr Abrechnungstool | Aktuelle, detaillierte Daten aus mehreren Systemen für operatives Reporting | Konsolidierte, bereinigte Historie für Analysen |
| Aktualität | Live | Sekunden bis Minuten oder Stunden | Stunden bis Tage |
| Historie | Was die Anwendung eben speichert | Kurz: aktuelle oder jüngste Daten | Lang: Monate bis Jahre |
| Typische Frage | „Aktualisieren Sie diesen Datensatz“ | „Was ist heute offen?“ | „Wie hat sich die Churn-Rate über drei Jahre entwickelt?“ |
Die Unterscheidungen folgen veröffentlichten Beschreibungen: Eine operative Datenbank ist in ein Transaktionssystem eingebaut, ein ODS bezieht detaillierte Transaktionsdaten aus mehreren Systemen mit häufigen Aktualisierungen, und ein Data Warehouse ist ein statischeres Langzeitarchiv. Ein ODS liegt zwischen den Transaktionssystemen und dem analytischen Data Warehouse und hält aktuelle oder neuere Daten vor, die im Takt von Minuten bis Stunden aktualisiert werden, für Fragen wie den Umsatz des heutigen Tages oder aktive Support-Fälle.
Typische Latenzbereiche sind Sekunden bis Minuten bei einer Aufbewahrung von Tagen bis Wochen für ein ODS, gegenüber Stunden bis Tagen bei Monaten bis Jahren für ein Data Warehouse. Ein ODS entspricht in der Regel der Struktur der Quellsysteme und eignet sich für leichtes operatives Reporting, während ein Data Warehouse umfassendere Transformationen anwendet und eine große Historie vorhält.
Moderne Cloud-Data-Warehouses verwischen die Grenze. Sie können Daten in Echtzeit bereitstellen und machen ein separates ODS unter Umständen überflüssig. „Operatives Data Warehouse“ lässt sich deshalb am besten als Aufgabenbeschreibung lesen, nicht als Produkt: aktuelle, integrierte Daten, verlässlich genug, um das Unternehmen darauf zu steuern.
Wie die Architektur für operatives Reporting funktioniert
Unabhängig von den Werkzeugen hat die Architektur dieselben Schichten.
- Quellen. CRM, Abrechnung, Produktdatenbank, Support-Tool.
- Ingestion. Die Daten werden aus den Quellen herausbewegt. Change Data Capture (CDC) überträgt nur Einfügungen, Aktualisierungen und Löschungen, was das übertragene Datenvolumen und die Last auf Netzwerk und Quellsysteme verringert.
- Verarbeitung. Die Daten werden bereinigt, systemübergreifend abgeglichen (ein Kunde, eine ID) und in vereinbarte Definitionen gebracht.
- Bereitstellung. Ein Speicher, der Abfragen für die Menschen und Werkzeuge, die ihn nutzen, schnell beantwortet.
- Nutzung. Dashboards, Berichte, Benachrichtigungen und KI-Assistenten.
Ein verbreitetes Schichtenmuster ist ein ODS, das Rohdaten nahezu in Echtzeit für operative Berichte vorhält, mit nachgelagerten Schichten, die bereinigen, aggregieren und bereitstellen. Ein häufiger Entwurf speist Transaktionsdatenbanken in Warteschlangen und anschließend in die Schichten des Data Warehouse ein, sodass das Reporting die Systeme, in denen Ihr Team arbeitet, nicht ausbremst. Diese Trennung ist der Hauptgrund, Dashboards nicht direkt auf Ihr CRM oder Ihre Abrechnungsdatenbank zu richten.
Wenn Ihre Systeme Änderungen bereits als Ereignisse veröffentlichen, kann derselbe Ablauf darauf aufsetzen. Unser Leitfaden zur ereignisgesteuerten Architektur zeigt, wie das funktioniert und wo es passt.
Was „nahezu in Echtzeit“ in Zahlen bedeutet
Die meisten Teams, die Echtzeit verlangen, brauchen etwas Bescheideneres. Ein Praxis-Framework nennt Aktualitätsstufen von unter einer Sekunde, Sekunden bis etwa einer Minute sowie Minuten bis täglich. Ein anderes beschreibt Beinahe-Echtzeit als grob eine bis 15 Minuten, mit Micro-Batches oder CDC.
Zwei reale Beispiele zeigen, was erreichbar ist:
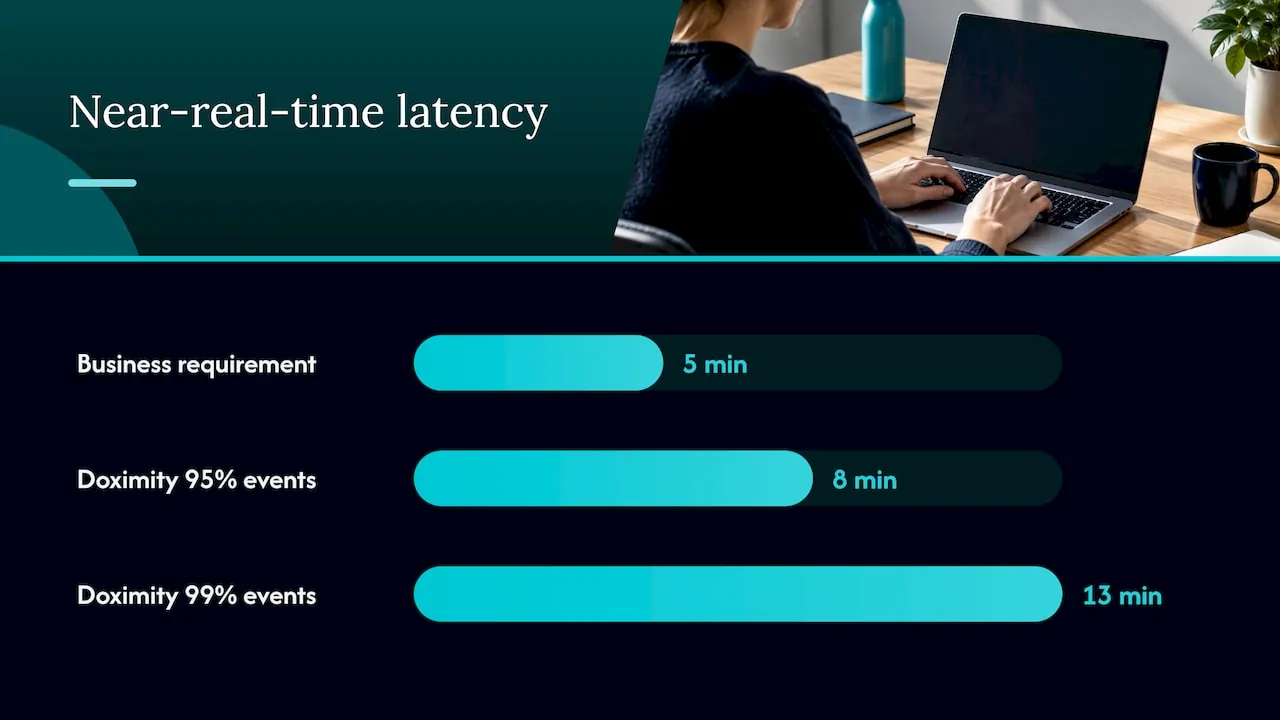
- Ein Engineering-Team bei Doximity berichtete, dass seine CDC-Pipeline Änderungen innerhalb von Minuten abfragbar machte. In einer Stichprobe über 12 Tage erreichten 95% der Ereignisse die abfragbare Schicht innerhalb von acht Minuten und 99% innerhalb von 13 Minuten.
- Eine Hochschularbeit baute eine CDC-Pipeline mit einer durchschnittlichen Ende-zu-Ende-Latenz von 0,6 Sekunden bei etwa 30,000 Datensätzen pro Sekunde und merkte an, dass die geschäftliche Reporting-Anforderung fünf Minuten betrug.
Das zweite Beispiel ist das aufschlussreiche. Die Technik kann die Anforderung mit großem Abstand übertreffen, und die zusätzliche Geschwindigkeit bringt dem Unternehmen nichts.
Es gibt außerdem einen Unterschied zwischen dem Handeln auf Daten in Bewegung und der Abfrage von Daten, die kürzlich eingetroffen sind. Automatisierte Aktionen bei Betrug oder Preisgestaltung brauchen womöglich Ersteres, während menschliche Dashboards in der Regel nur aktuelle Daten benötigen. Ein Vertriebsleiter, der die Pipeline prüft, oder ein Finanzleiter, der Forderungseingänge kontrolliert, nutzt ein menschliches Dashboard.
Wann Sie eines brauchen und wann nicht
Zeitkritische operative Entscheidungen sind der Anwendungsfall dafür. Forschung zum operativen Data Warehousing nennt Lagerbestand, Personaleinsatz, Bedarfsprognosen und Leistungs-Dashboards als Beispiele, die durch untertägige oder stündliche Daten unterstützt werden. Verbreitete Reporting-Anwendungen sind Live-Umsatz-Dashboards, Auftragsabwicklung, einheitliche Kundensichten und Monitoring.
Eine dedizierte operative Bereitstellungsschicht ist gerechtfertigt, wenn die Aktualisierungsverzögerung des Data Warehouse für Live-Dashboards, Betrugsprüfungen oder KI-Kontext zu langsam ist, und überflüssig, wenn alle Nutzer Analysten sind und Stunden oder Tage akzeptabel sind.
Für ein SaaS-Unternehmen mit 20 bis 200 Mitarbeitenden gilt eine praktikable Regel:
- Wöchentliches oder monatliches Management-Reporting: Eine tägliche Aktualisierung in einen konsolidierten Speicher genügt.
- Account-Management, Verlängerungen, Forderungseinzug: Stündliche oder minutengenaue Aktualität über CRM, Finanzen und Support hinweg ist der Punkt, an dem der Nutzen liegt.
- Automatisierte Aktionen, die Datensätze ändern oder Prozesse auslösen: Aktualität sowie Berechtigungen und Freigabe, dazu mehr weiter unten.
- Streaming im Sekundenbruchteil: In Ihrer Größenordnung selten gerechtfertigt.
Die Zielkonflikte, die das Design bestimmen
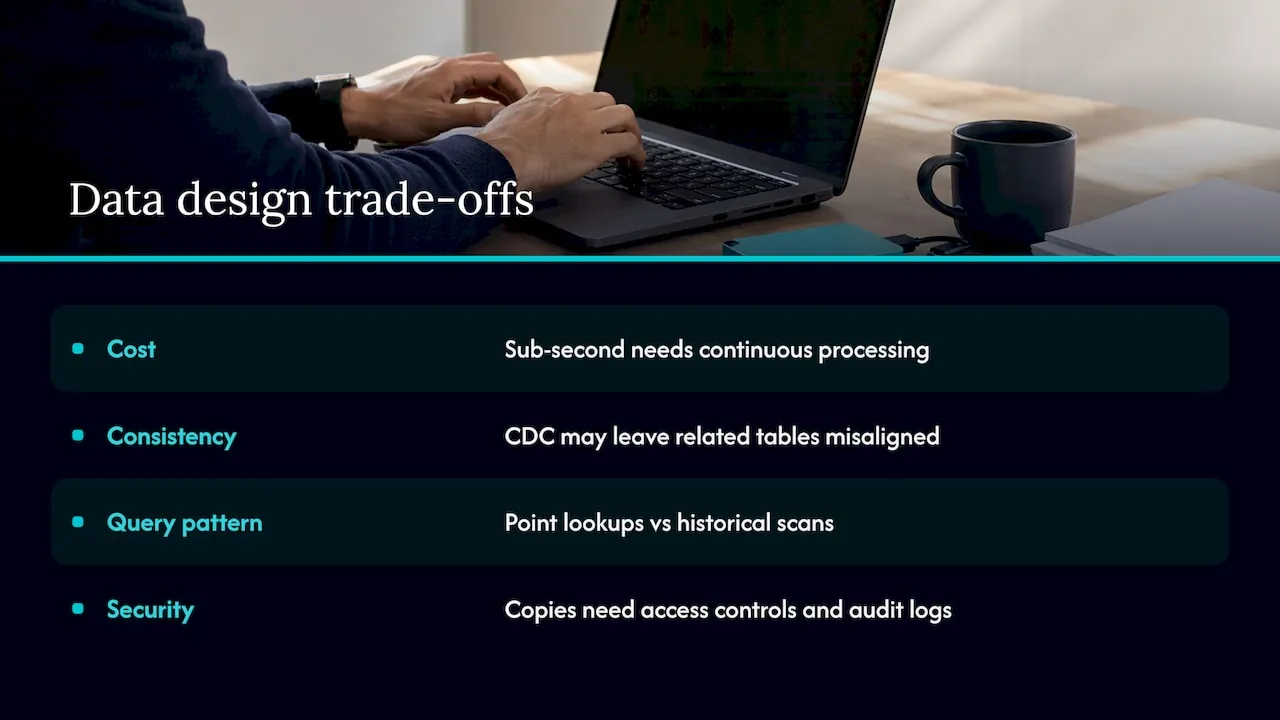
Die Kosten folgen der Latenz. Aktualität im Sekundenbruchteil erfordert dauerhaft laufende Ingestion, Verarbeitung und Bereitstellung mit niedriger Latenz, während Batch im Leerlauf stoppen kann. Streaming verlangt zudem Kenntnisse bei Schemaänderungen, Lag-Überwachung, verspäteten Daten und Wiederherstellung. Der Rat lautet, den leichtesten Stack zu wählen, der die Anforderung des Nutzers erfüllt, und diese Anforderung schriftlich festzulegen, bevor Sie bauen.
Aktuell heißt nicht konsistent. CDC kann jede Tabelle aktueller machen, ohne zu garantieren, dass zusammengehörige Tabellen exakt denselben Zeitpunkt abbilden. Eine Rechnungssumme und ein Abonnementdatensatz können kurzzeitig voneinander abweichen. Legen Sie fest, welche Berichte einen konsistenten Snapshot brauchen und welche eine kleine Verzögerung akzeptieren können.
Abfragemuster unterscheiden sich. Eine Streaming-Schicht berechnet kleine Ergebnismengen für Einzelabfragen vorab, während ein Data Warehouse die Historie für Ad-hoc-Analysen durchsucht. Ihre Kosten folgen unterschiedlichen Treibern, daher sollte das Zugriffsmuster die Wahl leiten.
Sicherheit reist mit den Daten. Eine replizierte Kopie ist keine informelle Kopie. Empfohlene Kontrollen umfassen Zugriff auf Ebene von Rollen, Tabellen, Spalten und Zeilen, Verschlüsselung im Ruhezustand und bei der Übertragung, Audit-Protokollierung und Lineage-Tracking. Enthalten die Daten personenbezogene Daten von EU-Kunden, gilt die GDPR für die Kopie in gleicher Weise. Ihr Datenschutzbeauftragter oder Ihre Rechtsberatung sollte bestätigen, was das für Ihr Setup bedeutet, denn dieser Artikel ist keine Rechtsberatung.
Warum das Datenfundament vor AI kommt
Die meisten SaaS-Teams, die nach einem operativen Data Warehouse fragen, haben ein zweites Motiv: Sie möchten, dass KI Fragen zum Geschäft beantwortet. Damit wird die Frage nach dem Data Warehouse zu einer Frage der Datenqualität.
Ein KI-Assistent, der zwei Systeme mit zwei Definitionen von „aktiver Kunde“ liest, gibt zwei selbstsichere Antworten. Die Lösung ist nicht ein besseres Modell. Sie besteht darin, sich zu einigen, welches System für jeden Fakt die maßgebliche Quelle ist, meist das CRM für den Kunden und die Finanzen für das Geld, und die Daten entsprechend zu bereinigen. Das behandeln wir in CRM und Data Foundation vor KI-Agenten und in unserem Leitfaden zur Datenintegrationsstrategie für SaaS-Teams.
Wir arbeiten in dieser Reihenfolge:
- Data Foundation. Das CRM, die Systeme darum herum und der Processor, der die Daten in eine einheitlich vereinbarte Version der Wahrheit überführt. Der Processor ist der Ort, an dem diese Arbeit stattfindet.
- KI-Schicht. MCP verbindet diese Daten mit dem KI-Assistenten, den Ihr Unternehmen bereits nutzt.
- Abteilungsagenten. Speziell entwickelte Agenten für Finanzen, Vertrieb und Customer Success, die Ihre Mitarbeitenden in einfacher Sprache nutzen, um Daten abzurufen (fragen, berichten, nachschlagen) und Daten zu schreiben (Datensätze aktualisieren, Prozesse auslösen, Zugriffe bereitstellen), innerhalb der Berechtigungen, bei Bedarf mit Freigabe und mit Audit-Trail. Siehe KI-Agenten für Finanzen, Vertrieb und Customer Success.
Im Finanzbereich zahlen sich aktuelle, integrierte Daten zuerst aus. Forderungsmanagement, Liquiditätsprognosen und Budgetverfolgung hängen alle davon ab, dass Abrechnungs-, CRM- und Bankdaten übereinstimmen. Für konkrete Beispiele für Finanz-Dashboards und Entscheidungen sehen Sie sich an, wie Liquiditätsprognosen und Leistungsberichte von aktuellen Zahlen abhängen.
Wo KI nicht hingehört
Klarheit an dieser Stelle spart Geld.
- Wo die Daten nicht abgestimmt sind. Wenn Vertrieb und Finanzen sich über den Umsatz uneinig sind, klären Sie zuerst die Definitionen. KI obendrauf verdeckt die Uneinigkeit nur.
- Entscheidungen, die ohne Freigabe oder Prüfpfad in Sekundenbruchteilen über Geld oder Zugriff entscheiden müssten. Behalten Sie hier einen Menschen im Prozess.
- Rechtliche Beurteilung. KI kann Informationen aufbereiten. Sie entscheidet nicht, was DSGVO, NIS2 oder der EU AI Act von Ihnen verlangen.
- Prozesse, die günstig sind und bereits funktionieren. KI wird Prozess für Prozess eingeführt, beginnend mit dem teuersten, nicht mit dem modischsten.
NIS2 ist die EU-Richtlinie zur Netz- und Informationssicherheit, und der EU AI Act legt Pflichten nach dem Risikoniveau eines KI-Systems fest. Beides behandeln Sie am besten von Anfang an als Designanforderungen, mit integrierter Protokollierung, Zugriffskontrolle und Dokumentation. Kein Tool und keine Architektur garantiert für sich allein Compliance.
Wo die Daten liegen
Für europäische SaaS-Unternehmen ist der Standort der Kopie ebenso wichtig wie ihre Struktur. Beim Aufbau, bei Piloten und Tests nutzen wir selbst gehostete europäische Infrastruktur in Deutschland, und was wir bauen, geht an Sie über: Quellcode, Dokumentation und Infrastruktur. Siehe individuelle operative Software, in der EU gehostet und in Ihrem Besitz und warum der Besitz Ihrer operativen Systeme Lock-in vermeidet.
Unsere Sicht
Ein Data Warehouse ist ein Mittel. Das Ziel ist, dass Ihre CRM- und Finanzdaten übereinstimmen, dass die Verantwortlichen für Finanzen, Vertrieb und Customer Success eine Frage in einfachen Worten stellen und eine Antwort erhalten können, der sie vertrauen, und dass jemand für das Ergebnis verantwortlich ist.
Deshalb bauen wir in einer festen Reihenfolge: zuerst die Datengrundlage, dann die KI-Schicht, die sie liest, danach Agenten für die Fachbereiche. Kehren Sie die Reihenfolge um, erhalten Sie schnelle Antworten auf Daten, auf die sich niemand geeinigt hat. Unterschiedliche Aktualität für unterschiedliche Nutzer ist eine Designentscheidung, und sie sollte von einer Person getroffen werden, die Strategie und System versteht. Das ist die Rolle eines Fractional Chief AI Officer mit operativer Erfahrung.
Wir beginnen mit dem teuersten Prozess, messen ihn und bauen nur dort, wo sich KI auszahlt.
Claus Nielsen
Wie wir helfen können
Wenn KI in Ihrem Unternehmen bereits im Einsatz ist, aber niemand dafür verantwortlich ist, beginnen Sie mit einem Überblick darüber, wo sie sich auszahlt und was Ihre Daten tragen können. Das AI Readiness Assessment beginnt bei €4,500 als Einmalbetrag. Wenn Sie eine benannte Person möchten, die dauerhaft die Verantwortung für KI übernimmt, beginnt das Retainer für einen Fractional Chief AI Officer bei €3,000 pro Monat. Über unsere Website können Sie außerdem ein kostenloses 30-minütiges Erstgespräch buchen.
Builds werden entweder mit 30% der Einsparung im ersten Jahr berechnet, sobald diese gemessen und belegt ist, oder zu einem Festpreis, der vor Arbeitsbeginn vereinbart wird. Details finden Sie unter Preise.
FAQ
Ist ein operatives Data Warehouse dasselbe wie ein Operational Data Store?
Nicht ganz, auch wenn sich die Begriffe überschneiden. Ein ODS enthält aktuelle, detaillierte Daten aus mehreren Systemen für das operative Reporting. Ein Warehouse hält konsolidierte Historie für Analysen vor. Manche moderne Warehouses decken beide Aufgaben ab, weshalb Teams „operatives Data Warehouse“ oft für ein einziges System verwenden, das beides leistet.
Wie aktuell müssen Reporting-Daten sein?
Richten Sie es nach der Person oder dem System, das die Daten nutzt. Menschen, die Dashboards lesen, brauchen meist Daten, die Minuten bis Stunden alt sind. Nur automatisierte Aktionen auf sich schnell ändernden Daten brauchen in der Regel Sekunden. Legen Sie die Anforderung fest, bevor Sie Tools auswählen, denn jeder Schritt in Richtung Echtzeit erhöht Betriebskosten und operativen Aufwand.
Kann ich direkt aus meinem CRM- oder Abrechnungssystem berichten?
Bei einem einzelnen System und einem kleinen Team: ja. Sobald Sie CRM-, Finanz- und Produktdaten kombinieren oder umfangreiches Reporting die Systeme verlangsamt, in denen Ihre Mitarbeitenden arbeiten, trennt eine eigene Schicht das Reporting vom Tagesgeschäft und gibt Ihnen einen einheitlich abgestimmten Satz an Definitionen.
Macht mich ein Operational Data Store DSGVO-konform?
Kein Tool leistet das für sich allein. Eine Kopie personenbezogener Daten sind weiterhin personenbezogene Daten, daher gelten dafür Zugriffskontrolle, Protokollierung und eine Rechtsgrundlage. Sprechen Sie zu Ihrer konkreten Konstellation mit Ihrem Datenschutzbeauftragten oder Ihrer Rechtsberatung.
Quellen
- Überblick zum Operational Data Store
- Operational Data Store vs. Data Warehouse
- Data-Warehouse-Typen und -Architekturen
- Operational Data Stores: Zweck, Vorteile und Anwendungsfälle
- Moderner Ansatz für den Operational Data Store
- Architekturdesign von HTAP-Systemen
- So entwerfen Sie eine Echtzeit-Analytics-Architektur
- Echtzeit-Analytics: wann Sie sie brauchen und wann nicht
- Von Batch-Snapshots zu Daten in nahezu Echtzeit
- Datenpipeline in nahezu Echtzeit mit Change Data Capture
- TDWI-Bericht zum operativen Data Warehousing
- Operative Datenschicht vs. Data Warehouse
- Fractional CFO und Finanzberichtsdienstleistungen