Integration af vidensbase betyder at forbinde din dokumentation med de systemer, hvor dit team og dine kunder allerede arbejder: CRM, supportsystem, chat, finans og produkt. Gjort godt får folk det godkendte svar i det værktøj, de bruger, og AI-assistenter henter aktuelle oplysninger i stedet for at gætte. Gjort dårligt kopierer du forældet indhold til flere steder. Forskellen afhænger af tre beslutninger: hvilke kilder der er autoritative, hvem der må se hvad, og hvordan indholdet holdes opdateret.
Denne guide er skrevet til stiftere, COO'er og ledere af økonomi, salg og Customer Success i B2B SaaS-virksomheder med cirka 20 til 200 medarbejdere. Den dækker, hvad du skal forbinde, hvordan du vælger din kilde til sandhed, hvordan automatisering fungerer, hvordan AI kan bruge resultatet sikkert, og hvad europæiske regler betyder for designet.
Kort fortalt
- En integration af vidensbase placerer godkendte svar i CRM-poster, tickets, chat og AI-assistenter, så ingen skal skifte værktøj eller vedligeholde en ekstra kopi.
- Start med et kilderegister: Beslut, hvilket system der er autoritativt for hvilken type spørgsmål, og udelad forældet eller duplikeret indhold, før du forbinder noget.
- Behandl rettigheder som data. Alt, hvad en bruger ikke kan åbne i kildesystemet, må AI'en ikke hente for vedkommende.
- Automatisering bør finde huller og udarbejde udkast til opdateringer. Et menneske bør godkende, hvad der bliver publiceret.
- Under GDPR og EU's AI-forordning skal du fra første dag designe for datalokation, adgangskontrol og revisionsspor, og bede din juridiske rådgiver bekræfte, hvordan de gælder for dig.
Indholdsfortegnelse
- Hvad integration af vidensbase egentlig betyder
- Beslut først din kilde til sandhed
- Sådan integrerer du trin for trin
- Hvor automatisering af vidensbasen hjælper
- Sådan lader du AI bruge vidensbasen sikkert
- Hvor AI ikke hører hjemme
- GDPR, NIS2 og EU's AI-forordning i designet
- Perspektiv: Derfor bygger vi dataene først
- Arbejd sammen med NordOps Consulting
- En tjekliste før du går live
- FAQ
- Kilder
Hvad integration af vidensbase egentlig betyder
En vidensbase er i sig selv et bibliotek. En integration gør den til en service. I stedet for at bede folk besøge et hjælpecenter eller en wiki dukker den rette artikel eller det rette svar op i en CRM-post, en supportticket, en live chat, Slack eller Microsoft Teams eller en AI-chatbot. Et integrationsoverblik beskriver det som at bringe relevante artikler og dokumentation ind i de værktøjer, som kunder, agenter og teams allerede bruger.
For en SaaS-virksomhed er gevinsten praktisk:
- Supportmedarbejdere svarer hurtigere, fordi den godkendte artikel ligger lige ved siden af ticketten.
- Customer Success-managere ser den rette onboarding- eller produktvejledning på den konto, de arbejder med.
- Salg henter aktuelle produkt- og sikkerhedssvar ind i en deal i stedet for at spørge en kollega.
- Kunder finder svar i produktet eller i chatten, før de opretter en ticket.
- AI-assistenter henter godkendt indhold i stedet for at opfinde det.
Læg mærke til, hvad der mangler på den liste: et nyt værktøj. De bedste integrationer tilføjer ikke et nyt sted at kigge. De fjerner et.
Beslut først din kilde til sandhed
De fleste mislykkede integrationer mislykkes, før der er bygget en eneste connector. Virksomheden har den samme prisregel i en wikiside, et CRM-felt, en præsentation og en supportmakro, og de fire er uenige. Forbind alle fire til en AI-assistent, og den vil citere den, der rangerer højest.
En vidensbase i produktion henter typisk fra seks typer indhold ifølge en arkitekturguide: dokumentlagre, ticketsystemer, kodehosts, kommunikationsarkiver, strukturerede systems of record og eksternt autoritativt indhold. For en SaaS-virksomhed betyder de strukturerede systems of record mest: Dit CRM og dit finanssystem rummer de fakta, som andet indhold blot beskriver.
Byg et kilderegister
Før du forbinder noget, skal du skrive én linje pr. lager. Nyttige felter er:
- Ejer, en navngiven person, ikke et team.
- Målgruppe: kun intern, kundevendt eller partnervendt.
- Dataklassificering, herunder om det indeholder personoplysninger.
- Autoritativ for hvilke spørgsmål, og hvilke kilder der går forud, når de er uenige.
- Gennemgangsdato og opbevaringsperiode.
- Hvordan sletninger når frem til indekset.
Udeluk derefter det, der ikke skal være der: forældede udkast, duplikerede kopier, personlige noter og alt, hvis ejer ikke kan sige, om det stadig er korrekt.
Lad systems of record vinde
En enkel regel fungerer godt: Hvis et faktum findes i et struktureret system, vinder det strukturerede system. Kontraktværdi, fornyelsesdato, abonnement, fakturastatus og forbrug hører hjemme i CRM- og økonomidata. Artikler forklarer, hvordan de skal bruges eller fortolkes. De gentager dem aldrig.
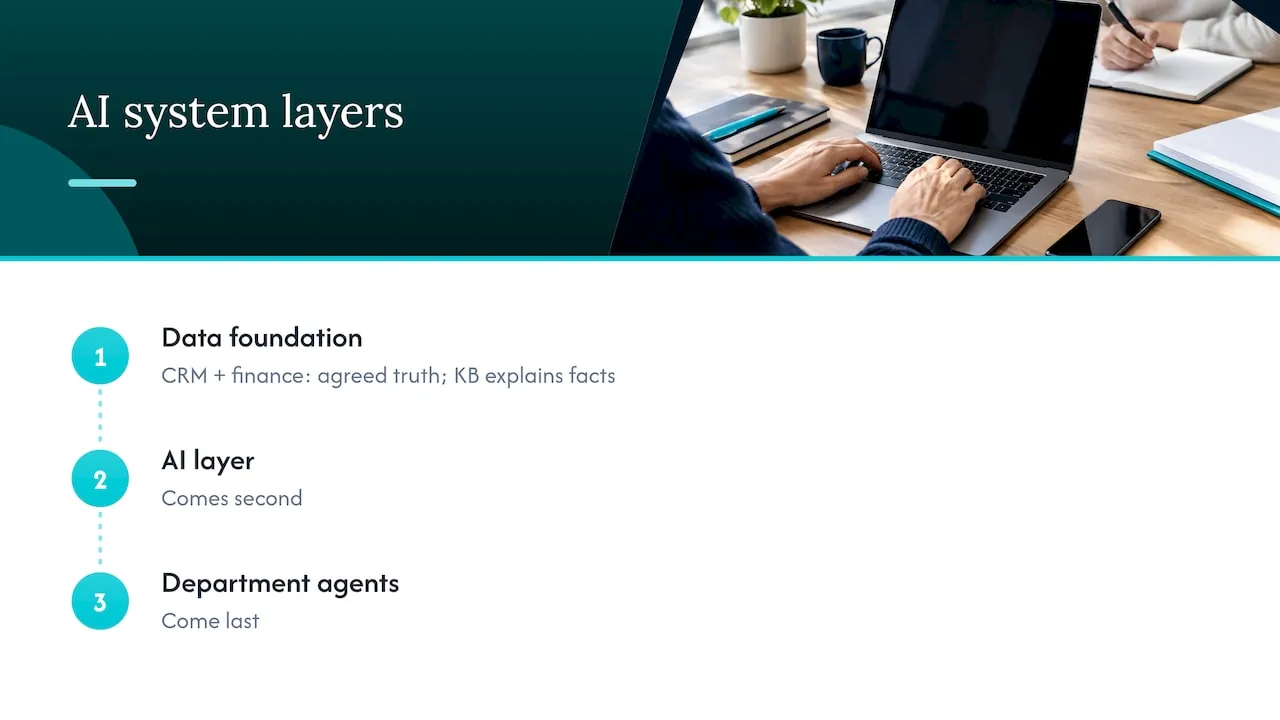
Det er samme rækkefølge, som vi bruger, når vi bygger AI til kunder. Datafundamentet kommer først: CRM- og økonomidata som den ene aftalte version af sandheden, forberedt af Processor. AI-laget kommer som nummer to. Afdelingsagenter kommer til sidst. En vidensbase sidder inde i den struktur som det forklarende lag oven på pålidelige data.
Sådan integrerer du trin for trin
En praktisk rækkefølge, baseret på de lag, som de fleste produktionsopsætninger har til fælles: connectors, transformation, chunking og indeksering, derefter hentning og generering.
- Gør kilderne op og rangér dem. Brug registret ovenfor.
- Forbind med den snævreste adgang. Giv hver connector de mindste rettigheder, den har brug for. Kun læseadgang, medmindre en arbejdsgang virkelig skriver tilbage.
- Rens og transformér. Fjern navigationsstøj, normalisér formater, og behold titler, ejere og datoer som metadata.
- Del op efter mening. Opdel indhold ved naturlige grænser som en procedure eller en politikklausul, ikke efter vilkårlige tegnantal.
- Indekser med metadata. Gem kilde, tidsstempel, målgruppe og et prioritetsflag, så hentning kan favorisere autoritativt indhold.
- Test hentning før generering. Stil 50 reelle spørgsmål fra din support- og salgshistorik, og kontrollér, om den rigtige passage kommer tilbage. Tilføj først derefter en AI, der skriver svar.
- Rul ud i etaper. Først intern forhåndsvisning, derefter en begrænset gruppe og derefter bredere brug.
Tag aktualitet og rettigheder med i dine acceptkriterier, ikke i en senere oprydning. “Det returnerer det rigtige svar” er ikke nok. “Det returnerer det rigtige, aktuelle svar, og kun til personer, der må se det” er testen.
Forandringsledelse betyder lige så meget som connectors. Folk skal vide, hvor svarene nu kommer fra, og hvem der retter et forkert svar. Træning i teamwork og samarbejde kan hjælpe teams med at blive enige om ejerskab og holde indhold synkroniseret på tværs af afdelinger, når opsætningen ændrer sig.
Hvor automatisering af vidensbasen hjælper
Automatisering er det sted, hvor en vidensbase holder op med at forfalde. Det meste indhold bliver forældet, ikke fordi folk er dovne, men fordi ingen får besked, når produktet har ændret sig.
De almindelige automatiseringsopgaver er:
- Udkast til nye artikler ud fra løste tickets, chatudskrifter eller udgivelsesnoter.
- Indfangning af svar, der dukker op i Slack-tråde eller supportsvar.
- Organisering af indhold ved at tagge det og finde næsten-dubletter.
- Levering af artikler i chat, i produktet eller via en AI-assistent.
- Opdatering af indhold ved at markere artikler, der er berørt af en produktændring, og skrive udkast til rettelser.
Det vigtige designvalg er, hvor mennesket sidder. En guide om selvopdaterende supportindhold fremhæver samme pointe: Den automatiske del er at opdage huller og skrive udkast til ændringer, og en person gennemgår dem, før noget går live. Vi bygger det på samme måde. Systemet foreslår, en navngiven ejer godkender.
Et mønster mere, som er værd at kende, er løkken, der skriver indsigt tilbage. Samtaler indfanges, omdannes til søgbar form, bruges til at besvare spørgsmål, og den nye viden skubbes tilbage i det førende system. Den løkke virker kun, hvis det førende system er rent fra start.
Hvis du vil se nærmere på én proces, hvor det betaler sig, kan du læse vores artikel om onboarding-automatisering for B2B SaaS.
Sådan lader du AI bruge vidensbasen sikkert
En AI-assistent, der er forbundet til din vidensbase, kan to ting: læse og handle. Begge dele kræver værn.
Læsning: rettigheder følger brugeren
Den mest almindelige alvorlige fejl er en assistent, der frembringer et dokument, som den person, der spørger, aldrig har fået lov til at åbne. Løsningen er at behandle rettigheder som data. En teknisk gennemgang af sikre integrationer anbefaler, at en agent forstår og afspejler kildesystemets rettighedsmodel, før den behandler nogen side, og at hentning filtrerer dokumenter på forespørgselstidspunktet efter den aktuelle brugers identitet. Den anbefaler også at opdatere adgangslister lige så ofte som indhold, for et dokument, der var begrænset i morges, bør ikke leveres i eftermiddag.
Microsofts offentliggjorte onboarding-runbook for Copilot-connectors giver en konkret regel, der er værd at kopiere uanset platform: Hold adgangen begrænset til personer, der allerede har den, i stedet for “Everyone”, og inkludér mindst én negativ test mod dit mest følsomme indhold, for eksempel begrænset HR-materiale. Hvis den test returnerer indhold, skal du stoppe udrulningen.
Handling: forankret, logget, afgrænset
Når en agent gør mere end at svare, for eksempel opdaterer en post eller udløser en proces, er mønsteret det samme. AWS beskriver en arbejdsgang med en forankret agent, hvor agenten finder frem til hensigten, slår politikken op i vidensbasen, kun kalder en handling, hvis anmodningen er berettiget, og gør alt dette inden for værn og med logning. Deres vejledning om forankring og hentning tilføjer governance-punkter, der er værd at sætte på din tjekliste: kvaliteten af kildedata, adgangskontrol efter identitet og rolle, versionering og aktualitetspolitikker, auditlogning og feedbackløkker til rettelser.
Vores eget design følger samme form: Agenter arbejder inden for rettigheder, beder om godkendelse, hvor handlingen har betydning, og efterlader et revisionsspor.
Færre forkerte svar
For spørgsmål, hvor du allerede har et verificeret svar, kan du helt springe generering over. AWS beskriver en verificeret semantisk cache, der returnerer et kurateret svar direkte, når en forespørgsel ligger tæt på et kendt spørgsmål, og kun falder tilbage på modellen ved forespørgsler med lav lighed. Princippet gælder bredt: Hvor der findes et godkendt svar, skal det leveres.
Hvor AI ikke hører hjemme
At være eksplicit om grænser gør en integration sikrere og billigere.
- Priser, rabatter og kontraktvilkår. Lever dem fra CRM- eller økonomiposten, eller send videre til en person. Lad ikke en model omskrive dem.
- Beslutninger, der påvirker menneskers rettigheder eller levebrød, såsom ansættelse eller kreditvurdering. EU AI Act behandler visse systemer på disse områder som højrisiko med strengere forpligtelser.
- Juridisk, skattemæssig og medicinsk rådgivning. Hentning kan pege på den godkendte tekst. Den bør ikke fortolke den.
- Indhold uden ejer. Hvis ingen person kan stå inde for et dokument, hører det ikke hjemme i indekset.
- Publicering uden gennemgang. AI kan skrive udkast. Et menneske udgiver.
- Bred, uafgrænset adgang. En assistent, der kan se alt, er et databrud, der venter på det rette spørgsmål.
Indfør én proces ad gangen, og start med den dyreste. Supportaflastning eller sikkerhedsspørgeskemaer i salg er ofte gode første kandidater, fordi volumen er høj, og de godkendte svar allerede findes.
GDPR, NIS2 og EU's AI-forordning i designet
Hvis din vidensbase berører personoplysninger om personer i EU, bør designet tage højde for europæiske regler fra begyndelsen frem for efter lanceringen. Overordnet gælder følgende:
- GDPR gælder, når personoplysninger om personer i EU behandles. Det omfatter kunders navne, e-mailadresser og indholdet af tickets i dit indeks. Overvej, hvor data lagres og behandles, hvilke leverandører der er databehandlere og kræver en databehandleraftale, hvor længe indhold opbevares, og hvordan du sletter én persons data både i kilden og i indekset.
- Formålsbegrænsning er vigtig, når en leverandør er involveret. Kontrollér, at indhold, du indekserer til søgning, ikke genbruges til at træne leverandørens egne modeller.
- EU's AI-forordning (EU AI Act) fastsætter forpligtelser efter risikokategori. Mange brugsscenarier for vidensbaser, f.eks. besvarelse af produktspørgsmål, har lavere risiko, men gennemsigtighedskravene og højrisikokategorierne bør stadig gennemgås.
- NIS2 handler om styring af cybersikkerhedsrisici for enheder inden for anvendelsesområdet. Om din virksomhed er omfattet, er et spørgsmål til din juridiske rådgiver.
Disse regelsæt overlapper i praksis. Adgangskontrol, logning og dokumenterede risikovurderinger tjener flere af dem på samme tid. Intet af dette er juridisk rådgivning, og ingen arkitektur kan garantere overholdelse af reglerne. Lad din jurist eller databeskyttelsesrådgiver bekræfte, hvad der gælder for dig. Vores AI-governance-ramme for B2B SaaS gennemgår den praktiske side.
Perspektiv: Derfor bygger vi dataene først
Vi bliver spurgt om vidensbaser, når noget allerede er gået galt: en assistent citerede sidste års priser, en supportmedarbejder indsatte et svar, der stred mod kontrakten, eller nogen fandt et internt dokument i et chatsvar.
I næsten alle tilfælde var vidensbasen ikke problemet. Problemet var, at ingen ejede sandheden. CRM-systemet sagde én ting, økonomisystemet en anden og wikien en tredje. At forbinde en AI-assistent til alle tre gjorde blot uenigheden hurtigere.
Derfor arbejder vi i en fast rækkefølge. Først datafundamentet: CRM- og økonomidata gjort til én aftalt version af sandheden. Derefter AI-laget, som forbinder disse data med den assistent, jeres virksomhed allerede bruger. Til sidst afdelingsagenter til Finance, Sales og Customer Success, som jeres egne medarbejdere bruger i almindeligt sprog, inden for tilladelser, med godkendelse, hvor det er vigtigt, og et revisionsspor.
Vi siger også, hvor AI bør holde sig væk: kontraktvilkår, beslutninger om mennesker og alt indhold uden en ejer. En vidensbase er nyttig, når den er afgrænset, opdateret og styret af tilladelser. Den er en belastning, når den er stor og uden ejer.
Virksomheden beholder det, vi bygger: kildekode, dokumentation og infrastruktur overdrages ved afleveringen, og opbygning, pilot og test foregår på selvhostet europæisk infrastruktur i Tyskland.
Claus Nielsen
Arbejd sammen med NordOps Consulting
Hvis jeres team allerede bruger AI, men ingen ejer det, er første skridt som regel et klart billede af jeres data og af, hvor AI kan betale sig. Vores AI Readiness Assessment starter fra €4,500 og ser på jeres datafundament, jeres processer og jeres regulatoriske position. Til løbende ejerskab starter Fractional Chief AI Officer-aftalen fra €1,500 pr. måned på Advisor-niveau, fra €3,250 på Operating-niveau og fra €5,500 på Embedded-niveau.
Opbygninger prissættes til 30% af det første års besparelse, når den er målt og bevist, eller til en fast pris aftalt før arbejdet starter. Du kan se hele listen på prissiden eller starte med en gratis introduktionssamtale på 30 minutter. Vores AI-agenter til Finance, Sales og Customer Success viser, hvordan afdelingslaget ser ud, når data er i orden.
En tjekliste før du går live
- Hver kilde har en navngiven ejer, en målgruppe og en gennemgangsdato.
- For hver spørgsmålstype er én kilde markeret som autoritativ.
- Connectorer bruger de snævreste scopes og som standard skrivebeskyttet adgang.
- Tilladelser synkroniseres lige så ofte som indhold, og sletninger når frem til indekset.
- En negativ test mod jeres mest følsomme indhold bestås.
- Hentning testes på rigtige spørgsmål, før nogen model skriver svar.
- AI udarbejder udkast, mennesker udgiver.
- Handlinger logges og kræver godkendelse, hvor indsatsen er høj.
- Datalokation, databehandlere og opbevaringsperioder er dokumenteret og gennemgået af jeres juridiske rådgiver.
- Nogen ejer løsningen efter lanceringen.
FAQ
Hvad er formålet med en integration af en vidensbase?
Den placerer godkendte svar i de værktøjer, folk allerede bruger, såsom CRM, supportsystem, chat og AI-assistenter. Det sparer tid på at skifte mellem værktøjer og undgår vedligeholdelse af dublerede kopier. Det giver også AI en kontrolleret kilde at hente fra.
Hvad kan en vidensbase forbindes til?
Almindelige kilder er dokumentlagre, ticketsystemer, kommunikationsværktøjer, kodehoteller og strukturerede systemer med autoritative data, såsom CRM og økonomi. For SaaS-virksomheder bør disse systemer være autoriteten for fakta som abonnement, pris og fornyelsesdato. Artikler forklarer, og registre fastslår.
Kan opdateringer af vidensbasen automatiseres fuldt ud?
Registrering og udarbejdelse af udkast kan automatiseres: at finde huller, foreslå nye artikler og markere forældede. Udgivelse bør blive hos en navngiven reviewer, især for alt kundevendt indhold og alt, som en AI vil citere.
Hvordan forhindrer vi, at en AI-assistent afslører begrænsede dokumenter?
Overfør kildesystemets tilladelser til indekset, og filtrér resultater efter identiteten på den, der spørger. Opdatér tilladelser lige så ofte som indhold, og kør en negativ test på jeres mest følsomme materiale før lanceringen.
Kræver dette en juridisk gennemgang i Europa?
Ja, i praksis. GDPR, NIS2 og EU's AI-forordning (EU AI Act) kan hver især gælde afhængigt af jeres data og jeres brugsscenarie. En juridisk rådgiver eller databeskyttelsesrådgiver bør bekræfte, hvad der gælder for jer.
Kilder
- Integrationer af vidensbaser: arkitektur og test
- Enterprise-vidensbase til AI: arkitekturguide
- En AI-supportvidensbase, der opdaterer sig selv
- Byg sikre integrationer af vidensbaser til AI-agenter (DZone)
- Microsoft Copilot Connector Knowledge Onboarding Runbook
- AWS Prescriptive Guidance: Grounded agent AI workflow
- AWS Prescriptive Guidance: Grounding and Retrieval Augmented Generation
- AWS Machine Learning Blog: Reduktion af hallucinationer med en verificeret semantisk cache