Integration av kunskapsbas innebär att koppla ihop din dokumentation med de system där ditt team och dina kunder redan arbetar: CRM, supportsystem, chatt, ekonomi och produkt. Görs det väl får människor det godkända svaret i det verktyg de redan använder, och AI-assistenter hämtar aktuell information i stället för att gissa. Görs det dåligt kopierar du inaktuellt innehåll till fler platser. Skillnaden avgörs av tre beslut: vilka källor som är auktoritativa, vem som får se vad och hur innehållet hålls aktuellt.
Den här guiden är skriven för grundare, COO:er och chefer för ekonomi, försäljning och Customer Success på B2B SaaS-företag med ungefär 20 till 200 medarbetare. Den tar upp vad som ska kopplas ihop, hur du väljer din sanningskälla, hur automatisering fungerar, hur AI kan använda resultatet på ett säkert sätt och vad europeiska regler innebär för utformningen.
Kort sagt
- En integration av kunskapsbasen placerar godkända svar i CRM-poster, ärenden, chatt och AI-assistenter, så att ingen behöver byta verktyg eller underhålla en andra kopia.
- Börja med ett källregister: bestäm vilket system som är auktoritativt för vilken typ av fråga, och uteslut inaktuellt eller duplicerat innehåll innan du kopplar ihop något.
- Behandla behörigheter som data. Det en användare inte kan öppna i källsystemet får AI:n inte hämta åt den användaren.
- Automatisering bör upptäcka luckor och skriva utkast till uppdateringar. En människa bör godkänna det som publiceras.
- Utforma enligt GDPR och EU:s AI-förordning med datalagringsplats, åtkomstkontroll och revisionsspår från första dagen, och be din juridiska rådgivare bekräfta hur de gäller för dig.
Innehållsförteckning
- Vad integration av kunskapsbas faktiskt innebär
- Bestäm din sanningskälla först
- Så integrerar du steg för steg
- Där automatisering av kunskapsbasen hjälper
- Låt AI använda kunskapsbasen på ett säkert sätt
- Där AI inte hör hemma
- GDPR, NIS2 och EU:s AI-förordning i designen
- Perspektiv: därför bygger vi datan först
- Arbeta med NordOps Consulting
- En checklista innan ni går live
- FAQ
- Källor
Vad integration av kunskapsbas faktiskt innebär
En kunskapsbas i sig är ett bibliotek. En integration gör den till en tjänst. I stället för att be människor besöka ett hjälpcenter eller en wiki dyker rätt artikel eller rätt svar upp i en CRM-post, ett supportärende, en livechatt, Slack eller Microsoft Teams, eller en AI-chattbot. En integrationsöversikt beskriver detta som att föra in relevanta artiklar och dokumentation i de verktyg som kunder, agenter och team redan använder.
För ett SaaS-företag är nyttan konkret:
- Supportagenter svarar snabbare eftersom den godkända artikeln finns bredvid ärendet.
- Customer Success-managers ser rätt onboarding- eller produktvägledning på det konto de arbetar med.
- Försäljning hämtar aktuella produkt- och säkerhetssvar in i en affär i stället för att fråga en kollega.
- Kunder hittar svar i produkten eller i chatten innan de öppnar ett ärende.
- AI-assistenter hämtar godkänt innehåll i stället för att hitta på.
Lägg märke till vad som saknas i den listan: ett nytt verktyg. De bästa integrationerna lägger inte till någon ny plats att leta på. De tar bort en.
Bestäm din sanningskälla först
De flesta misslyckade integrationer misslyckas innan någon koppling ens är byggd. Företaget har samma prisregel i en wikisida, ett CRM-fält, en presentation och ett supportmakro, och de fyra säger emot varandra. Koppla alla fyra till en AI-assistent så citerar den den som rankas högst.
En kunskapsbas i produktion hämtar enligt en arkitekturguide vanligtvis innehåll från sex familjer: dokumentarkiv, ärendehanteringssystem, kodplattformar, kommunikationsarkiv, strukturerade register- och affärssystem samt externt auktoritativt innehåll. För ett SaaS-företag är de strukturerade systemen viktigast: ditt CRM och ditt ekonomisystem innehåller de fakta som annat innehåll bara beskriver.
Bygg ett källregister
Innan du kopplar ihop något, skriv en rad per arkiv. Användbara fält är bland annat:
- Ägare, en namngiven person, inte ett team.
- Målgrupp: endast internt, kundvänt eller partnervänt.
- Dataklassificering, inklusive om det innehåller personuppgifter.
- Auktoritativ för vilka frågor, och vilka källor som väger tyngre när de säger emot varandra.
- Granskningsdatum och lagringstid.
- Hur borttagningar når indexet.
Uteslut sedan det som inte ska finnas där: föråldrade utkast, dubbletter, personliga anteckningar och allt vars ägare inte kan säga om det fortfarande stämmer.
Låt systemen med de ursprungliga uppgifterna vinna
En enkel regel fungerar bra: om ett faktum finns i ett strukturerat system gäller det strukturerade systemet. Kontraktsvärde, förnyelsedatum, abonnemang, fakturastatus och användning hör hemma i CRM- och ekonomidata. Artiklar förklarar hur de används eller tolkas. De återger dem aldrig.
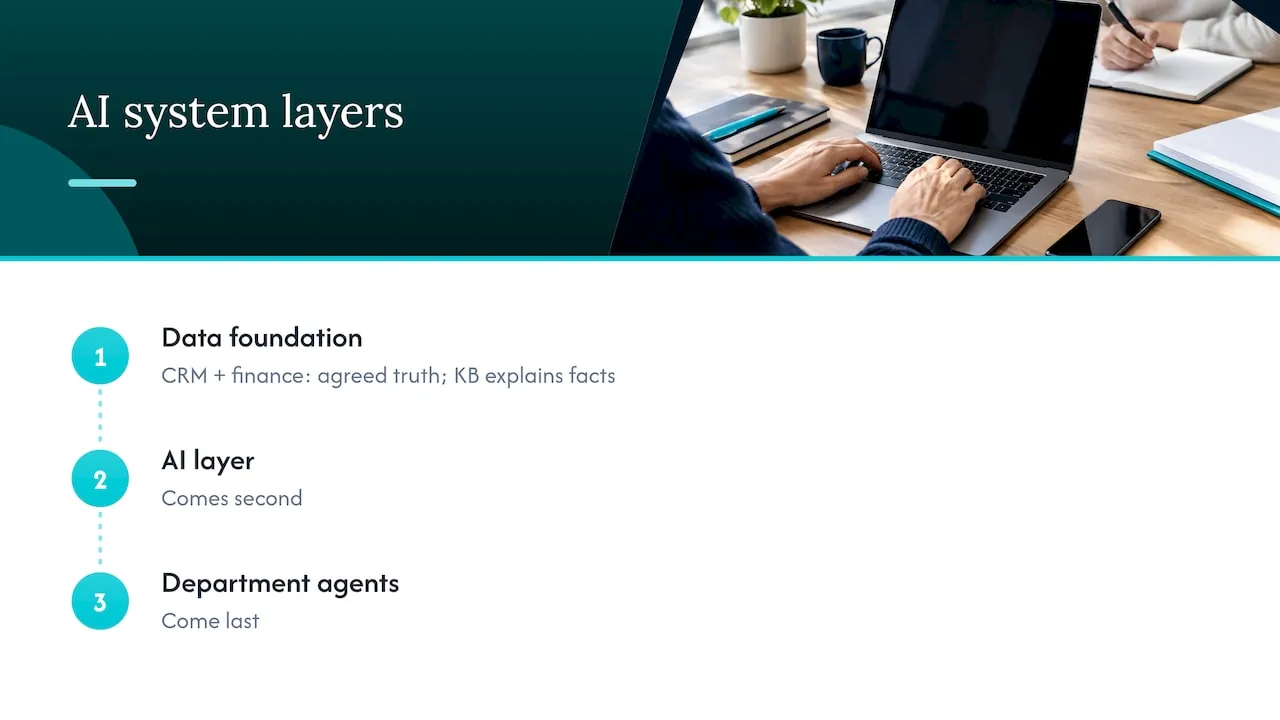
Det är samma ordning som vi använder när vi bygger AI åt kunder. Datagrunden kommer först: CRM- och ekonomidata som den enda överenskomna versionen av sanningen, förberedd av Processor. AI-lagret kommer därefter. Avdelningsagenterna kommer sist. En kunskapsbas ingår i den strukturen som det förklarande lagret ovanpå tillförlitliga data.
Så integrerar du steg för steg
En praktisk ordning, baserad på de lager som de flesta produktionsmiljöer har gemensamt: kopplingar, transformering, uppdelning i segment och indexering, därefter sökning och generering.
- Inventera och rangordna källor. Använd registret ovan.
- Anslut med snävast möjliga åtkomst. Ge varje koppling de minsta behörigheter den behöver. Endast läsåtkomst, såvida inte ett arbetsflöde verkligen skriver tillbaka.
- Rensa och transformera. Ta bort onödig navigering, normalisera format och behåll titlar, ägare och datum som metadata.
- Dela upp efter innebörd. Dela innehållet vid naturliga gränser, till exempel en rutin eller en policyklausul, inte vid godtyckliga teckenantal.
- Indexera med metadata. Lagra källa, tidsstämpel, målgrupp och en prioritetsflagga så att sökningen kan gynna auktoritativt innehåll.
- Testa sökningen före genereringen. Ställ 50 verkliga frågor från er support- och säljhistorik och kontrollera om rätt avsnitt kommer tillbaka. Lägg först därefter till en AI som skriver svar.
- Inför stegvis. Först intern förhandsvisning, sedan en begränsad grupp och därefter bredare användning.
Ta med aktualitet och behörigheter i era acceptanskriterier, inte i en senare uppstädning. ”Den ger rätt svar” räcker inte. Testet är: ”Den ger rätt, aktuellt svar, och bara till personer som får se det.”
Förändringsledning är lika viktigt som kopplingar. Människor behöver veta varifrån svaren nu kommer och vem som rättar ett felaktigt svar. Utbildning i teamwork och samarbete kan hjälpa team att enas om ansvar och hålla innehållet synkroniserat mellan avdelningar när upplägget förändras.
Där automatisering av kunskapsbasen hjälper
Automatisering är det som hindrar en kunskapsbas från att förfalla. Det mesta innehållet blir inaktuellt, inte för att människor är slarviga, utan för att ingen får veta när produkten har ändrats.
De vanligaste automatiseringsuppgifterna är:
- Utkast till nya artiklar utifrån lösta ärenden, chattutskrifter eller versionsanteckningar.
- Fånga upp svar som dyker upp i Slack-trådar eller supportsvar.
- Organisera innehåll genom att tagga det och hitta nästan identiska dubbletter.
- Leverera artiklar i chatten, i produkten eller via en AI-assistent.
- Uppdatera innehåll genom att flagga artiklar som påverkas av en produktändring och ta fram utkast till ändringar.
Det viktiga designvalet är var människan placeras. En guide om självuppdaterande supportinnehåll framhåller samma sak: den automatiska delen är att upptäcka luckor och ta fram utkast till ändringar, och en person granskar innan något publiceras. Vi bygger det på samma sätt. Systemet föreslår, en namngiven ägare godkänner.
Ytterligare ett mönster värt att känna till är slingan som skriver tillbaka insikter. Samtal fångas upp, omvandlas till sökbar form, används för att besvara frågor, och den nya kunskapen skickas tillbaka till journalsystemet. Den slingan fungerar bara om det ledande systemet är rent från början.
Om du vill se närmare på en process där detta lönar sig, läs vår artikel om automatiserad onboarding för B2B SaaS.
Låt AI använda kunskapsbasen på ett säkert sätt
En AI-assistent kopplad till er kunskapsbas kan göra två saker: läsa och agera. Båda kräver skyddsräcken.
Läsa: behörigheter följer användaren
Det vanligaste allvarliga felet är en assistent som visar ett dokument som personen som frågar aldrig fick öppna. Lösningen är att behandla behörigheter som data. En teknisk genomgång av säkra integrationer rekommenderar att en agent förstår och återger källsystemets behörighetsmodell innan den behandlar någon sida, och att sökningen filtrerar dokument vid förfrågan utifrån den aktuella användarens identitet. Den råder också till att uppdatera åtkomstlistor lika ofta som innehållet, eftersom ett dokument som var begränsat i morse inte ska visas i eftermiddag.
Microsofts publicerade onboarding-runbook för Copilot-kopplingar ger en konkret regel som är värd att kopiera oavsett plattform: begränsa åtkomsten till personer som redan har den i stället för ”Alla”, och inkludera minst ett negativt test mot ert känsligaste innehåll, till exempel begränsat HR-material. Om testet returnerar innehåll ska driftsättningen stoppas.
Agera: förankrat, loggat, avgränsat
När en agent gör mer än att svara, till exempel uppdaterar en post eller utlöser en process, gäller samma mönster. AWS beskriver ett förankrat agentarbetsflöde där agenten tar reda på avsikten, slår upp policyn i kunskapsbasen, anropar en åtgärd endast om begäran är giltig, och gör allt detta inom skyddsräcken och med loggning. Deras vägledning om förankring och sökning lägger till styrningspunkter som är värda att ha på er checklista: kvaliteten på källdata, åtkomstkontroll utifrån identitet och roll, versionshantering och aktualitetspolicyer, granskningsloggning och återkopplingsslingor för rättelser.
Vår egen design följer samma form: agenter arbetar inom behörigheter, ber om godkännande där åtgärden spelar roll och lämnar ett revisionsspår.
Minska felaktiga svar
För frågor där ni redan har ett verifierat svar kan ni hoppa över genereringen helt. AWS beskriver en verifierad semantisk cache som returnerar ett kurerat svar direkt när en fråga ligger nära en känd fråga, och som endast faller tillbaka på modellen för frågor med låg likhet. Principen gäller brett: där ett godkänt svar finns, ge det.
Där AI inte hör hemma
Att vara tydlig med gränserna gör en integration säkrare och billigare.
- Priser, rabatter och avtalsvillkor. Hämta dessa från CRM- eller ekonomiposten, eller hänvisa till en person. Låt inte en modell omformulera dem.
- Beslut som påverkar människors rättigheter eller försörjning, till exempel rekrytering eller kreditbedömning. EU:s AI-förordning (EU AI Act) betraktar vissa system inom dessa områden som högrisk, med strängare krav.
- Juridisk, skattemässig och medicinsk rådgivning. Sökningen kan peka på den godkända texten. Den ska inte tolka den.
- Innehåll som ingen äger. Om ingen person kan gå i god för ett dokument hör det inte hemma i indexet.
- Ogranskad publicering. AI kan ta fram utkast. En människa publicerar.
- Bred åtkomst utan avgränsning. En assistent som kan se allt är ett dataintrång som väntar på rätt fråga.
Inför en process i taget och börja med den dyraste. Supportavlastning eller säkerhetsenkäter i försäljningen är ofta bra första kandidater, eftersom volymen är hög och de godkända svaren redan finns.
GDPR, NIS2 och EU:s AI-förordning i designen
Om er kunskapsbas berör personuppgifter om personer i EU bör utformningen ta hänsyn till europeiska regler från början, snarare än efter lansering. I allmänna termer:
- GDPR gäller när personuppgifter om personer i EU behandlas. Det omfattar kundnamn, e-postadresser och ärendeinnehåll i ert index. Tänk på var data lagras och behandlas, vilka leverantörer som är personuppgiftsbiträden och kräver ett personuppgiftsbiträdesavtal, hur länge innehåll sparas och hur ni raderar en persons data både ur källan och ur indexet.
- Ändamålsbegränsning är viktig när en leverantör är inblandad. Kontrollera att innehåll som ni indexerar för sökning inte återanvänds för att träna leverantörens egna modeller.
- EU:s AI-förordning (EU AI Act) ställer krav utifrån riskkategori. Många användningsområden för kunskapsbaser, som att besvara produktfrågor, har lägre risk, men transparenskraven och högriskkategorierna behöver ändå ses över.
- NIS2 gäller hantering av cybersäkerhetsrisker för verksamheter som omfattas. Om ert företag omfattas är en fråga för er juridiska rådgivare.
Dessa regelverk överlappar varandra i praktiken. Åtkomstkontroll, loggning och dokumenterade riskbedömningar tjänar flera av dem samtidigt. Inget av detta är juridisk rådgivning, och ingen arkitektur garanterar efterlevnad. Låt er jurist eller ert dataskyddsombud bekräfta vad som gäller för er. Vårt ramverk för AI-styrning för B2B SaaS går igenom den praktiska sidan.
Perspektiv: därför bygger vi datan först
Vi får frågor om kunskapsbaser när något redan har gått fel: en assistent citerade förra årets priser, en supportmedarbetare klistrade in ett svar som motsade avtalet, eller någon hittade ett internt dokument i ett chattsvar.
I nästan alla fall var kunskapsbasen inte problemet. Problemet var att ingen ägde sanningen. CRM-systemet sa en sak, ekonomisystemet en annan och wikin en tredje. Att koppla en AI-assistent till alla tre gjorde helt enkelt att oenigheten spreds snabbare.
Därför arbetar vi i en fast ordning. Först datagrunden: CRM- och ekonomidata samlade till en gemensamt överenskommen version av sanningen. Sedan AI-lagret, som kopplar den datan till den assistent som ert företag redan använder. Därefter avdelningsagenter för Finance, Sales och Customer Success som era egna medarbetare använder på vanligt språk, inom ramen för behörigheter, med godkännande där det behövs och ett revisionsspår.
Vi säger också var AI bör hållas utanför: avtalsvillkor, beslut om människor och allt innehåll som saknar ägare. En kunskapsbas är användbar när den är avgränsad, aktuell och behörighetsstyrd. Den är en belastning när den är stor och utan ägare.
Företaget behåller det vi bygger: källkod, dokumentation och infrastruktur överlämnas vid leverans, och bygge, pilot och testning körs på egenhostad europeisk infrastruktur i Tyskland.
Claus Nielsen
Arbeta med NordOps Consulting
Om ert team redan använder AI men ingen äger frågan är första steget oftast en tydlig bild av er data och av var AI lönar sig. Vår AI Readiness Assessment startar från €4,500 och granskar er datagrund, era processer och er regulatoriska situation. För löpande ansvar startar abonnemanget för Fractional Chief AI Officer från €1,500 per månad på nivån Advisor, från €3,250 på nivån Operating och från €5,500 på nivån Embedded.
Byggen prissätts till 30% av första årets besparing, när den har mätts och bevisats, eller till ett fast pris som överenskoms innan arbetet börjar. Hela listan finns på prissidan, eller så börjar ni med ett kostnadsfritt upptäcktssamtal på 30 minuter. Våra AI-agenter för Finance, Sales och Customer Success visar hur avdelningslagret ser ut när datan är i ordning.
En checklista innan ni går live
- Varje källa har en namngiven ägare, en målgrupp och ett granskningsdatum.
- För varje frågetyp är en källa markerad som auktoritativ.
- Anslutningar använder snävast möjliga behörighetsomfång och skrivskyddad åtkomst som standard.
- Behörigheter synkas lika ofta som innehållet, och raderingar når indexet.
- Ett negativt test mot ert känsligaste innehåll godkänns.
- Sökning och hämtning testas på verkliga frågor innan någon modell skriver svar.
- AI skriver utkast, människor publicerar.
- Åtgärder loggas och kräver godkännande där insatserna är höga.
- Dataplacering, personuppgiftsbiträden och lagringstid är dokumenterade och granskade av er juridiska rådgivare.
- Någon äger lösningen efter lansering.
FAQ
Vad är syftet med en integration av en kunskapsbas?
Den för in godkända svar i de verktyg som människor redan använder, som CRM, supportsystem, chatt och AI-assistenter. Det sparar tid som annars går åt till att växla mellan verktyg och undviker att dubbla kopior måste underhållas. Det ger också AI en kontrollerad källa att hämta från.
Vad kan en kunskapsbas kopplas till?
Vanliga källor är dokumentarkiv, ärendesystem, kommunikationsverktyg, kodplattformar och strukturerade registersystem som CRM och ekonomi. För SaaS-företag bör registersystemen vara auktoriteten för fakta som abonnemang, pris och förnyelsedatum. Artiklar förklarar, och register fastslår.
Kan uppdateringar av en kunskapsbas automatiseras helt?
Upptäckt och utkast kan automatiseras: att hitta luckor, föreslå nya artiklar och flagga inaktuella. Publicering bör ligga kvar hos en namngiven granskare, särskilt för allt som är kundvänt eller som en AI kommer att citera.
Hur hindrar vi en AI-assistent från att exponera begränsade dokument?
För över källsystemets behörigheter till indexet och filtrera resultaten utifrån identiteten hos den som frågar. Uppdatera behörigheter lika ofta som innehåll och kör ett negativt test på ert känsligaste material före lansering.
Krävs en juridisk granskning i Europa?
Ja, i praktiken. GDPR, NIS2 och EU:s AI-förordning (EU AI Act) kan var och en vara tillämpliga beroende på er data och ert användningsområde. En juridisk rådgivare eller ett dataskyddsombud bör bekräfta vad som gäller för er.
Källor
- Integrationer för kunskapsbaser: arkitektur och testning
- Enterprise Knowledge Base for AI: Architecture Guide
- AI Support Knowledge Base That Updates Itself
- Build Secure Knowledge Base Integrations for AI Agents (DZone)
- Microsoft Copilot Connector Knowledge Onboarding Runbook
- AWS Prescriptive Guidance: Grounded agent AI workflow
- AWS Prescriptive Guidance: Grounding and Retrieval Augmented Generation
- AWS Machine Learning Blog: Minska hallucinationer med en verifierad semantisk cache