Integrar a base de conhecimento significa ligar a sua documentação aos sistemas onde a sua equipa e os seus clientes já trabalham: CRM, helpdesk de suporte, chat, finanças e produto. Quando bem feita, as pessoas recebem a resposta aprovada dentro da ferramenta que estão a utilizar, e os assistentes de IA obtêm informação atual em vez de adivinhar. Quando mal feita, copia-se conteúdo desatualizado para mais locais. A diferença resume-se a três decisões: que fontes são autoritativas, quem pode ver o quê e como o conteúdo se mantém atualizado.
Este guia destina-se a fundadores, COO e responsáveis de Finanças, Vendas e Customer Success em empresas de SaaS B2B com cerca de 20 a 200 pessoas. Abrange o que ligar, como escolher a sua fonte de verdade, como funciona a automatização, como a IA pode usar o resultado em segurança e o que as regras europeias significam para a conceção.
Em resumo
- Uma integração da base de conhecimento coloca respostas aprovadas nos registos do CRM, nos tickets, no chat e nos assistentes de IA, para que ninguém tenha de mudar de ferramenta nem de manter uma segunda cópia.
- Comece por um registo de fontes: decida que sistema é autoritativo para cada tipo de pergunta e exclua o conteúdo desatualizado ou duplicado antes de ligar seja o que for.
- Trate as permissões como dados. Tudo o que um utilizador não consegue abrir no sistema de origem, a IA não deve obter para ele.
- A automatização deve detetar lacunas e redigir atualizações. Uma pessoa deve aprovar o que é publicado.
- Ao abrigo do RGPD e do EU AI Act, planeie desde o primeiro dia a localização dos dados, o controlo de acessos e os registos de auditoria, e peça ao seu consultor jurídico que confirme como se aplicam ao seu caso.
Índice
- O que significa realmente integrar a base de conhecimento
- Decida primeiro a sua fonte de verdade
- Como integrar passo a passo
- Onde a automatização da base de conhecimento ajuda
- Permitir que a IA use a base de conhecimento em segurança
- Onde a IA não deve ser usada
- RGPD, NIS2 e EU AI Act na conceção
- Perspetiva: porque construímos primeiro os dados
- Trabalhe com a NordOps Consulting
- Uma lista de verificação antes de entrar em produção
- FAQ
- Fontes
O que significa realmente integrar a base de conhecimento
Uma base de conhecimento isolada é uma biblioteca. Uma integração transforma-a num serviço. Em vez de pedir às pessoas que visitem um centro de ajuda ou uma wiki, o artigo ou a resposta certa surge num registo do CRM, num ticket de suporte, num chat em direto, no Slack ou no Microsoft Teams, ou num chatbot de IA. Uma visão geral de integrações descreve isto como levar artigos e documentação relevantes para as ferramentas que clientes, agentes e equipas já utilizam.
Para uma empresa de SaaS, o benefício é prático:
- Os agentes de suporte respondem mais depressa porque o artigo aprovado está ao lado do ticket.
- Os gestores de Customer Success veem a orientação certa de onboarding ou de produto na conta em que estão a trabalhar.
- As Vendas obtêm respostas atuais sobre produto e segurança para um negócio em vez de perguntarem a um colega.
- Os clientes encontram respostas no produto ou no chat antes de abrirem um ticket.
- Os assistentes de IA obtêm conteúdo aprovado em vez de o inventarem.
Repare no que falta nessa lista: uma nova ferramenta. As melhores integrações não acrescentam nenhum novo sítio onde procurar. Eliminam um.
Decida primeiro a sua fonte de verdade
A maioria das integrações falhadas falha antes de qualquer conector ser construído. A empresa tem a mesma regra de preços numa página de wiki, num campo do CRM, numa apresentação e numa macro de suporte, e as quatro não coincidem. Ligue as quatro a um assistente de IA e ele citará a que aparecer em primeiro lugar.
Segundo um guia de arquitetura, uma base de conhecimento em produção recorre tipicamente a seis famílias de conteúdo: repositórios de documentos, sistemas de ticketing, repositórios de código, arquivos de comunicação, sistemas de registo estruturados e conteúdo externo autoritativo. Para uma empresa de SaaS, os sistemas de registo estruturados são os mais importantes: o seu CRM e o seu sistema financeiro contêm os factos que o restante conteúdo apenas descreve.
Construa um registo de fontes
Antes de ligar seja o que for, escreva uma linha por repositório. Campos úteis incluem:
- Responsável: uma pessoa identificada, não uma equipa.
- Público: apenas interno, para clientes ou para parceiros.
- Classificação dos dados, incluindo se contêm dados pessoais.
- Autoritativo para que perguntas e que fontes prevalecem sobre ele em caso de conflito.
- Data de revisão e prazo de conservação.
- Como as eliminações chegam ao índice.
Depois, exclua o que não deve lá estar: rascunhos desatualizados, cópias duplicadas, notas pessoais e tudo aquilo cujo responsável não consiga dizer se ainda está correto.
Deixe os sistemas de registo prevalecer
Uma regra simples funciona bem: se um facto está num sistema estruturado, o sistema estruturado prevalece. O valor do contrato, a data de renovação, o plano, o estado da fatura e a utilização pertencem aos dados de CRM e de finanças. Os artigos explicam como os usar ou interpretar. Nunca os repetem.
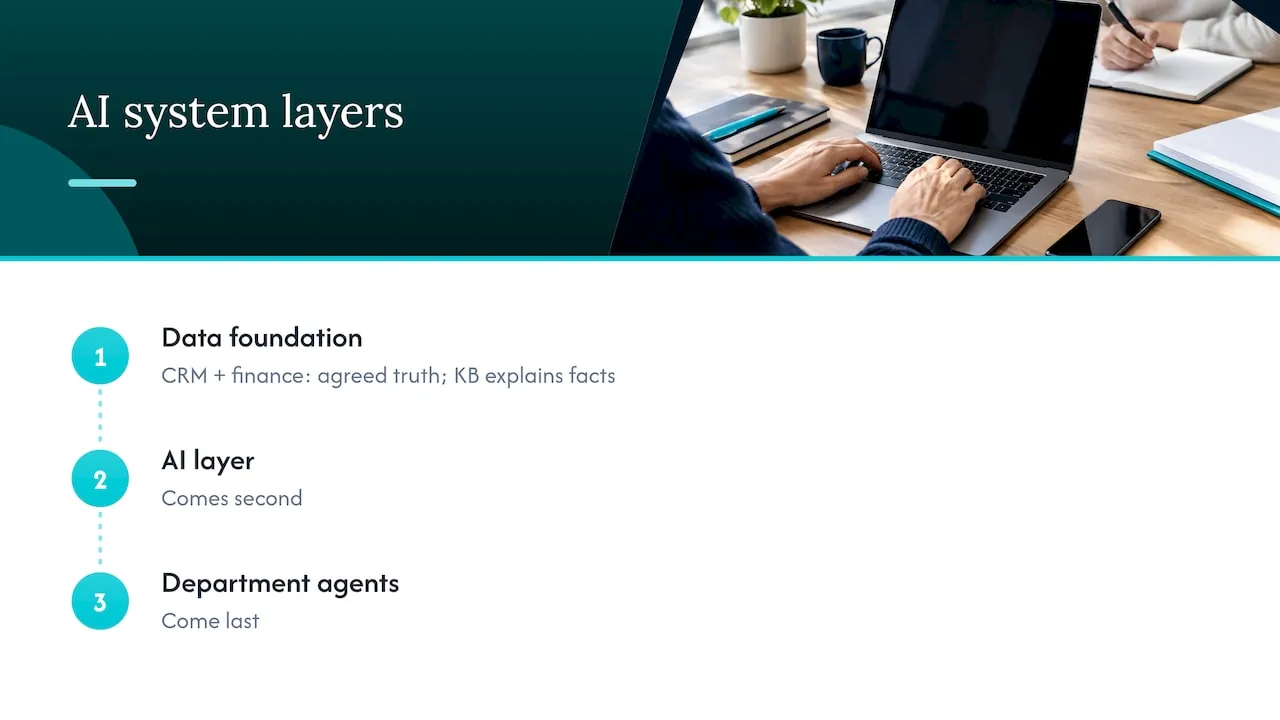
É a mesma ordem que seguimos quando construímos IA para clientes. Primeiro vem a base de dados: os dados de CRM e de finanças como a versão única e acordada da verdade, preparados pelo Processor. Em segundo lugar vem a camada de IA. Os agentes departamentais vêm por último. Uma base de conhecimento fica dentro dessa estrutura como camada explicativa sobre dados fiáveis.
Como integrar passo a passo
Uma sequência prática, com base nas camadas que a maioria das configurações em produção partilha: conectores, transformação, segmentação e indexação, e depois recuperação e geração.
- Inventarie e classifique as fontes. Use o registo acima.
- Ligue com o acesso mais restrito possível. Dê a cada conector as permissões mínimas de que necessita. Apenas leitura, a menos que um fluxo de trabalho escreva de facto de volta.
- Limpe e transforme. Retire o ruído de navegação, normalize os formatos, mantenha títulos, responsáveis e datas como metadados.
- Segmente por significado. Divida o conteúdo em limites naturais, como um procedimento ou uma cláusula de política, e não em contagens arbitrárias de caracteres.
- Indexe com metadados. Guarde a fonte, a data e hora, o público-alvo e um indicador de prioridade, para que a recuperação possa favorecer o conteúdo de referência.
- Teste a recuperação antes da geração. Faça 50 perguntas reais do seu histórico de suporte e de vendas e verifique se a passagem certa é devolvida. Só depois acrescente uma IA que escreve respostas.
- Implemente por fases. Primeiro uma pré-visualização interna, depois um grupo limitado e, por fim, uma utilização mais alargada.
Inclua a atualidade e as permissões nos seus critérios de aceitação, e não numa limpeza posterior. “Devolve a resposta certa” não basta. O teste é: “devolve a resposta certa e atual, e só a quem tem autorização para a ver”.
A gestão da mudança é tão importante como os conectores. As pessoas precisam de saber de onde vêm agora as respostas e quem corrige uma resposta errada. A formação em trabalho de equipa e colaboração pode ajudar as equipas a acordar responsabilidades e a manter o conteúdo sincronizado entre departamentos à medida que a configuração evolui.
Onde a automatização da base de conhecimento ajuda
A automatização é o ponto em que uma base de conhecimento deixa de se degradar. A maior parte do conteúdo fica desatualizada, não por preguiça das pessoas, mas porque ninguém é avisado quando o produto mudou.
As tarefas de automatização mais comuns são:
- Redigir novos artigos a partir de tickets resolvidos, transcrições de chat ou notas de versão.
- Captar respostas que surgem em conversas do Slack ou em respostas de suporte.
- Organizar o conteúdo, etiquetando-o e identificando quase duplicados.
- Disponibilizar artigos no chat, no produto ou através de um assistente de IA.
- Atualizar o conteúdo, sinalizando os artigos afetados por uma alteração do produto e redigindo as edições.
A escolha de conceção importante é onde se coloca a pessoa. Um guia sobre conteúdo de suporte que se atualiza sozinho defende o mesmo: a parte automática consiste em detetar lacunas e redigir alterações, e uma pessoa revê antes de qualquer publicação. Construímos da mesma forma. O sistema propõe, um responsável identificado aprova.
Outro padrão que vale a pena conhecer é o ciclo que escreve conhecimento de volta. As conversas são captadas, convertidas para um formato pesquisável, usadas para responder a perguntas, e o novo conhecimento é devolvido ao sistema de registo. Esse ciclo só funciona se o sistema de registo estiver limpo desde o início.
Para analisar mais a fundo um processo em que isto compensa, veja o nosso artigo sobre automatização do onboarding para SaaS B2B.
Permitir que a IA use a base de conhecimento em segurança
Um assistente de IA ligado à sua base de conhecimento pode fazer duas coisas: ler e agir. Ambas exigem salvaguardas.
Ler: as permissões acompanham o utilizador
A falha grave mais comum é um assistente que apresenta um documento que a pessoa que perguntou nunca teve autorização para abrir. A solução é tratar as permissões como dados. Um artigo técnico sobre integrações seguras recomenda que um agente compreenda e represente o modelo de permissões do sistema de origem antes de processar qualquer página, e que a recuperação filtre os documentos no momento da consulta com base na identidade do utilizador atual. Aconselha também a atualizar as listas de acesso tão frequentemente como o conteúdo, já que um documento que estava restrito esta manhã não deve ser servido esta tarde.
O runbook de onboarding para conectores do Copilot publicado pela Microsoft apresenta uma regra concreta que vale a pena copiar, seja qual for a plataforma: manter o acesso limitado às pessoas que já o têm, em vez de “Todos”, e incluir pelo menos um teste negativo contra o seu conteúdo mais sensível, como material restrito de RH. Se esse teste devolver conteúdo, interrompa a implementação.
Agir: fundamentado, registado, limitado
Quando um agente faz mais do que responder, por exemplo atualizar um registo ou desencadear um processo, o padrão é o mesmo. A AWS descreve um fluxo de trabalho de agente fundamentado em que o agente identifica a intenção, consulta a política na base de conhecimento, só executa uma ação se o pedido for elegível, e faz tudo isto dentro de salvaguardas e com registo. A sua orientação sobre fundamentação e recuperação acrescenta itens de governação que vale a pena pôr na sua lista de verificação: qualidade dos dados de origem, controlo de acesso por identidade e função, políticas de versionamento e atualidade, registo de auditoria e ciclos de feedback para correções.
A nossa própria conceção segue a mesma forma: os agentes trabalham dentro das permissões, pedem aprovação quando a ação é relevante e deixam um registo de auditoria.
Reduzir respostas erradas
Para perguntas em que já tem uma resposta verificada, pode dispensar totalmente a geração. A AWS descreve uma cache semântica verificada que devolve diretamente uma resposta selecionada quando uma consulta corresponde de perto a uma pergunta conhecida, recorrendo ao modelo apenas para consultas de baixa semelhança. O princípio aplica-se de forma geral: onde existe uma resposta aprovada, sirva-a.
Onde a IA não deve ser usada
Ser explícito quanto aos limites torna uma integração mais segura e mais barata.
- Preços, descontos e condições contratuais. Sirva-os a partir do registo de CRM ou de finanças, ou encaminhe para uma pessoa. Não deixe que um modelo os parafraseie.
- Decisões que afetam os direitos ou o sustento das pessoas, como a contratação ou a avaliação de crédito. O EU AI Act considera de risco elevado alguns sistemas nestas áreas, com obrigações mais rigorosas.
- Aconselhamento jurídico, fiscal e médico. A recuperação pode apontar para o texto aprovado. Não deve interpretá-lo.
- Conteúdo sem responsável. Se nenhuma pessoa puder garantir um documento, ele não pertence ao índice.
- Publicação sem revisão. A IA pode redigir. Quem publica é uma pessoa.
- Acesso amplo e sem restrições. Um assistente que consegue ver tudo é uma violação de dados à espera da pergunta certa.
Adote um processo de cada vez, começando pelo mais dispendioso. A redução de pedidos de suporte ou os questionários de segurança de vendas são muitas vezes bons primeiros candidatos, porque o volume é elevado e as respostas aprovadas já existem.
RGPD, NIS2 e EU AI Act na conceção
Se a sua base de conhecimento tratar dados pessoais de pessoas na UE, o desenho deve ter em conta as regras europeias desde o início, e não só depois do lançamento. Em termos gerais:
- O GDPR aplica-se quando são tratados dados pessoais de pessoas na UE. Isso abrange nomes de clientes, emails e o conteúdo de tickets dentro do seu índice. Pense em onde os dados são armazenados e tratados, que fornecedores atuam como subcontratantes e exigem um acordo de tratamento de dados, durante quanto tempo o conteúdo é conservado e como elimina os dados de uma pessoa, tanto na fonte como no índice.
- A limitação da finalidade é relevante quando existe um fornecedor envolvido. Verifique se o conteúdo que indexa para pesquisa não é reutilizado para treinar os modelos do próprio fornecedor.
- O Regulamento da UE sobre IA (EU AI Act) define obrigações por categoria de risco. Muitos casos de utilização de uma base de conhecimento, como responder a perguntas sobre o produto, são de risco mais baixo, mas os deveres de transparência e as categorias de risco elevado continuam a merecer atenção.
- A NIS2 diz respeito à gestão dos riscos de cibersegurança das entidades abrangidas. Saber se a sua empresa está abrangida é uma questão para o seu consultor jurídico.
Na prática, estes quadros regulatórios sobrepõem-se. O controlo de acessos, o registo de atividade e as avaliações de risco documentadas servem vários deles em simultâneo. Nada disto constitui aconselhamento jurídico, e nenhuma arquitetura garante a conformidade. Peça ao seu advogado ou ao encarregado de proteção de dados que confirme o que se aplica à sua empresa. O nosso quadro de governação de IA para SaaS B2B aborda o lado prático.
Perspetiva: porque construímos primeiro os dados
Somos questionados sobre bases de conhecimento quando algo já correu mal: um assistente citou os preços do ano passado, um agente de suporte colou uma resposta que contradizia o contrato, ou alguém encontrou um documento interno na resposta de um chat.
Em quase todos os casos, a base de conhecimento não era o problema. O problema era que ninguém era responsável pela verdade. O CRM dizia uma coisa, o sistema financeiro outra, e a wiki uma terceira. Ligar um assistente de IA aos três apenas tornou a discrepância mais rápida.
É por isso que trabalhamos numa ordem fixa. Primeiro, a base de dados: dados de CRM e de finanças transformados numa única versão acordada da verdade. Depois, a camada de IA, que liga esses dados ao assistente que a sua empresa já utiliza. Por fim, agentes departamentais para Finanças, Vendas e Customer Success que as suas próprias equipas usam em linguagem simples, dentro das permissões, com aprovação onde importa e um registo de auditoria.
Dizemos também onde a IA deve ficar de fora: condições contratuais, decisões sobre pessoas e qualquer conteúdo sem responsável. Uma base de conhecimento é útil quando é restrita, atual e com permissões. Torna-se um risco quando é grande e sem responsável.
A empresa fica com o que construímos: o código-fonte, a documentação e a infraestrutura são transferidos na entrega, e a construção, o piloto e os testes decorrem em infraestrutura europeia self-hosted na Alemanha.
Claus Nielsen
Trabalhe com a NordOps Consulting
Se a sua equipa já utiliza IA mas ninguém é responsável por ela, o primeiro passo costuma ser ter uma imagem clara dos seus dados e de onde a IA compensa. O nosso AI Readiness Assessment começa em €4,500 e analisa a sua base de dados, os seus processos e a sua posição regulatória. Para uma responsabilidade contínua, o serviço de Chief AI Officer em regime fracionado começa em €1,500 por mês no nível Advisor, em €3,250 no nível Operating e em €5,500 no nível Embedded.
As implementações são cobradas a 30% da poupança do primeiro ano, depois de medida e comprovada, ou a um preço fixo acordado antes do início do trabalho. Pode consultar a lista completa na página de preços, ou começar com uma chamada de descoberta gratuita de 30 minutos. Os nossos agentes de IA para Finanças, Vendas e Customer Success mostram como é a camada departamental quando os dados estão em ordem.
Uma lista de verificação antes de entrar em produção
- Cada fonte tem um responsável identificado, um público-alvo e uma data de revisão.
- Para cada tipo de pergunta, uma fonte está marcada como autoritativa.
- Os conectores usam, por defeito, os âmbitos mais restritos e o acesso só de leitura.
- As permissões sincronizam-se com a mesma frequência que o conteúdo, e as eliminações chegam ao índice.
- Um teste negativo sobre o seu conteúdo mais sensível é bem-sucedido.
- A recuperação é testada com perguntas reais antes de qualquer modelo escrever respostas.
- A IA redige, as pessoas publicam.
- As ações são registadas e exigem aprovação quando há muito em jogo.
- A localização dos dados, os subcontratantes e a conservação estão documentados e revistos pelo seu consultor jurídico.
- Alguém é responsável pelo sistema depois do lançamento.
FAQ
Qual é o objetivo de uma integração de base de conhecimento?
Coloca respostas aprovadas dentro das ferramentas que as pessoas já usam, como CRM, helpdesk, chat e assistentes de IA. Isso poupa tempo na alternância entre ferramentas e evita manter cópias duplicadas. Dá também à IA uma fonte controlada de onde recuperar informação.
A que se pode ligar uma base de conhecimento?
As fontes mais comuns são repositórios de documentos, sistemas de tickets, ferramentas de comunicação, plataformas de alojamento de código e sistemas de registo estruturados, como CRM e finanças. Nas empresas de SaaS, os sistemas de registo devem ser a autoridade para factos como o plano, o preço e a data de renovação. Os artigos explicam, e os registos afirmam.
As atualizações de uma base de conhecimento podem ser totalmente automatizadas?
A deteção e a redação podem ser automatizadas: identificar lacunas, propor novos artigos e assinalar os desatualizados. A publicação deve ficar a cargo de um revisor identificado, sobretudo para tudo o que seja voltado para o cliente ou que uma IA vá citar.
Como evitamos que um assistente de IA exponha documentos restritos?
Leve as permissões do sistema de origem para o índice e filtre os resultados pela identidade de quem pergunta. Atualize as permissões com a mesma frequência que o conteúdo e execute um teste negativo sobre o seu material mais sensível antes do lançamento.
Isto exige uma revisão jurídica na Europa?
Sim, na prática. O GDPR, a NIS2 e o Regulamento da UE sobre IA (EU AI Act) podem aplicar-se, cada um consoante os seus dados e o seu caso de utilização. Um consultor jurídico ou o encarregado de proteção de dados deve confirmar o que se aplica à sua empresa.
Fontes
- Integrações de bases de conhecimento: arquitetura e testes
- Enterprise Knowledge Base for AI: Architecture Guide
- AI Support Knowledge Base That Updates Itself
- Build Secure Knowledge Base Integrations for AI Agents (DZone)
- Microsoft Copilot Connector Knowledge Onboarding Runbook
- AWS Prescriptive Guidance: Grounded agent AI workflow
- AWS Prescriptive Guidance: Grounding and Retrieval Augmented Generation
- AWS Machine Learning Blog: Reduzir as alucinações com uma cache semântica verificada