Integrasjon av kunnskapsbase betyr å koble dokumentasjonen din til systemene der teamet og kundene allerede jobber: CRM, supportsystem, chat, økonomi og produkt. Gjort riktig får folk det godkjente svaret i verktøyet de bruker, og AI-assistenter henter oppdatert informasjon i stedet for å gjette. Gjort dårlig kopierer du utdatert innhold til flere steder. Forskjellen kommer ned til tre beslutninger: hvilke kilder som er autoritative, hvem som kan se hva, og hvordan innholdet holdes oppdatert.
Denne guiden er skrevet for gründere, COO-er og ledere for økonomi, salg og kundesuksess i B2B SaaS-selskaper med omtrent 20 til 200 ansatte. Den dekker hva som bør kobles til, hvordan du velger sannhetskilde, hvordan automatisering fungerer, hvordan AI kan bruke resultatet på en trygg måte, og hva europeiske regler betyr for utformingen.
Kort fortalt
- En integrasjon av kunnskapsbase legger godkjente svar inn i CRM-poster, saker, chat og AI-assistenter, slik at ingen må bytte verktøy eller vedlikeholde en ekstra kopi.
- Start med et kilderegister: bestem hvilket system som er autoritativt for hvilken type spørsmål, og utelat utdatert eller duplisert innhold før du kobler til noe som helst.
- Behandle tilganger som data. Det en bruker ikke kan åpne i kildesystemet, skal AI ikke hente frem for vedkommende.
- Automatisering bør oppdage hull og utarbeide utkast til oppdateringer. Et menneske bør godkjenne det som publiseres.
- Under GDPR og EU AI Act bør du fra dag én utforme for datalokasjon, tilgangskontroll og revisjonsspor, og be din juridiske rådgiver bekrefte hvordan reglene gjelder for deg.
Innholdsfortegnelse
- Hva integrasjon av kunnskapsbase egentlig betyr
- Bestem sannhetskilden først
- Slik integrerer du steg for steg
- Hvor automatisering av kunnskapsbasen hjelper
- La AI bruke kunnskapsbasen på en trygg måte
- Hvor AI ikke hører hjemme
- GDPR, NIS2 og EU AI Act i utformingen
- Perspektiv: hvorfor vi bygger dataene først
- Samarbeid med NordOps Consulting
- En sjekkliste før du går live
- FAQ
- Kilder
Hva integrasjon av kunnskapsbase egentlig betyr
En kunnskapsbase alene er et bibliotek. En integrasjon gjør den til en tjeneste. I stedet for å be folk besøke et hjelpesenter eller en wiki dukker riktig artikkel eller riktig svar opp i en CRM-post, en supportsak, en live chat, Slack eller Microsoft Teams, eller en AI-chatbot. En oversikt over integrasjoner beskriver dette som å bringe relevante artikler og dokumentasjon inn i verktøyene kunder, agenter og team allerede bruker.
For et SaaS-selskap er gevinsten praktisk:
- Supportagenter svarer raskere fordi den godkjente artikkelen ligger ved siden av saken.
- Customer Success-ansvarlige ser riktig onboarding eller produktveiledning på kontoen de jobber med.
- Salg henter oppdaterte svar om produkt og sikkerhet inn i en avtale i stedet for å spørre en kollega.
- Kunder finner svar i produktet eller i chat før de åpner en sak.
- AI-assistenter henter godkjent innhold i stedet for å finne på noe.
Legg merke til hva som mangler i den listen: et nytt verktøy. De beste integrasjonene legger ikke til et nytt sted å lete. De fjerner ett.
Bestem sannhetskilden først
De fleste mislykkede integrasjoner feiler før noen kobling er bygget. Selskapet har den samme prisregelen i en wiki-side, et CRM-felt, en presentasjon og en supportmakro, og de fire er uenige. Kobler du alle fire til en AI-assistent, vil den sitere den som rangerer høyest.
En kunnskapsbase i produksjon henter typisk fra seks typer innhold, ifølge en arkitekturguide: dokumentlagre, saksbehandlingssystemer, kodeverter, kommunikasjonsarkiver, strukturerte kildesystemer og eksternt autoritativt innhold. For et SaaS-selskap er de strukturerte kildesystemene viktigst: CRM-et og økonomisystemet ditt inneholder faktaene som annet innhold bare beskriver.
Bygg et kilderegister
Før du kobler til noe, skriv én linje per lager. Nyttige felt er blant annet:
- Eier, en navngitt person, ikke et team.
- Målgruppe: kun internt, kundevendt eller partnervendt.
- Dataklassifisering, inkludert om innholdet har personopplysninger.
- Autoritativ for hvilke spørsmål, og hvilke kilder som veier tyngre når de er uenige.
- Dato for gjennomgang og oppbevaringstid.
- Hvordan slettinger når frem til indeksen.
Utelat deretter det som ikke hører hjemme: utdaterte utkast, duplikater, personlige notater og alt der eieren ikke kan si om det fortsatt er riktig.
La kildesystemene vinne
En enkel regel fungerer godt: hvis et faktum finnes i et strukturert system, vinner det strukturerte systemet. Kontraktsverdi, fornyelsesdato, abonnement, fakturastatus og bruk hører hjemme i CRM- og økonomidataene. Artikler forklarer hvordan de skal brukes eller tolkes. De gjentar dem aldri.
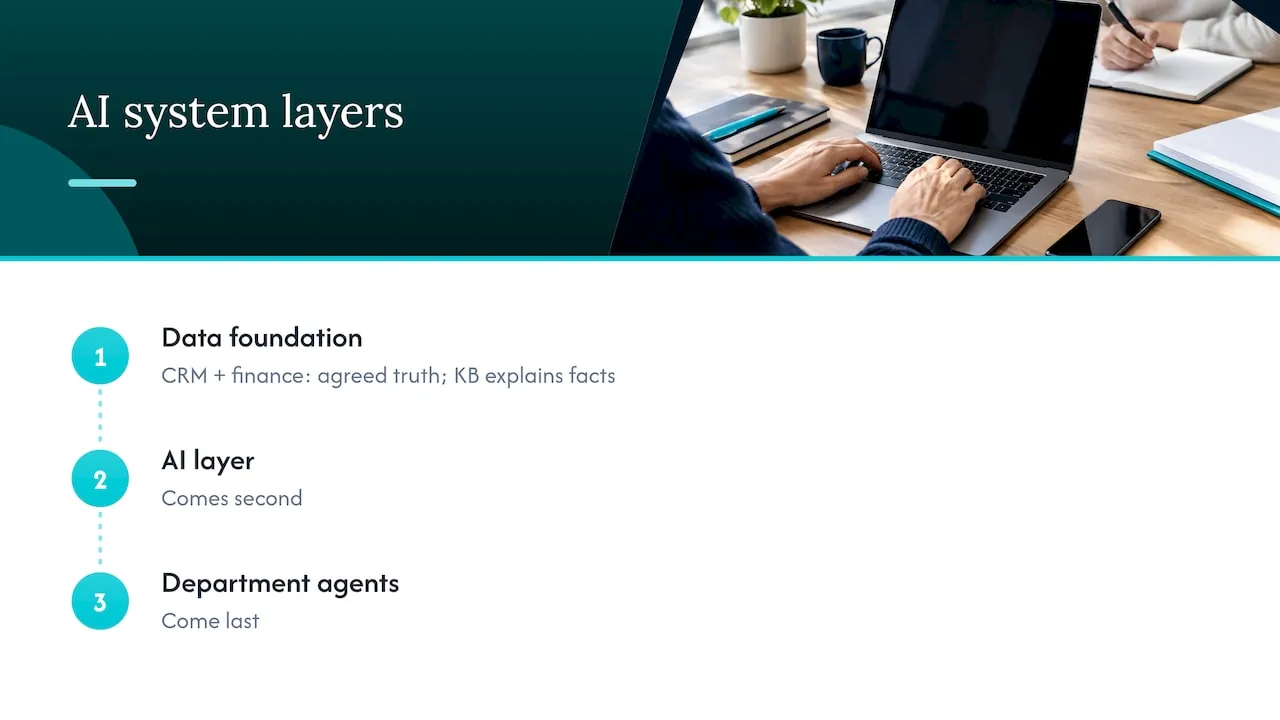
Dette er den samme rekkefølgen vi bruker når vi bygger AI for kunder. Datagrunnlaget kommer først: CRM- og økonomidata som den ene omforente versjonen av sannheten, klargjort av Processor. AI-laget kommer som nummer to. Avdelingsagentene kommer sist. En kunnskapsbase ligger innenfor denne strukturen som det forklarende laget oppå pålitelige data.
Slik integrerer du steg for steg
En praktisk fremgangsmåte, basert på lagene de fleste produksjonsløsninger har til felles: koblinger, transformasjon, oppdeling og indeksering, deretter gjenfinning og generering.
- Kartlegg og rangér kildene. Bruk registeret ovenfor.
- Koble til med snevrest mulig tilgang. Gi hver kobling de minste rettighetene den trenger. Skrivebeskyttet, med mindre en arbeidsflyt faktisk skriver tilbake.
- Rydd og transformer. Fjern navigasjonsstøy, normaliser formater, og behold titler, eiere og datoer som metadata.
- Del opp etter mening. Del innholdet ved naturlige skiller, som en prosedyre eller en policyklausul, ikke ved vilkårlige tegnantall.
- Indekser med metadata. Lagre kilde, tidsstempel, målgruppe og et prioritetsflagg slik at gjenfinningen kan foretrekke autoritativt innhold.
- Test gjenfinning før generering. Still 50 reelle spørsmål fra support- og salgshistorikken din, og sjekk om riktig avsnitt kommer tilbake. Legg først deretter til en AI som skriver svar.
- Innfør i trinn. Først intern forhåndsvisning, deretter en begrenset gruppe, og så bredere bruk.
Ta med aktualitet og tilganger i akseptansekriteriene dine, ikke i en senere opprydding. «Den gir riktig svar» er ikke nok. Testen er: «Den gir riktig, oppdatert svar, og bare til personer som har lov til å se det.»
Endringsledelse er like viktig som koblingene. Folk må vite hvor svarene nå kommer fra, og hvem som rettar et feil svar. Opplæring i teamarbeid og samarbeid kan hjelpe team med å bli enige om eierskap og holde innholdet synkronisert på tvers av avdelinger når løsningen endrer seg.
Hvor automatisering av kunnskapsbasen hjelper
Automatisering er der en kunnskapsbase slutter å forfalle. Mesteparten av innholdet blir utdatert, ikke fordi folk er late, men fordi ingen får beskjed når produktet har endret seg.
De vanligste automatiseringsoppgavene er:
- Utkast til nye artikler basert på løste saker, chatlogger eller utgivelsesnotater.
- Fange opp svar som dukker opp i Slack-tråder eller supportsvar.
- Organisere innhold ved å tagge det og oppdage nesten-duplikater.
- Levere artikler i chat, i produktet eller gjennom en AI-assistent.
- Oppdatere innhold ved å flagge artikler som påvirkes av en produktendring og lage utkast til endringer.
Det viktige designvalget er hvor mennesket sitter. En veiledning om selvoppdaterende supportinnhold peker på det samme: den automatiske delen er å oppdage hull og lage utkast til endringer, og en person gjennomgår før noe går live. Vi bygger det på samme måte. Systemet foreslår, en navngitt eier godkjenner.
Et mønster til som er verdt å kjenne til, er sløyfen som skriver innsikt tilbake. Samtaler fanges opp, gjøres om til søkbar form, brukes til å svare på spørsmål, og den nye kunnskapen skyves tilbake til masterregisteret. Sløyfen fungerer bare hvis masterregisteret er rent fra start.
For en dypere titt på én prosess der dette lønner seg, se artikkelen vår om onboarding-automatisering for B2B SaaS.
La AI bruke kunnskapsbasen på en trygg måte
En AI-assistent koblet til kunnskapsbasen din kan gjøre to ting: lese og handle. Begge deler krever rekkverk.
Lesing: tilganger følger brukeren
Den vanligste alvorlige feilen er en assistent som viser fram et dokument personen som spør aldri hadde lov til å åpne. Løsningen er å behandle tilganger som data. En teknisk gjennomgang av sikre integrasjoner anbefaler at en agent forstår og gjengir kildesystemets tilgangsmodell før den behandler noen side, og at gjenfinningen filtrerer dokumenter ved spørretidspunktet ut fra den gjeldende brukerens identitet. Den anbefaler også å oppdatere tilgangslistene like ofte som innholdet, siden et dokument som var begrenset i morges ikke bør leveres i ettermiddag.
Microsofts publiserte onboarding-runbook for Copilot-koblinger gir en konkret regel som er verdt å kopiere uansett plattform: hold tilgangen begrenset til personer som allerede har den, i stedet for «Everyone», og ta med minst én negativ test mot det mest sensitive innholdet ditt, for eksempel begrenset HR-materiale. Hvis den testen returnerer innhold, stans utrullingen.
Handling: forankret, logget, avgrenset
Når en agent gjør mer enn å svare, for eksempel oppdaterer en post eller utløser en prosess, er mønsteret det samme. AWS beskriver en forankret agentarbeidsflyt der agenten finner ut hensikten, slår opp policy i kunnskapsbasen, kaller en handling bare hvis forespørselen er berettiget, og gjør alt dette innenfor rekkverk og med logging. Veiledningen deres om forankring og gjenfinning legger til styringspunkter som er verdt å ha på sjekklisten: kvaliteten på kildedata, tilgangskontroll etter identitet og rolle, retningslinjer for versjonering og aktualitet, revisjonslogging og tilbakemeldingssløyfer for rettelser.
Vårt eget design følger samme form: agenter arbeider innenfor tilganger, ber om godkjenning der handlingen er viktig, og etterlater et revisjonsspor.
Færre gale svar
For spørsmål der du allerede har et verifisert svar, kan du hoppe over genereringen helt. AWS beskriver en verifisert semantisk cache som returnerer et kuratert svar direkte når en forespørsel ligger tett opptil et kjent spørsmål, og faller tilbake på modellen bare for forespørsler med lav likhet. Prinsippet gjelder bredt: der det finnes et godkjent svar, bruk det.
Hvor AI ikke hører hjemme
Å være tydelig på begrensningene gjør en integrasjon tryggere og billigere.
- Priser, rabatter og kontraktsvilkår. Lever disse fra CRM- eller økonomiposten, eller send til en person. Ikke la en modell omskrive dem.
- Beslutninger som påvirker menneskers rettigheter eller levebrød, som ansettelse eller kredittvurdering. EU AI Act behandler enkelte systemer på disse områdene som høyrisiko, med strengere krav.
- Juridisk, skattemessig og medisinsk rådgivning. Gjenfinning kan peke til den godkjente teksten. Den bør ikke tolke den.
- Innhold ingen eier. Hvis ingen kan stå inne for et dokument, hører det ikke hjemme i indeksen.
- Publisering uten gjennomgang. AI kan lage utkast. Et menneske publiserer.
- Bred tilgang uten avgrensning. En assistent som kan se alt, er et datalekkasjebrudd som venter på riktig spørsmål.
Ta i bruk én prosess om gangen, og start med den dyreste. Reduksjon av supporthenvendelser eller sikkerhetsskjemaer i salg er ofte gode første kandidater, fordi volumet er høyt og de godkjente svarene allerede finnes.
GDPR, NIS2 og EU AI Act i utformingen
Hvis kunnskapsbasen din inneholder personopplysninger om personer i EU, bør løsningen ta hensyn til europeiske regler fra starten, ikke først etter lansering. Generelt gjelder følgende:
- GDPR gjelder når personopplysninger om personer i EU behandles. Det omfatter kundenavn, e-postadresser og saksinnhold i indeksen din. Tenk gjennom hvor data lagres og behandles, hvilke leverandører som er databehandlere og krever en databehandleravtale, hvor lenge innhold oppbevares, og hvordan du sletter én persons data både fra kilden og fra indeksen.
- Formålsbegrensning er viktig når en leverandør er involvert. Kontroller at innhold du indekserer for søk, ikke gjenbrukes til å trene leverandørens egne modeller.
- EUs AI-forordning (EU AI Act) fastsetter plikter etter risikokategori. Mange bruksområder for kunnskapsbaser, som å svare på produktspørsmål, har lavere risiko, men åpenhetskravene og høyrisikokategoriene bør likevel vurderes.
- NIS2 gjelder styring av cybersikkerhetsrisiko for virksomheter som omfattes. Om selskapet ditt omfattes, er et spørsmål for din juridiske rådgiver.
I praksis overlapper disse regelverkene. Tilgangskontroll, logging og dokumenterte risikovurderinger ivaretar flere av dem samtidig. Ingenting av dette er juridisk rådgivning, og ingen arkitektur garanterer etterlevelse. La din jurist eller personvernombud bekrefte hva som gjelder for deg. Vårt rammeverk for AI-styring for B2B SaaS tar for seg den praktiske siden.
Perspektiv: hvorfor vi bygger dataene først
Vi får spørsmål om kunnskapsbaser når noe allerede har gått galt: en assistent siterte fjorårets priser, en kundesupportmedarbeider limte inn et svar som var i strid med kontrakten, eller noen fant et internt dokument i et chatsvar.
I nesten alle tilfeller var ikke kunnskapsbasen problemet. Problemet var at ingen eide sannheten. CRM-systemet sa én ting, økonomisystemet noe annet og wikien en tredje ting. Å koble en AI-assistent til alle tre gjorde bare at uenigheten kom raskere frem.
Derfor jobber vi i en fast rekkefølge. Først datagrunnlaget: CRM- og økonomidata samlet i én omforent versjon av sannheten. Deretter AI-laget, som kobler disse dataene til assistenten selskapet allerede bruker. Så avdelingsagenter for Finance, Sales og Customer Success som dine egne folk bruker på vanlig språk, innenfor tilganger, med godkjenning der det er viktig og med en revisjonslogg.
Vi sier også hvor AI bør holdes utenfor: kontraktsvilkår, beslutninger om personer og alt innhold uten eier. En kunnskapsbase er nyttig når den er avgrenset, oppdatert og har tilgangsstyring. Den er en risiko når den er stor og uten eier.
Selskapet beholder det vi bygger: kildekode, dokumentasjon og infrastruktur overføres ved overlevering, og bygging, pilot og testing kjøres på selvdriftet europeisk infrastruktur i Tyskland.
Claus Nielsen
Samarbeid med NordOps Consulting
Hvis teamet ditt allerede bruker AI, men ingen eier det, er første steg vanligvis et tydelig bilde av dataene dine og av hvor AI lønner seg. Vår AI Readiness Assessment starter fra €4,500 og ser på datagrunnlaget, prosessene og den regulatoriske situasjonen din. For løpende eierskap starter abonnementet på Fractional Chief AI Officer fra €1,500 per måned på Advisor-nivå, fra €3,250 på Operating-nivå og fra €5,500 på Embedded-nivå.
Utviklingsoppdrag prises til 30% av første års besparelse, når den er målt og dokumentert, eller til en fast pris avtalt før arbeidet starter. Du finner hele oversikten på prissiden, eller du kan starte med en gratis oppstartssamtale på 30 minutter. Våre AI-agenter for Finance, Sales og Customer Success viser hvordan avdelingslaget ser ut når dataene er i orden.
En sjekkliste før du går live
- Hver kilde har en navngitt eier, en målgruppe og en revisjonsdato.
- For hver spørsmålstype er én kilde markert som autoritativ.
- Koblinger bruker de smaleste tilgangsomfangene og skrivebeskyttet tilgang som standard.
- Tilganger synkroniseres like ofte som innhold, og slettinger når frem til indeksen.
- En negativ test mot det mest sensitive innholdet ditt består.
- Gjenfinning testes på reelle spørsmål før noen modell skriver svar.
- AI utarbeider utkast, mennesker publiserer.
- Handlinger logges og krever godkjenning der innsatsen er høy.
- Datalokasjon, databehandlere og oppbevaringstid er dokumentert og gjennomgått av din juridiske rådgiver.
- Noen eier løsningen etter lansering.
FAQ
Hva er formålet med en integrasjon av kunnskapsbase?
Den gir godkjente svar direkte i verktøyene folk allerede bruker, som CRM, supportsystem, chat og AI-assistenter. Det sparer tid på å bytte mellom verktøy og unngår at man må vedlikeholde dupliserte kopier. Den gir også AI en kontrollert kilde å hente fra.
Hva kan en kunnskapsbase kobles til?
Vanlige kilder er dokumentlagre, saksbehandlingssystemer, kommunikasjonsverktøy, kodeplattformer og strukturerte kildesystemer som CRM og økonomi. For SaaS-selskaper bør kildesystemene være autoriteten for fakta som abonnement, pris og fornyelsesdato. Artikler forklarer, og registre fastslår.
Kan oppdateringer av kunnskapsbasen automatiseres fullt ut?
Oppdagelse og utkast kan automatiseres: å avdekke hull, foreslå nye artikler og flagge utdaterte. Publisering bør ligge hos en navngitt kontrollør, særlig for alt som er kundevendt eller som en AI vil sitere.
Hvordan hindrer vi at en AI-assistent avslører begrensede dokumenter?
Ta med kildesystemets tilganger inn i indeksen og filtrer resultatene etter identiteten til den som spør. Oppdater tilganger like ofte som innhold, og kjør en negativ test på det mest sensitive materialet før lansering.
Krever dette en juridisk gjennomgang i Europa?
Ja, i praksis. GDPR, NIS2 og EUs AI-forordning (EU AI Act) kan hver for seg gjelde, avhengig av dataene og bruksområdet ditt. En juridisk rådgiver eller et personvernombud bør bekrefte hva som gjelder for deg.
Kilder
- Integrasjoner av kunnskapsbaser: arkitektur og testing
- Enterprise Knowledge Base for AI: Architecture Guide
- AI Support Knowledge Base That Updates Itself
- Build Secure Knowledge Base Integrations for AI Agents (DZone)
- Microsoft Copilot Connector Knowledge Onboarding Runbook
- AWS Prescriptive Guidance: Grounded agent AI workflow
- AWS Prescriptive Guidance: Grounding and Retrieval Augmented Generation
- AWS Machine Learning Blog: Redusere hallusinasjoner med en verifisert semantisk cache