Un operational data warehouse riunisce in un unico luogo i dati correnti dei vostri sistemi aziendali, come CRM, fatturazione e supporto, così che i team possano fare reporting su ciò che accade ora, non sul mese scorso. Per un’azienda B2B SaaS da 20 a 200 persone, la domanda raramente è quale prodotto di warehouse acquistare. È quali dati devono essere aggiornati, con quale frequenza e chi è responsabile dell’unica versione concordata di quei dati. Se questo aspetto è impostato bene, il reporting funziona. È anche il passaggio che decide se l’AI darà al vostro team risposte di cui potete fidarvi.
In sintesi
- Un operational data warehouse (o operational data store, ODS) contiene i dati correnti di più sistemi per il reporting quotidiano. Un data warehouse classico contiene lo storico consolidato per l’analisi.
- “Quasi in tempo reale” di solito significa minuti, non millisecondi. Per le dashboard consultate da persone raramente serve di più, e una maggiore velocità costa di più da gestire.
- Scegliete la freschezza dei dati in base a chi li usa: una revisione finanziaria, una previsione di vendita e un’azione automatizzata hanno esigenze diverse.
- Concordare un’unica versione dei dati CRM e finanziari conta più degli strumenti. Gli agenti AI leggono quella versione, quindi gli errori presenti in essa diventano risposte sbagliate.
- Sicurezza, logging e regole di accesso si applicano alla copia dei vostri dati operativi esattamente come all’originale. Ciò include gli obblighi del GDPR.
Indice
- Che cos’è un operational data warehouse
- Database operativo, ODS, data warehouse: le differenze
- Come funziona l’architettura del reporting operativo
- Cosa significa “quasi in tempo reale” in numeri
- Quando ne avete bisogno e quando no
- I compromessi che determinano la progettazione
- Perché le fondamenta dei dati vengono prima dell’AI
- Dove l’AI non ha posto
- Dove risiedono i dati
- Come possiamo aiutarvi
- FAQ
- Fonti
Che cos’è un operational data warehouse
Il termine è usato in modo approssimativo. In pratica indica un repository che centralizza i dati operativi correnti di sistemi come CRM, contabilità e vendite, più flussi esterni, così da poter fare reporting senza interrogare ogni sistema separatamente.
Per un’azienda SaaS le fonti sono note:
- CRM: account, contatti, pipeline, rinnovi.
- Finanza: fatture, pagamenti, abbonamenti, piani di ricavo.
- Prodotto: utilizzo, licenze, adozione delle funzionalità.
- Supporto: ticket, escalation, segnali sullo stato di salute dei clienti.
Il valore non sta nell’archiviazione. Sta nel fatto che una domanda come “quali account in rinnovo in questo trimestre hanno escalation aperte e fatture non pagate?” riceva una sola risposta, non tre fogli di calcolo in disaccordo.
Database operativo, ODS, data warehouse: le differenze
Quattro termini vengono spesso confusi. Ecco come si distinguono.
| Database operativo | Operational data store (ODS) | Data warehouse | |
|---|---|---|---|
| Scopo | Gestisce un sistema transazionale, come il vostro CRM o lo strumento di fatturazione | Dati correnti e dettagliati di più sistemi per il reporting operativo | Storico consolidato e ripulito per l’analisi |
| Freschezza | Attivi | Da secondi a minuti o ore | Da ore a giorni |
| Storico | Quanto conserva l’applicazione | Breve: dati correnti o recenti | Lungo: da mesi ad anni |
| Domanda tipica | «Aggiorna questo record» | «Che cosa è aperto oggi?» | «Come è evoluto il churn negli ultimi tre anni?» |
Le distinzioni seguono le descrizioni pubblicate: un database operativo è integrato in un sistema transazionale, un ODS raccoglie dati transazionali dettagliati da più sistemi con aggiornamenti frequenti, mentre un data warehouse è un archivio a lungo termine più statico. Un ODS si colloca tra i sistemi transazionali e il data warehouse analitico, conserva dati attuali o recenti aggiornati da pochi minuti a qualche ora, per domande come le vendite della giornata o i casi di supporto attivi.
Le latenze tipiche vanno da secondi a minuti, con una conservazione da giorni a settimane, per un ODS, contro ore o giorni, con una conservazione da mesi ad anni, per un data warehouse. Un ODS di solito riprende la struttura dei sistemi di origine ed è adatto a un reporting operativo leggero, mentre un data warehouse applica trasformazioni più complete e conserva uno storico ampio.
I moderni data warehouse in cloud rendono il confine meno netto. Possono offrire disponibilità dei dati in tempo reale e rendere superfluo un ODS separato. Per questo «operational data warehouse» va inteso come la descrizione di una funzione, non di un prodotto: dati attuali e integrati, abbastanza affidabili da far funzionare l'azienda.
Come funziona l’architettura del reporting operativo
Qualunque sia l'insieme di strumenti, l'architettura ha sempre gli stessi livelli.
- Fonti. CRM, fatturazione, database di prodotto, strumento di supporto.
- Acquisizione. I dati vengono estratti dalle fonti. Il change data capture (CDC) invia solo inserimenti, aggiornamenti ed eliminazioni, il che riduce il volume trasferito e il carico sulla rete e sui sistemi di origine.
- Elaborazione. I dati vengono puliti, riconciliati tra i sistemi (un cliente, un ID) e organizzati secondo definizioni condivise.
- Servizio. Un archivio che risponde rapidamente alle query di persone e strumenti che lo utilizzano.
- Consumo. Dashboard, report, avvisi e assistenti AI.
Un modello a livelli diffuso prevede un ODS che conserva dati grezzi quasi in tempo reale per i report operativi, con livelli a valle che li puliscono, li aggregano e li rendono disponibili. Una soluzione frequente invia i database transazionali a code e poi ai livelli del data warehouse, così il reporting non rallenta i sistemi su cui lavora il vostro team. Questa separazione è il motivo principale per cui non conviene collegare le dashboard direttamente al CRM o al database di fatturazione.
Se i vostri sistemi pubblicano già le modifiche come eventi, lo stesso flusso può appoggiarsi a quelli. La nostra guida all'architettura event-driven mostra come funziona e dove trova applicazione.
Cosa significa “quasi in tempo reale” in numeri
La maggior parte dei team che chiedono il tempo reale ha bisogno di qualcosa di più modesto. Un framework di un professionista indica livelli di aggiornamento inferiori al secondo, da secondi a circa un minuto, e da minuti a un giorno. Un altro descrive il quasi real time come da circa uno a 15 minuti, con micro-batch o CDC.
Due esempi reali mostrano che cosa è possibile ottenere:
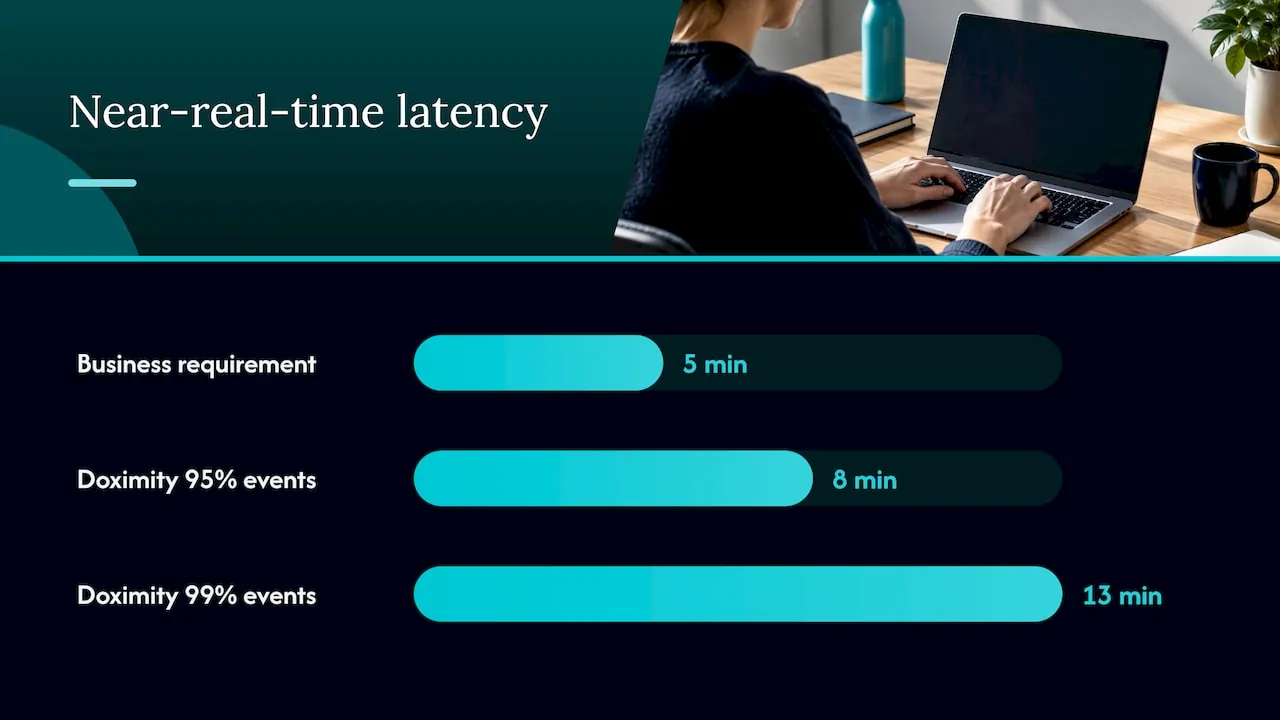
- Un team di ingegneria di Doximity ha riferito che la sua pipeline CDC rendeva le modifiche interrogabili in pochi minuti. Su un campione di 12 giorni, il 95% degli eventi raggiungeva il livello interrogabile entro otto minuti e il 99% entro 13 minuti.
- Una tesi universitaria ha realizzato una pipeline CDC con una latenza media end-to-end di 0.6 secondi a circa 30,000 record al secondo, osservando però che il requisito di reporting aziendale era di cinque minuti.
Il secondo esempio è quello utile. L'ingegneria può superare il requisito con ampio margine, ma la velocità in più non porta all'azienda alcun vantaggio.
C'è anche una differenza tra agire su dati in movimento e interrogare dati arrivati da poco. Le azioni automatiche su frodi o prezzi possono richiedere i primi, mentre le dashboard consultate da persone di solito richiedono solo dati recenti. Un responsabile vendite che rivede la pipeline o un responsabile finanziario che controlla gli incassi usa una dashboard consultata da persone.
Quando ne avete bisogno e quando no
Le decisioni operative sensibili al tempo sono il caso in cui serve. La ricerca sull'operational data warehousing cita scorte, organico, previsione della domanda e dashboard delle prestazioni come esempi supportati da dati infragiornalieri od orari. Tra gli usi di reporting più comuni ci sono dashboard di vendita in tempo reale, evasione degli ordini, viste unificate del cliente e monitoraggio.
Un livello operativo dedicato è giustificato quando il ritardo di aggiornamento del data warehouse è troppo alto per dashboard in tempo reale, controlli antifrode o contesto per l'AI, e superfluo quando tutti gli utilizzatori sono analisti e ore o giorni sono accettabili.
Per un'azienda SaaS da 20 a 200 persone, una regola praticabile:
- Reporting direzionale settimanale o mensile: basta un aggiornamento giornaliero in un archivio consolidato.
- Gestione dei clienti, rinnovi, incassi: è con un aggiornamento orario o nell'ordine dei minuti su CRM, finanza e supporto che si crea valore.
- Azioni automatiche che modificano record o avviano processi: aggiornamento dei dati più permessi e approvazione, come spiegato di seguito.
- Streaming sotto il secondo: raramente giustificato per la vostra dimensione.
I compromessi che determinano la progettazione
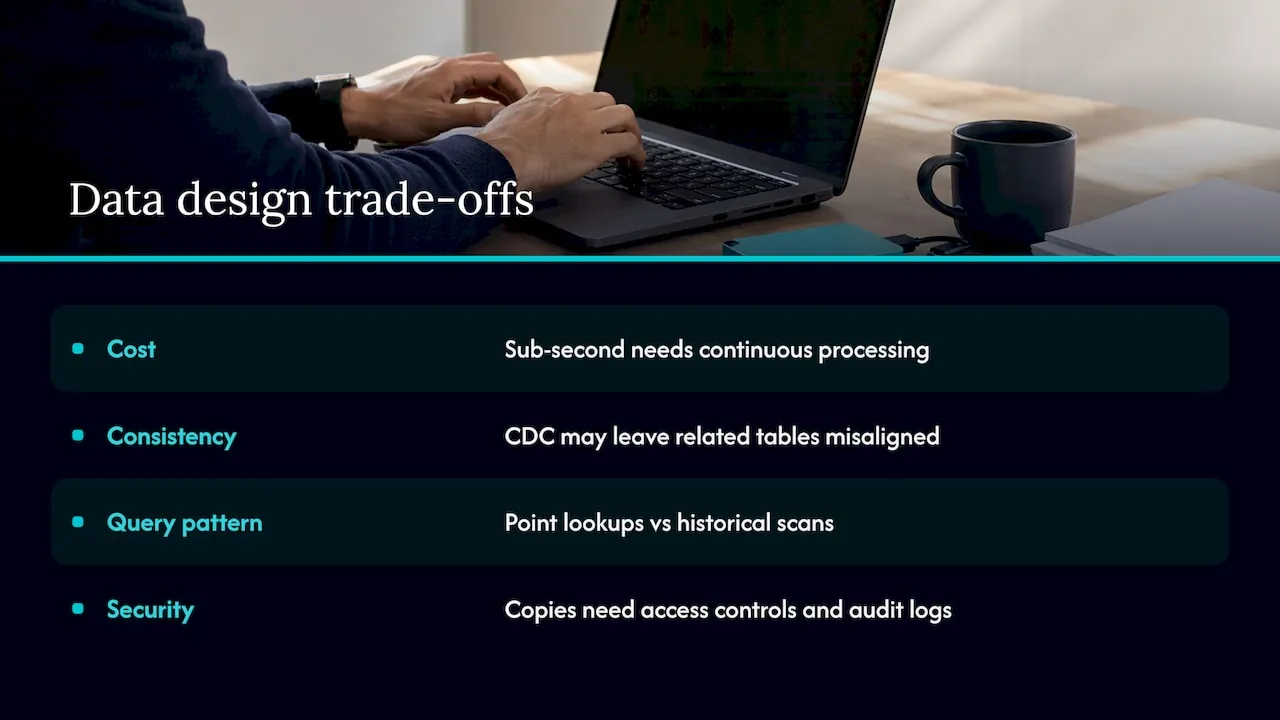
Il costo segue la latenza. Un aggiornamento inferiore al secondo richiede acquisizione, elaborazione e servizio a bassa latenza sempre in esecuzione, mentre il batch può fermarsi quando è inattivo. Lo streaming richiede inoltre competenze su modifiche degli schemi, monitoraggio del ritardo, dati in ritardo e ripristino. Il consiglio è scegliere lo stack più leggero che soddisfi il requisito di chi usa i dati e definire quel requisito per iscritto prima di costruire.
Aggiornato non significa coerente. Il CDC può rendere ogni tabella più aggiornata senza garantire che le tabelle collegate riflettano esattamente lo stesso istante. Il totale di una fattura e un record di abbonamento possono divergere per un breve momento. Decidete quali report richiedono uno snapshot coerente e quali possono accettare un piccolo ritardo.
I modelli di interrogazione differiscono. Un livello di streaming precalcola piccoli insiemi di risultati per ricerche puntuali, mentre un data warehouse scansiona lo storico per analisi ad hoc. I costi seguono fattori diversi, quindi la scelta dovrebbe partire dal modello di accesso.
La sicurezza viaggia con i dati. Una copia replicata non è una copia informale. Tra i controlli raccomandati ci sono accesso per ruolo, tabella, colonna e riga, cifratura a riposo e in transito, registrazione degli accessi (audit log) e tracciamento della lineage. Se i dati includono dati personali di clienti dell'UE, il GDPR si applica alla copia allo stesso modo. Il vostro responsabile della protezione dei dati o il vostro consulente legale dovrebbe confermare che cosa ciò comporti per la vostra configurazione, perché questo articolo non costituisce consulenza legale.
Perché le fondamenta dei dati vengono prima dell’AI
La maggior parte dei team SaaS che chiedono di un operational data warehouse ha un secondo motivo: vuole che l'AI risponda a domande sull'azienda. Così la questione del data warehouse diventa una questione di qualità dei dati.
Un assistente AI che legge due sistemi con due definizioni di «cliente attivo» dà due risposte sicure di sé. La soluzione non è un modello migliore. Occorre stabilire quale sistema sia la fonte di verità per ciascun dato, di solito il CRM per il cliente e la finanza per il denaro, e ripulire i dati di conseguenza. Ne parliamo in CRM e data foundation prima degli agenti AI e nella nostra guida alla strategia di integrazione dei dati per team SaaS.
L'ordine in cui lavoriamo è questo:
- Data foundation. Il CRM, i sistemi che lo circondano e il Processor che trasforma i dati in un'unica versione condivisa della verità. Il Processor è il luogo in cui si svolge questo lavoro.
- Livello AI. MCP collega quei dati all'assistente AI che la vostra azienda usa già.
- Agenti per reparto. Agenti progettati per Finanza, Vendite e Customer Success, che le vostre persone usano in linguaggio naturale per estrarre dati (chiedere, produrre report, cercare) e per inserirli (aggiornare record, avviare processi, assegnare accessi), nel rispetto dei permessi, con approvazione dove serve e con una traccia di audit. Vedi Agenti AI per Finanza, Vendite e Customer Success.
È sul lato finanziario che i dati aggiornati e integrati rendono per primi. Incassi, previsione di cassa e controllo del budget dipendono tutti dalla coerenza tra dati di fatturazione, CRM e bancari. Per esempi concreti di dashboard e decisioni finanziarie, osservate come la previsione dei flussi di cassa e il reporting delle prestazioni dipendano da numeri aggiornati.
Dove l’AI non ha posto
Essere espliciti su questo punto fa risparmiare.
- Dove i dati non sono condivisi. Se vendite e finanza non concordano sul fatturato, correggete prima le definizioni. L'AI applicata sopra nasconde soltanto il disaccordo.
- Decisioni che richiedono azioni in meno di un secondo su denaro o accessi senza approvazione né audit trail. Mantenete una persona nel processo.
- Valutazioni legali. L'AI può preparare le informazioni. Non decide che cosa GDPR, NIS2 o EU AI Act richiedano alla vostra azienda.
- Processi economici che funzionano già. L'AI si adotta un processo alla volta, partendo dal più costoso, non dal più alla moda.
NIS2 è la direttiva UE sulla sicurezza delle reti e dei sistemi informativi, mentre l'EU AI Act stabilisce obblighi in base al livello di rischio di un sistema di AI. Conviene trattare entrambi come requisiti di progettazione fin dall'inizio, con logging, controllo degli accessi e documentazione integrati. Nessuno strumento o architettura garantisce da solo la conformità.
Dove risiedono i dati
Per le aziende SaaS europee la collocazione della copia conta quanto la sua struttura. Quando costruiamo, realizziamo progetti pilota e facciamo test, utilizziamo un'infrastruttura europea self-hosted in Germania, e ciò che sviluppiamo passa a voi: codice sorgente, documentazione e infrastruttura. Consultate software operativo su misura, ospitato e di proprietà nell'UE e perché possedere i propri sistemi operativi evita il lock-in.
Il nostro punto di vista
Un data warehouse è un mezzo. L'obiettivo è che i dati di CRM e finanza coincidano, che le persone che guidano Finance, Sales e Customer Success possano porre una domanda in parole semplici e ottenere una risposta di cui fidarsi, e che qualcuno sia responsabile del risultato.
Per questo costruiamo in un ordine preciso: prima la base dati (data foundation), poi il livello di AI che la legge, quindi gli agenti per i reparti. Invertite l'ordine e otterrete risposte rapide su dati su cui nessuno si è messo d'accordo. Una diversa freschezza per consumatori diversi è una decisione di progettazione, e dovrebbe essere presa da una sola persona che comprenda sia la strategia sia il sistema: è il ruolo di un Fractional Chief AI Officer con esperienza operativa.
Partiamo dal processo più costoso, lo misuriamo e costruiamo solo dove l'AI rende.
Claus Nielsen
Come possiamo aiutarvi
Se l'AI è già in uso nella vostra azienda ma nessuno ne è responsabile, partite da una visione di dove rende e di che cosa i vostri dati possono supportare. L'AI Readiness Assessment parte da €4,500 una tantum. Se desiderate una persona di riferimento che si occupi di AI in modo continuativo, il retainer Fractional Chief AI Officer parte da €3,000 al mese. Potete anche prenotare una discovery call gratuita di 30 minuti tramite il nostro sito.
Le realizzazioni sono quotate o al 30% del risparmio del primo anno, una volta misurato e dimostrato, oppure a prezzo fisso concordato prima dell'inizio dei lavori. Per i dettagli consultate i prezzi.
FAQ
Un operational data warehouse è lo stesso di un operational data store?
Non esattamente, anche se i termini si sovrappongono. Un ODS contiene dati correnti e dettagliati provenienti da più sistemi per il reporting operativo. Un warehouse conserva lo storico consolidato per l'analisi. Alcuni warehouse moderni svolgono entrambi i compiti, per cui i team usano spesso “operational data warehouse” per indicare un unico sistema che fa entrambe le cose.
Quanto devono essere aggiornati i dati di reporting?
Adeguateli a chi li usa, persona o sistema. Chi legge le dashboard di solito ha bisogno di dati vecchi di minuti o ore. Solo le azioni automatizzate su dati in rapida evoluzione tendono a richiedere i secondi. Definite il requisito prima di scegliere gli strumenti, perché ogni passo verso il tempo reale aumenta il costo di esercizio e l'impegno operativo.
Posso fare reporting direttamente dal mio CRM o dal sistema di fatturazione?
Con un solo sistema e un team ridotto, sì. Quando si combinano dati di CRM, finanza e prodotto, oppure un reporting pesante inizia a rallentare i sistemi in cui le persone lavorano, un livello separato tiene il reporting distinto dalle transazioni quotidiane e offre un unico insieme condiviso di definizioni.
Un operational data store mi rende conforme al GDPR?
Nessuno strumento lo fa da solo. Una copia di dati personali resta un dato personale, quindi controllo degli accessi, logging e base giuridica si applicano anche a essa. Confrontatevi con il vostro responsabile della protezione dei dati o con un consulente legale sulla vostra configurazione specifica.
Fonti
- Panoramica sull'operational data store
- Operational data store e data warehouse a confronto
- Tipi e architetture di data warehouse
- Operational data store: scopo, vantaggi e casi d'uso
- L'approccio moderno all'operational data store
- Progettazione dell'architettura di sistemi HTAP
- Come progettare un'architettura di analisi in tempo reale
- Analisi in tempo reale: quando serve e quando no
- Dagli snapshot batch ai dati quasi in tempo reale
- Pipeline di dati quasi in tempo reale con change data capture
- Report TDWI sull'operational data warehousing
- Operational data layer e data warehouse a confronto
- Servizi di Fractional CFO e di reporting finanziario