Un data warehouse operativo reúne en un único lugar los datos actuales de los sistemas de su negocio, como el CRM, la facturación y el soporte, para que los equipos puedan informar sobre lo que ocurre ahora y no sobre el mes pasado. Para una empresa B2B SaaS de entre 20 y 200 personas, la pregunta rara vez es qué producto de warehouse comprar. Es qué datos deben estar actualizados, con qué frecuencia y quién es responsable de la única versión acordada de esos datos. Si acierta en eso, los informes funcionan. Es también el paso que decide si la IA da a su equipo respuestas en las que puede confiar.
Resumen
- Un data warehouse operativo (o almacén de datos operativo, ODS) contiene datos actuales de varios sistemas para los informes del día a día. Un data warehouse clásico contiene historial consolidado para el análisis.
- “Casi en tiempo real” suele significar minutos, no milisegundos. Los paneles para personas rara vez necesitan más, y mayor rapidez cuesta más de mantener.
- Elija la frecuencia de actualización según quién consume los datos: una revisión financiera, una previsión de ventas y una acción automatizada tienen necesidades distintas.
- Acordar una única versión de los datos de CRM y finanzas importa más que las herramientas. Los agentes de IA leen esa versión, así que los errores que haya en ella se convierten en respuestas erróneas.
- Las reglas de seguridad, registro y acceso se aplican a la copia de sus datos operativos exactamente igual que al original. Eso incluye las obligaciones del RGPD.
Índice
- Qué es un data warehouse operativo
- Base de datos operativa, ODS, data warehouse: las diferencias
- Cómo funciona la arquitectura de informes operativos
- Qué significa “casi en tiempo real” en cifras
- Cuándo necesita uno y cuándo no
- Las compensaciones que determinan el diseño
- Por qué los cimientos de datos van antes que la IA
- Dónde no tiene cabida la IA
- Dónde residen los datos
- Cómo podemos ayudarle
- FAQ
- Fuentes
Qué es un data warehouse operativo
El término se usa con poca precisión. En la práctica designa un repositorio que centraliza los datos operativos actuales de sistemas como el CRM, la contabilidad y las ventas, además de fuentes externas, para que pueda informar sobre ellos sin consultar cada sistema por separado.
Para una empresa SaaS, las fuentes son conocidas:
- CRM: cuentas, contactos, pipeline, renovaciones.
- Finanzas: facturas, pagos, suscripciones, calendarios de ingresos.
- Producto: uso, puestos, adopción de funcionalidades.
- Soporte: tickets, escalados, señales de salud de la cuenta.
El valor no está en el almacenamiento. Está en que una pregunta como “¿qué cuentas que renuevan este trimestre tienen escalados abiertos y facturas sin pagar?” reciba una sola respuesta, y no tres hojas de cálculo que no coinciden.
Base de datos operativa, ODS, data warehouse: las diferencias
Cuatro términos se confunden con frecuencia. Así se distinguen.
| Base de datos operativa | Almacén de datos operativo (ODS) | Data warehouse | |
|---|---|---|---|
| Finalidad | Hace funcionar un sistema transaccional, como su CRM o su herramienta de facturación | Datos actuales y detallados de varios sistemas para informes operativos | Historial consolidado y depurado para el análisis |
| Actualización | En vivo | De segundos a minutos u horas | De horas a días |
| Historial | Lo que conserve la aplicación | Corto: datos actuales o recientes | Largo: de meses a años |
| Pregunta típica | “Actualice este registro” | “¿Qué está abierto hoy?” | “¿Cómo ha evolucionado la tasa de cancelación a lo largo de tres años?” |
Las distinciones siguen descripciones publicadas: una base de datos operativa está integrada en un sistema transaccional, un ODS extrae datos transaccionales detallados de varios sistemas con actualizaciones frecuentes, y un almacén de datos es un archivo a largo plazo más estático. Un ODS se sitúa entre los sistemas transaccionales y el almacén de datos analítico, y contiene datos actuales o recientes que se refrescan en un intervalo de minutos a horas, para preguntas como las ventas del mismo día o los casos de soporte activos.
Los rangos de latencia habituales son de segundos a minutos con una retención de días a semanas para un ODS, frente a horas o días con una retención de meses a años para un almacén de datos. Un ODS normalmente se parece a la estructura de los sistemas de origen y es adecuado para informes operativos ligeros, mientras que un almacén de datos aplica una transformación más completa y conserva un historial amplio.
Los almacenes de datos modernos en la nube difuminan esa frontera. Pueden ofrecer disponibilidad de datos en tiempo real y pueden eliminar la necesidad de un ODS independiente. Por eso «almacén de datos operativo» se entiende mejor como la descripción de una función, no de un producto: datos actuales e integrados, lo bastante fiables como para gestionar el negocio con ellos.
Cómo funciona la arquitectura de informes operativos
Sean cuales sean las herramientas, la arquitectura tiene las mismas capas.
- Fuentes. CRM, facturación, base de datos del producto, herramienta de soporte.
- Ingesta. Los datos salen de las fuentes. La captura de cambios en los datos (CDC) envía solo inserciones, actualizaciones y eliminaciones, lo que reduce el volumen de datos movidos y la carga sobre la red y los sistemas de origen.
- Procesamiento. Los datos se limpian, se cruzan entre sistemas (un cliente, un ID) y se estructuran según definiciones acordadas.
- Servicio. Un almacén que responde rápidamente a las consultas de las personas y las herramientas que lo utilizan.
- Consumo. Paneles de control, informes, alertas y asistentes de IA.
Un patrón por capas habitual es un ODS que contiene datos en bruto casi en tiempo real para informes operativos, con capas posteriores que depuran, agregan y sirven los datos. Un diseño frecuente envía las bases de datos transaccionales a colas y después a las capas del almacén de datos, de modo que los informes no ralenticen los sistemas con los que trabaja su equipo. Esa separación es la razón principal para no conectar los paneles directamente a su CRM o a su base de datos de facturación.
Si sus sistemas ya publican los cambios como eventos, el mismo flujo puede apoyarse en ellos. Nuestra guía sobre la arquitectura orientada a eventos explica cómo funciona y dónde encaja.
Qué significa “casi en tiempo real” en cifras
La mayoría de los equipos que piden tiempo real necesitan algo más modesto. Un marco de trabajo de profesionales plantea niveles de actualización de menos de un segundo, de segundos a aproximadamente un minuto, y de minutos a diario. Otro describe el casi tiempo real como aproximadamente de uno a 15 minutos, mediante microlotes o CDC.
Dos ejemplos reales muestran lo que se puede conseguir:
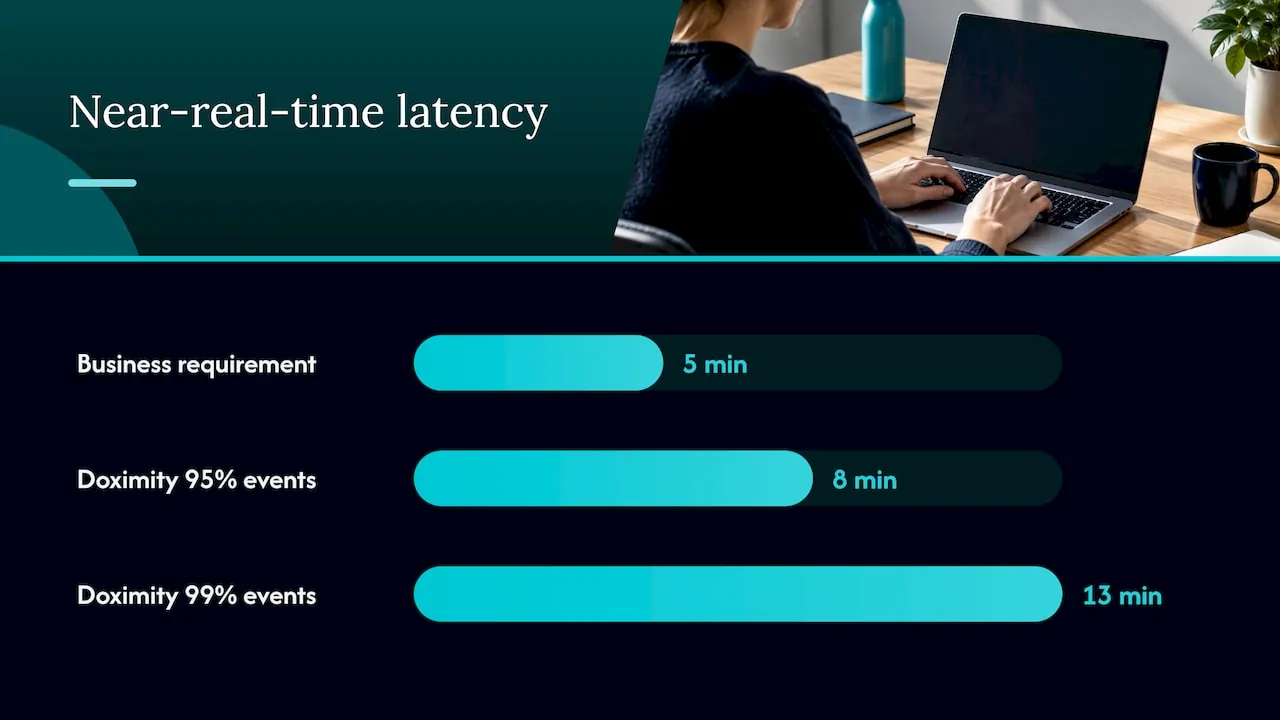
- Un equipo de ingeniería de Doximity informó de que su canal de datos con CDC hacía que los cambios se pudieran consultar en minutos. En una muestra de 12 días, el 95% de los eventos llegó a la capa consultable en ocho minutos y el 99% en 13 minutos.
- Una tesis universitaria construyó un canal de datos con CDC con una latencia media de extremo a extremo de 0.6 segundos con unos 30,000 registros por segundo, y señalaba que el requisito de informes del negocio era de cinco minutos.
El segundo ejemplo es el útil. La ingeniería puede superar el requisito por un amplio margen, y la velocidad adicional no aporta nada al negocio.
También hay una diferencia entre actuar sobre datos en movimiento y consultar datos que acaban de llegar. Las acciones automáticas de detección de fraude o de precios pueden necesitar lo primero, mientras que los paneles que consultan personas suelen necesitar solo datos recientes. Un responsable de ventas que revisa el pipeline o un responsable de finanzas que comprueba los cobros es un panel consultado por personas.
Cuándo necesita uno y cuándo no
Las decisiones operativas sensibles al tiempo son el caso que lo justifica. La investigación sobre almacenes de datos operativos menciona inventario, dotación de personal, previsión de la demanda y paneles de rendimiento como ejemplos respaldados por datos intradía o por hora. Los usos habituales de los informes incluyen paneles de ventas en directo, cumplimiento de pedidos, vistas unificadas del cliente y monitorización.
Una capa operativa de servicio dedicada está justificada cuando el retraso de actualización del almacén de datos es demasiado lento para paneles en directo, comprobaciones de fraude o contexto para la IA, e innecesaria cuando todos los consumidores son analistas y son aceptables horas o días.
Para una empresa SaaS de 20 a 200 personas, una regla viable:
- Informes de gestión semanales o mensuales: basta con una actualización diaria en un almacén consolidado.
- Gestión de cuentas, renovaciones, cobros: la actualización por horas o de minutos entre CRM, finanzas y soporte es donde está el valor.
- Acciones automáticas que modifican registros o desencadenan procesos: actualización de los datos más permisos y aprobación, que tratamos más abajo.
- Streaming de menos de un segundo: rara vez se justifica a su tamaño.
Las compensaciones que determinan el diseño
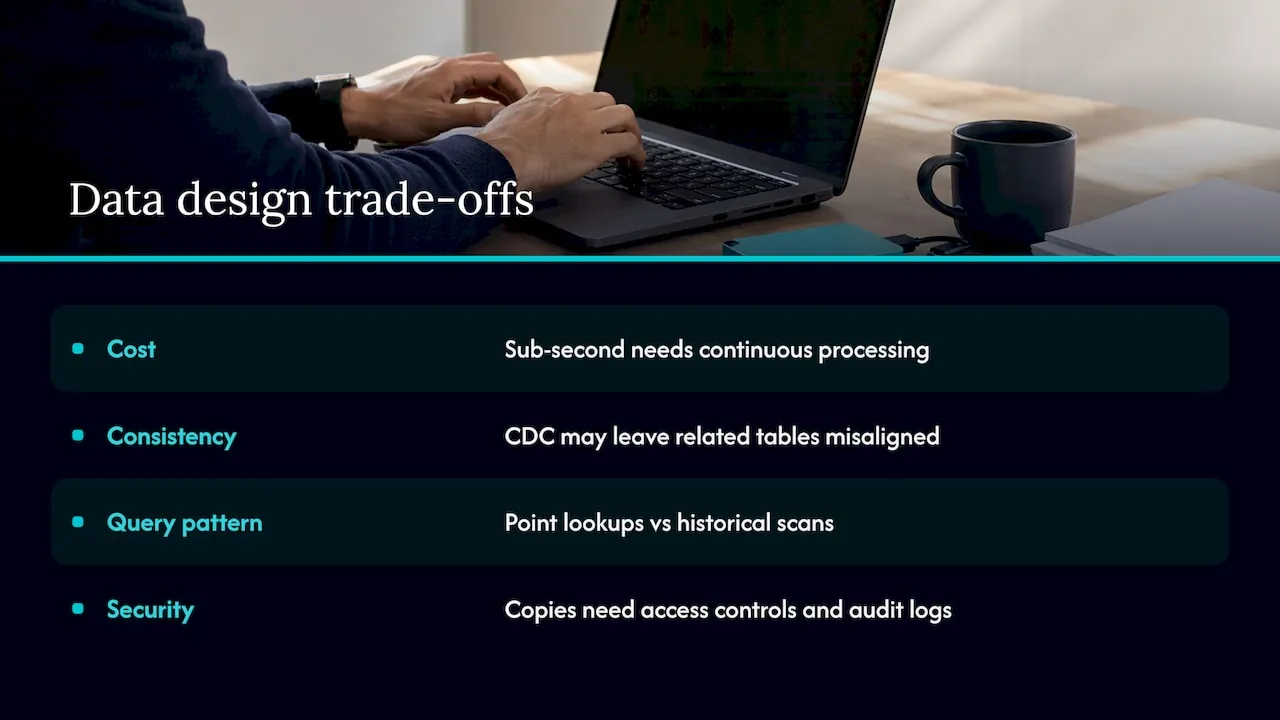
El coste sigue a la latencia. Una actualización de menos de un segundo requiere ingesta, procesamiento y servicio de baja latencia en funcionamiento continuo, mientras que el procesamiento por lotes puede detenerse cuando está inactivo. El streaming también exige conocimientos sobre cambios de esquema, monitorización del retraso, datos tardíos y recuperación. El consejo es elegir la pila más ligera que cumpla el requisito del consumidor, y fijar ese requisito por escrito antes de construir.
Actualizado no es lo mismo que consistente. La CDC puede hacer que cada tabla esté más actualizada sin garantizar que las tablas relacionadas reflejen exactamente el mismo momento. El total de una factura y un registro de suscripción pueden discrepar brevemente. Decida qué informes necesitan una instantánea consistente y cuáles pueden aceptar un pequeño retraso.
Los patrones de consulta difieren. Una capa de streaming precalcula pequeños conjuntos de resultados para búsquedas puntuales, mientras que un almacén de datos recorre el historial para análisis ad hoc. Sus costes dependen de factores distintos, por lo que el patrón de acceso debería guiar la elección.
La seguridad viaja con los datos. Una copia replicada no es una copia informal. Los controles recomendados incluyen acceso por rol, tabla, columna y fila, cifrado en reposo y en tránsito, registro de auditoría y seguimiento del linaje de los datos. Si los datos incluyen datos personales de clientes de la UE, el GDPR se aplica a la copia del mismo modo. Su delegado de protección de datos o su asesor jurídico deben confirmar qué implica esto para su caso, porque este artículo no constituye asesoramiento jurídico.
Por qué los cimientos de datos van antes que la IA
La mayoría de los equipos SaaS que preguntan por un almacén de datos operativo tienen un segundo motivo: quieren que la IA responda preguntas sobre el negocio. Eso convierte la cuestión del almacén de datos en una cuestión de calidad de los datos.
Un asistente de IA que lee dos sistemas con dos definiciones de «cliente activo» da dos respuestas igual de seguras. La solución no es un modelo mejor. Es acordar qué sistema es la fuente de verdad para cada dato, normalmente el CRM para el cliente y finanzas para el dinero, y limpiar los datos para que coincidan. Lo tratamos en CRM y cimientos de datos antes de los agentes de IA y en nuestra guía de estrategia de integración de datos para equipos SaaS.
El orden en que trabajamos es:
- Cimientos de datos. El CRM, los sistemas que lo rodean y el Processor, que convierte los datos en una única versión acordada de la verdad. El Processor es donde se realiza ese trabajo.
- Capa de IA. MCP conecta esos datos con el asistente de IA que su empresa ya utiliza.
- Agentes por departamento. Agentes diseñados para Finanzas, Ventas y Customer Success, que su equipo usa en lenguaje natural para extraer datos (preguntar, elaborar informes, consultar) y enviar datos (actualizar registros, desencadenar procesos, conceder accesos), dentro de los permisos, con aprobación cuando haga falta y con un registro de auditoría. Consulte Agentes de IA para Finanzas, Ventas y Customer Success.
El área financiera es donde los datos actualizados e integrados rinden antes. Los cobros, la previsión de tesorería y el seguimiento del presupuesto dependen de que los datos de facturación, del CRM y del banco coincidan. Para ver ejemplos concretos de paneles y decisiones financieras, observe cómo la previsión del flujo de caja y los informes de rendimiento dependen de cifras actuales.
Dónde no tiene cabida la IA
Ser explícito en este punto ahorra dinero.
- Donde los datos no están acordados. Si ventas y finanzas no coinciden en los ingresos, primero hay que fijar las definiciones. Poner IA encima solo oculta el desacuerdo.
- Decisiones que exigen actuar en menos de un segundo sobre dinero o accesos sin aprobación ni registro de auditoría. Mantenga a una persona en el circuito.
- Criterio jurídico. La IA puede preparar información. No decide qué le exigen el GDPR, la NIS2 o el EU AI Act.
- Procesos baratos que ya funcionan. La IA se adopta proceso a proceso, empezando por el más caro, no por el más de moda.
La NIS2 es la directiva de la UE sobre seguridad de las redes y de la información, y el EU AI Act establece obligaciones según el nivel de riesgo de un sistema de IA. Lo mejor es tratar ambos como requisitos de diseño desde el principio, con registro, control de accesos y documentación integrados. Ninguna herramienta ni arquitectura garantiza por sí sola el cumplimiento.
Dónde residen los datos
Para las empresas SaaS europeas, la ubicación de la copia importa tanto como su estructura. Cuando construimos, realizamos pilotos y probamos, utilizamos infraestructura europea autoalojada en Alemania, y lo que construimos se le transfiere a usted: código fuente, documentación e infraestructura. Consulte software operativo a medida, alojado y de su propiedad en la UE y cómo ser propietario de sus sistemas operativos evita la dependencia de un proveedor.
Nuestra opinión
Un data warehouse es un medio. El objetivo es que sus datos de CRM y de finanzas coincidan, que quienes dirigen Finanzas, Ventas y Customer Success puedan hacer una pregunta con palabras sencillas y obtener una respuesta de confianza, y que alguien sea responsable del resultado.
Por eso construimos en un orden fijo: primero la base de datos (data foundation), después la capa de IA que la lee y, por último, los agentes por departamento. Si se invierte el orden, se obtienen respuestas rápidas sobre datos que nadie ha acordado. Que distintos consumidores tengan distinta frescura de datos es una decisión de diseño, y debe tomarla una sola persona que entienda tanto la estrategia como el sistema, que es el papel de un Fractional Chief AI Officer con experiencia operativa.
Empezamos por el proceso más caro, lo medimos y construimos solo donde la IA compensa.
Claus Nielsen
Cómo podemos ayudarle
Si en su empresa ya se usa IA pero nadie es responsable de ella, empiece por una visión de dónde compensa y qué puede sustentar su información. El AI Readiness Assessment parte de €4,500 como pago único. Si desea que una persona concreta se encargue de la IA de forma continuada, la suscripción de Fractional Chief AI Officer parte de €3,000 al mes. También puede reservar una llamada de descubrimiento gratuita de 30 minutos a través de nuestro sitio.
Los desarrollos se presupuestan, o bien como el 30% del ahorro del primer año, una vez medido y demostrado, o bien a un precio cerrado acordado antes de empezar el trabajo. Consulte los precios para más detalles.
FAQ
¿Es lo mismo un data warehouse operativo que un operational data store?
No exactamente, aunque los términos se solapan. Un ODS contiene datos actuales y detallados de varios sistemas para informes operativos. Un warehouse conserva el historial consolidado para el análisis. Algunos warehouses modernos cubren ambas funciones, por lo que los equipos suelen usar «data warehouse operativo» para un único sistema que hace las dos cosas.
¿Qué grado de actualización necesitan los datos de reporting?
Ajústelo a la persona o al sistema que los usa. Las personas que leen paneles suelen necesitar datos de hace minutos u horas. Solo las acciones automatizadas sobre datos que cambian rápido suelen necesitar segundos. Defina el requisito antes de elegir herramientas, porque cada paso hacia el tiempo real aumenta el coste de funcionamiento y el esfuerzo operativo.
¿Puedo hacer informes directamente desde mi CRM o mi sistema de facturación?
Con un solo sistema y un equipo pequeño, sí. Cuando se combinan datos de CRM, finanzas y producto, o cuando los informes pesados empiezan a ralentizar los sistemas en los que trabaja la gente, una capa independiente separa el reporting de las transacciones diarias y le da un único conjunto de definiciones acordadas.
¿Un operational data store me hace cumplir el GDPR?
Ninguna herramienta lo logra por sí sola. Una copia de datos personales sigue siendo un dato personal, por lo que le son aplicables el control de accesos, el registro y una base jurídica. Consulte con su delegado de protección de datos o con su asesor jurídico sobre su configuración concreta.
Fuentes
- Visión general del operational data store
- Operational data store frente a data warehouse
- Tipos y arquitecturas de data warehouse
- Operational data stores: finalidad, ventajas y casos de uso
- Enfoque moderno del operational data store
- Diseño de la arquitectura de sistemas HTAP
- Cómo diseñar una arquitectura de analítica en tiempo real
- Analítica en tiempo real: cuándo la necesita y cuándo no
- De las instantáneas por lotes a los datos en casi tiempo real
- Pipeline de datos en casi tiempo real con captura de datos de cambios
- Informe de TDWI sobre data warehousing operativo
- Capa de datos operativa frente a data warehouse
- Fractional CFO y servicios de reporting financiero