Et operationelt data warehouse samler aktuelle data fra dine forretningssystemer, for eksempel CRM, fakturering og support, ét sted, så teams kan rapportere på det, der sker nu, og ikke sidste måned. For en B2B SaaS-virksomhed med 20 til 200 medarbejdere er spørgsmålet sjældent, hvilket warehouse-produkt man skal købe. Det er, hvilke data der skal være friske, hvor friske de skal være, og hvem der ejer den ene aftalte version af dem. Når det er på plads, fungerer rapporteringen. Det er også det trin, der afgør, om AI giver dit team svar, du kan stole på.
Kort fortalt
- Et operationelt data warehouse (eller operationelt data store, ODS) rummer aktuelle data fra flere systemer til daglig rapportering. Et klassisk data warehouse rummer konsolideret historik til analyse.
- “Næsten realtid” betyder normalt minutter, ikke millisekunder. Dashboards til mennesker har sjældent brug for mere, og hurtigere koster mere at drive.
- Vælg aktualitet efter, hvem der bruger dataene: et økonomimøde, en salgsprognose og en automatiseret handling har forskellige behov.
- At blive enige om én version af CRM- og økonomidata betyder mere end værktøjerne. AI-agenter læser den version, så fejl i den bliver til forkerte svar.
- Regler for sikkerhed, logning og adgang gælder for kopien af dine driftsdata på præcis samme måde som for originalen. Det omfatter forpligtelserne i GDPR.
Indholdsfortegnelse
- Hvad et operationelt data warehouse er
- Operationel database, ODS, data warehouse: forskellene
- Sådan fungerer en arkitektur til operationel rapportering
- Hvad “næsten realtid” betyder i tal
- Hvornår du har brug for et, og hvornår du ikke har
- De afvejninger, der afgør designet
- Hvorfor datafundamentet kommer før AI
- Hvor AI ikke hører hjemme
- Hvor dataene ligger
- Sådan kan vi hjælpe
- FAQ
- Kilder
Hvad et operationelt data warehouse er
Begrebet bruges løst. I praksis betyder det et lager, der samler aktuelle driftsdata fra systemer som CRM, regnskab og salg, plus eksterne datakilder, så du kan rapportere på dem uden at forespørge hvert system for sig.
For en SaaS-virksomhed er kilderne velkendte:
- CRM: kunder, kontakter, pipeline, fornyelser.
- Økonomi: fakturaer, betalinger, abonnementer, indtægtsplaner.
- Produkt: brug, licenser, anvendelse af funktioner.
- Support: tickets, eskaleringer, sundhedssignaler.
Værdien ligger ikke i lagringen. Den ligger i, at et spørgsmål som “hvilke kunder, der fornyer i dette kvartal, har åbne eskaleringer og ubetalte fakturaer?” får ét svar og ikke tre regneark, der er uenige.
Operationel database, ODS, data warehouse: forskellene
Fire begreber bliver blandet sammen. Sådan adskiller de sig.
| Operationel database | Operationelt data store (ODS) | Data warehouse | |
|---|---|---|---|
| Formål | Driver et transaktionssystem, for eksempel dit CRM eller faktureringsværktøj | Aktuelle, detaljerede data fra flere systemer til operationel rapportering | Konsolideret, renset historik til analyse |
| Aktualitet | Live | Sekunder til minutter eller timer | Timer til dage |
| Historik | Det, som applikationen gemmer | Kort: aktuelle eller seneste data | Lang: måneder til år |
| Typisk spørgsmål | “Opdater denne post” | “Hvad er åbent i dag?” | “Hvordan udviklede kundeafgangen sig over tre år?” |
Skellene følger offentliggjorte beskrivelser: en operationel database er indbygget i et transaktionssystem, et ODS henter detaljerede transaktionsdata fra flere systemer med hyppige opdateringer, og et data warehouse er et mere statisk langtidsarkiv. Et ODS placerer sig mellem de transaktionelle systemer og det analytiske data warehouse og rummer aktuelle eller nylige data, der opdateres med intervaller fra minutter til timer, til spørgsmål som salg samme dag eller aktive supportsager.
Typiske latensintervaller er sekunder til minutter med dages til ugers opbevaring for et ODS, mod timer til dage med måneders til års opbevaring for et data warehouse. Et ODS ligner som regel kildesystemernes struktur og egner sig til let operationel rapportering, mens et data warehouse anvender mere omfattende transformation og gemmer en stor historik.
Moderne cloud-data warehouses udvisker grænsen. De kan levere tilgængelighed af realtidsdata og kan fjerne behovet for et separat ODS. Derfor læses “operationelt data warehouse” bedst som en jobbeskrivelse og ikke som et produkt: aktuelle, integrerede data, pålidelige nok til at drive virksomheden på.
Sådan fungerer en arkitektur til operationel rapportering
Uanset værktøjerne har arkitekturen de samme lag.
- Kilder. CRM, fakturering, produktdatabase, supportværktøj.
- Indlæsning. Data flyttes ud af kilderne. Change data capture (CDC) sender kun indsættelser, opdateringer og sletninger, hvilket reducerer den datamængde, der flyttes, og belastningen på netværket og kildesystemerne.
- Bearbejdning. Data renses, matches på tværs af systemer (én kunde, ét ID) og formes efter aftalte definitioner.
- Levering. Et lager, der besvarer forespørgsler hurtigt for de personer og værktøjer, der bruger dem.
- Anvendelse. Dashboards, rapporter, alarmer og AI-assistenter.
Et almindeligt lagdelt mønster er et ODS, der rummer rå data i næsten realtid til operationelle rapporter, med efterfølgende lag, der renser, aggregerer og leverer. Et hyppigt design fører transaktionsdatabaser ind i køer og derefter ind i data warehouse-lag, så rapportering ikke gør de systemer langsommere, som jeres team arbejder i. Den adskillelse er hovedårsagen til ikke at pege dashboards direkte på jeres CRM- eller faktureringsdatabase.
Hvis jeres systemer allerede udgiver ændringer som hændelser, kan det samme flow bygge på det. Vores guide til hændelsesdrevet arkitektur viser, hvordan det fungerer, og hvor det passer ind.
Hvad “næsten realtid” betyder i tal
De fleste teams, der beder om realtid, har brug for noget mere beskedent. En praktikerramme angiver friskhedsniveauer på under et sekund, sekunder til omkring et minut og minutter til dagligt. En anden beskriver næsten realtid som cirka et til 15 minutter ved brug af mikrobatches eller CDC.
To virkelige eksempler viser, hvad der kan opnås:
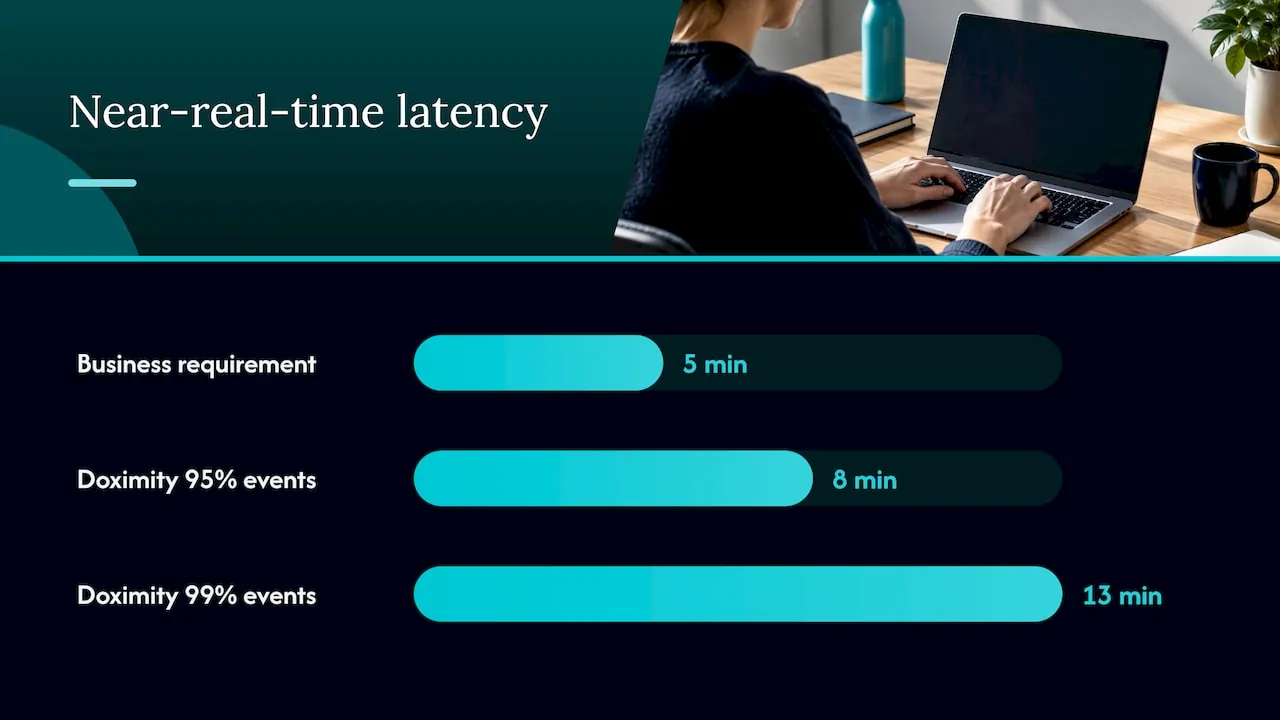
- Et engineeringteam hos Doximity rapporterede, at deres CDC-pipeline gjorde ændringer forespørgselsklare i løbet af minutter. I en stikprøve over 12 dage nåede 95 % af hændelserne frem til det forespørgselsklare lag inden for otte minutter og 99 % inden for 13 minutter.
- Et universitetsspeciale byggede en CDC-pipeline med en gennemsnitlig end-to-end-latens på 0,6 sekunder ved omkring 30.000 poster i sekundet, og bemærkede samtidig, at forretningens krav til rapportering var fem minutter.
Det andet eksempel er det nyttige. Engineering kan slå kravet med stor margin, og den ekstra hastighed giver forretningen ingenting.
Der er også forskel på at handle på data i bevægelse og at forespørge data, der netop er ankommet. Automatiserede handlinger ved svindel eller prissætning kan have brug for det første, mens menneskers dashboards som regel kun har brug for nylige data. En salgschef, der gennemgår pipeline, eller en finansansvarlig, der tjekker inddrivelse, er et dashboard for mennesker.
Hvornår du har brug for et, og hvornår du ikke har
Tidskritiske operationelle beslutninger er argumentet for det. Forskning i operationelle data warehouses nævner lagerbeholdning, bemanding, efterspørgselsprognoser og performance-dashboards som eksempler, der understøttes af data fra samme dag eller time for time. Almindelige anvendelser i rapportering er live salgsdashboards, ordreopfyldelse, samlede kundeoversigter og overvågning.
Et dedikeret operationelt leveringslag er berettiget, når opdateringsforsinkelsen i et data warehouse er for langsom til live dashboards, svindelkontroller eller AI-kontekst, og unødvendigt, når alle brugere er analytikere, og timer eller dage er acceptable.
For en SaaS-virksomhed med 20 til 200 medarbejdere er en brugbar tommelfingerregel:
- Ugentlig eller månedlig ledelsesrapportering: en daglig opdatering til et samlet lager er nok.
- Kundeansvar, fornyelser, inddrivelse: time- eller minutfriskhed på tværs af CRM, økonomi og support er der, hvor værdien ligger.
- Automatiserede handlinger, der ændrer poster eller udløser processer: friskhed plus rettigheder og godkendelse, som behandles nedenfor.
- Streaming under et sekund: sjældent berettiget i jeres størrelse.
De afvejninger, der afgør designet
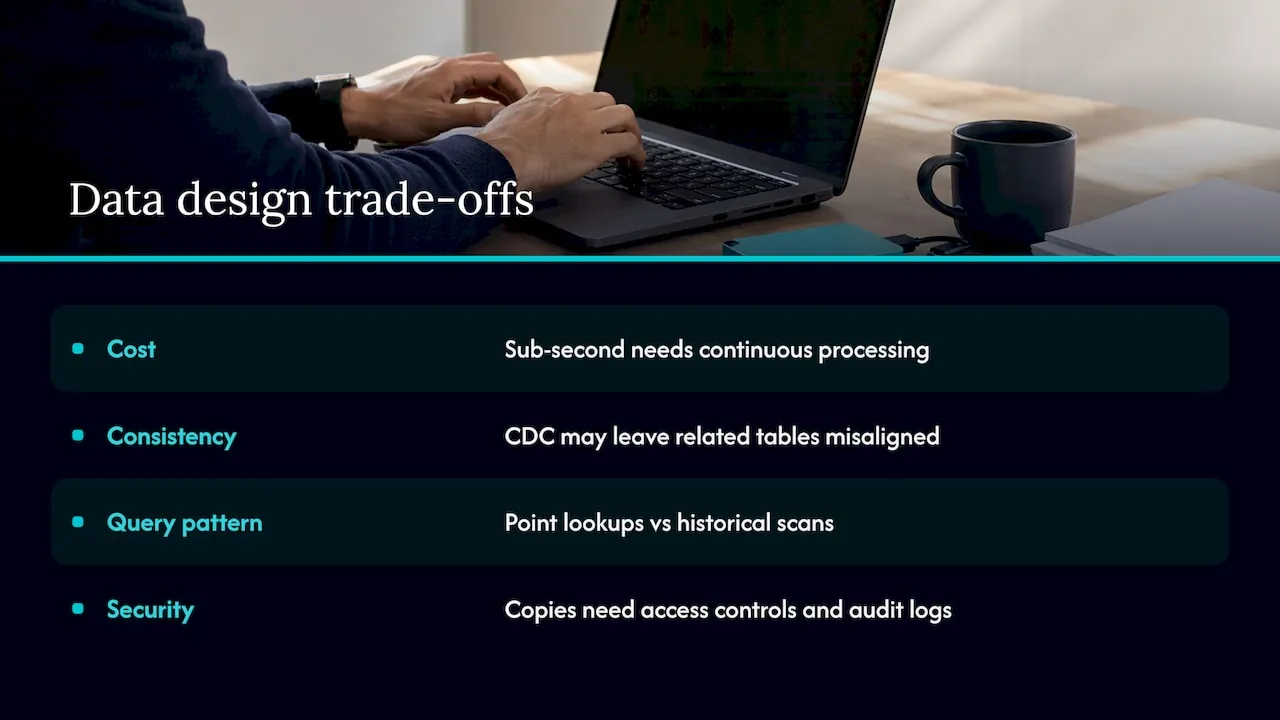
Prisen følger latensen. Friskhed under et sekund kræver kontinuerligt kørende indlæsning, bearbejdning og levering med lav latens, mens batch kan stå stille, når der intet er at gøre. Streaming kræver også kompetencer inden for skemaændringer, overvågning af forsinkelse, sene data og genopretning. Rådet er at vælge den letteste stack, der opfylder brugerens krav, og at fastsætte kravet skriftligt, før I bygger.
Frisk er ikke det samme som konsistent. CDC kan gøre hver enkelt tabel friskere uden at garantere, at relaterede tabeller afspejler nøjagtig samme tidspunkt. Et fakturabeløb og en abonnementspost kan kortvarigt være uenige. Beslut, hvilke rapporter der kræver et konsistent snapshot, og hvilke der kan acceptere en lille forsinkelse.
Forespørgselsmønstrene er forskellige. Et streaminglag forudberegner små resultatsæt til punktopslag, mens et data warehouse gennemsøger historik til ad hoc-analyse. Deres omkostninger følger forskellige drivere, så adgangsmønstret bør styre valget.
Sikkerheden følger med dataene. En replikeret kopi er ikke en uformel kopi. Anbefalede kontroller omfatter adgang på rolle-, tabel-, kolonne- og rækkeniveau, kryptering i hvile og under overførsel, auditlogning og sporing af datas oprindelse. Hvis dataene omfatter personoplysninger om kunder i EU, gælder GDPR for kopien på samme måde. Jeres databeskyttelsesrådgiver eller jurist bør bekræfte, hvad det betyder for jeres opsætning, da denne artikel ikke er juridisk rådgivning.
Hvorfor datafundamentet kommer før AI
De fleste SaaS-teams, der spørger til et operationelt data warehouse, har et andet motiv: de vil have AI til at besvare spørgsmål om forretningen. Det gør spørgsmålet om data warehouse til et spørgsmål om datakvalitet.
En AI-assistent, der læser to systemer med to definitioner af “aktiv kunde”, giver to sikre svar. Løsningen er ikke en bedre model. Den er at blive enige om, hvilket system der er sandhedskilden for hvert faktum, som regel CRM for kunden og økonomi for penge, og at rense dataene, så de passer. Det behandler vi i CRM og datagrundlag før AI-agenter og i vores guide til dataintegrationsstrategi for SaaS-teams.
Vi arbejder i denne rækkefølge:
- Datagrundlag. CRM, systemerne omkring det og Processor, der omsætter dataene til én aftalt version af sandheden. Processor er der, hvor det arbejde foregår.
- AI-lag. MCP forbinder dataene med den AI-assistent, som jeres virksomhed allerede bruger.
- Afdelingsagenter. Specialbyggede agenter til Finance, Sales og Customer Success, som jeres medarbejdere bruger på almindeligt sprog til at hente data (spørge, rapportere, slå op) og sende data (opdatere poster, udløse processer, tildele adgang), inden for rettigheder, med godkendelse, hvor det er nødvendigt, og et revisionsspor. Se AI-agenter til økonomi, salg og kundesucces.
Det er på økonomisiden, at friske, integrerede data betaler sig først. Inddrivelse, likviditetsprognoser og budgetopfølgning afhænger alle af, at fakturerings-, CRM- og bankdata stemmer overens. For konkrete eksempler på økonomidashboards og beslutninger kan du se på, hvordan likviditetsprognoser og performancerapportering afhænger af aktuelle tal.
Hvor AI ikke hører hjemme
At være tydelig her sparer penge.
- Hvor data ikke er aftalt. Hvis salg og økonomi er uenige om omsætningen, så ret definitionerne først. AI oven på skjuler kun uenigheden.
- Beslutninger, der kræver handling på under et sekund over for penge eller adgang uden godkendelse eller revisionsspor. Hav et menneske med i loopet.
- Juridisk skøn. AI kan forberede information. Den afgør ikke, hvad GDPR, NIS2 eller EU AI Act kræver af jer.
- Processer, der er billige og allerede fungerer. AI indføres én proces ad gangen, begyndende med den dyreste, ikke den mest moderigtige.
NIS2 er EU-direktivet om net- og informationssikkerhed, og EU AI Act fastsætter forpligtelser efter risikoniveauet for et AI-system. Begge behandles bedst som designkrav fra start, med logning, adgangskontrol og dokumentation indbygget. Intet værktøj eller nogen arkitektur kan i sig selv garantere compliance.
Hvor dataene ligger
For europæiske SaaS-virksomheder betyder kopiens placering lige så meget som dens struktur. Når vi bygger, kører pilotprojekter og tester, bruger vi selvhostet europæisk infrastruktur i Tyskland, og det, vi bygger, overdrages til jer: kildekode, dokumentation og infrastruktur. Se skræddersyet operationel software, hostet og ejet i EU og hvorfor det at eje jeres operationelle systemer undgår lock-in.
Vores syn
Et data warehouse er et middel. Målet er, at jeres CRM- og økonomidata stemmer overens, at de personer, der leder økonomi, salg og customer success, kan stille et spørgsmål i almindeligt sprog og få et svar, de stoler på, og at nogen er ansvarlig for resultatet.
Derfor bygger vi i en fast rækkefølge: først datafundamentet, derefter AI-laget, der læser det, og så afdelingsagenter. Vender man rækkefølgen om, får man hurtige svar på data, som ingen har aftalt. Forskellig friskhed for forskellige brugere er en designbeslutning, og den bør træffes af én person, der forstår både strategien og systemet, hvilket er rollen for en Fractional Chief AI Officer med operationel erfaring.
Vi starter med den dyreste proces, måler den og bygger kun, hvor AI betaler sig.
Claus Nielsen
Sådan kan vi hjælpe
Hvis AI allerede er i brug i jeres virksomhed, men ingen har ansvaret for det, så start med et overblik over, hvor det betaler sig, og hvad jeres data kan understøtte. AI Readiness Assessment starter fra €4,500 som engangsbeløb. Hvis I ønsker én navngiven person til at eje AI løbende, starter Fractional Chief AI Officer-retaineren fra €3,000 pr. måned. I kan også booke et gratis opdagelsesmøde på 30 minutter via vores side.
Opbygninger prissættes enten som 30% af det første års besparelse, når den er målt og bevist, eller til en fast pris aftalt, før arbejdet starter. Se priser for detaljer.
FAQ
Er et operationelt data warehouse det samme som et operational data store?
Ikke helt, selvom begreberne overlapper. Et ODS indeholder aktuelle, detaljerede data fra flere systemer til operationel rapportering. Et warehouse gemmer konsolideret historik til analyse. Nogle moderne warehouses dækker begge opgaver, så teams bruger ofte “operationelt data warehouse” om ét system, der gør begge dele.
Hvor friske skal rapporteringsdata være?
Tilpas det til den person eller det system, der bruger dem. Mennesker, der læser dashboards, har normalt brug for data, der er minutter til timer gamle. Kun automatiserede handlinger på hurtigt skiftende data har tendens til at kræve sekunder. Fastlæg kravet, før I vælger værktøjer, for hvert skridt mod realtid øger driftsomkostningerne og den operationelle indsats.
Kan jeg rapportere direkte fra mit CRM- eller faktureringssystem?
Med ét system og et lille team, ja. Når I kombinerer CRM-, økonomi- og produktdata, eller tung rapportering begynder at bremse de systemer, folk arbejder i, holder et separat lag rapporteringen adskilt fra den daglige transaktionsbehandling og giver jer ét aftalt sæt definitioner.
Gør et operational data store mig GDPR-compliant?
Intet værktøj gør det i sig selv. En kopi af personoplysninger er stadig personoplysninger, så adgangskontrol, logning og et lovligt grundlag gælder også for den. Tal med jeres databeskyttelsesrådgiver eller juridiske rådgiver om jeres konkrete setup.
Kilder
- Oversigt over operational data store
- Operational data store vs. data warehouse
- Typer og arkitekturer for data warehouses
- Operational data stores: formål, fordele og anvendelser
- Moderne tilgang til operational data store
- Systemarkitekturdesign for HTAP
- Sådan designer du en arkitektur til realtidsanalyse
- Realtidsanalyse: hvornår du har brug for den, og hvornår ikke
- Fra batch-snapshots til data i næsten realtid
- Datapipeline i næsten realtid med change data capture
- TDWI-rapport om operationelle data warehouses
- Operationelt datalag vs. data warehouse
- Fractional CFO og ydelser inden for økonomisk rapportering