Ett operativt datalager samlar aktuell data från dina affärssystem, som CRM, fakturering och support, på en och samma plats så att team kan rapportera om vad som händer nu, inte förra månaden. För ett B2B SaaS-bolag med 20 till 200 anställda är frågan sällan vilken datalagerprodukt man ska köpa. Frågan är vilken data som måste vara färsk, hur färsk, och vem som äger den enda överenskomna versionen av den. Får du det rätt fungerar rapporteringen. Det är också steget som avgör om AI ger ditt team svar som du kan lita på.
Kort sagt
- Ett operativt datalager (eller operational data store, ODS) innehåller aktuell data från flera system för daglig rapportering. Ett klassiskt datalager innehåller konsoliderad historik för analys.
- ”Nära realtid” betyder oftast minuter, inte millisekunder. Dashboards för människor behöver sällan mer, och snabbare kostar mer att driva.
- Välj aktualitet per mottagare: en ekonomigenomgång, en säljprognos och en automatiserad åtgärd har olika behov.
- Att enas om en version av CRM- och ekonomidata är viktigare än verktygen. AI-agenter läser den versionen, så fel där blir felaktiga svar.
- Säkerhet, loggning och åtkomstregler gäller kopian av din operativa data på exakt samma sätt som originalet. Det inkluderar GDPR-skyldigheter.
Innehållsförteckning
- Vad ett operativt datalager är
- Operativ databas, ODS, datalager: skillnaderna
- Så fungerar arkitekturen för operativ rapportering
- Vad ”nära realtid” betyder i siffror
- När du behöver ett, och när du inte gör det
- Avvägningarna som avgör utformningen
- Varför datagrunden kommer före AI
- Där AI inte hör hemma
- Var datan finns
- Så kan vi hjälpa till
- FAQ
- Källor
Vad ett operativt datalager är
Termen används löst. I praktiken avser den ett arkiv som samlar aktuell operativ data från system som CRM, redovisning och försäljning, plus externa flöden, så att du kan rapportera på den utan att fråga varje system separat.
För ett SaaS-bolag är källorna välkända:
- CRM: konton, kontakter, pipeline, förnyelser.
- Ekonomi: fakturor, betalningar, prenumerationer, intäktsscheman.
- Produkt: användning, licenser, användning av funktioner.
- Support: ärenden, eskaleringar, hälsosignaler.
Värdet ligger inte i lagringen. Det ligger i att en fråga som ”vilka konton som förnyas detta kvartal har öppna eskaleringar och obetalda fakturor?” får ett svar, inte tre kalkylblad som säger emot varandra.
Operativ databas, ODS, datalager: skillnaderna
Fyra termer blandas ihop. Så här skiljer de sig åt.
| Operativ databas | Operational data store (ODS) | Datalager | |
|---|---|---|---|
| Syfte | Driver ett transaktionssystem, till exempel ditt CRM eller faktureringsverktyg | Aktuell, detaljerad data från flera system för operativ rapportering | Konsoliderad, rensad historik för analys |
| Aktualitet | Live | Sekunder till minuter eller timmar | Timmar till dagar |
| Historik | Det som appen sparar | Kort: aktuell eller nylig data | Lång: månader till år |
| Typisk fråga | ”Uppdatera den här posten” | ”Vad är öppet idag?” | ”Hur utvecklades kundbortfallet under tre år?” |
Distinktionerna följer publicerade beskrivningar: en operativ databas är inbyggd i ett transaktionssystem, en ODS hämtar detaljerad transaktionsdata från flera system med täta uppdateringar, och ett datalager är ett mer statiskt långtidsarkiv. En ODS ligger mellan transaktionssystemen och det analytiska datalagret och innehåller aktuella eller färska data som uppdateras med intervall från minuter till timmar, för frågor som försäljning samma dag eller aktiva supportärenden.
Typiska latensintervall är sekunder till minuter med lagring i dagar till veckor för en ODS, mot timmar till dagar med lagring i månader till år för ett datalager. En ODS liknar vanligtvis källsystemens struktur och passar för enklare operativ rapportering, medan ett datalager tillämpar mer omfattande transformering och sparar en stor historik.
Moderna molnbaserade datalager suddar ut gränsen. De kan erbjuda tillgång till data i realtid och kan göra en separat ODS onödig. ”Operativt datalager” ska därför snarast förstås som en jobbeskrivning, inte som en produkt: aktuella, integrerade data som är tillräckligt tillförlitliga för att driva verksamheten på.
Så fungerar arkitekturen för operativ rapportering
Oavsett verktyg har arkitekturen samma lager.
- Källor. CRM, fakturering, produktdatabas, supportverktyg.
- Inhämtning. Data flyttas ut från källorna. Change data capture (CDC) skickar bara inläggningar, uppdateringar och borttagningar, vilket minskar den flyttade datamängden och belastningen på nätverket och källsystemen.
- Bearbetning. Data rensas, matchas mellan system (en kund, ett ID) och formas efter överenskomna definitioner.
- Leverans. Ett lager som snabbt besvarar frågor från de personer och verktyg som använder datan.
- Användning. Dashboards, rapporter, aviseringar och AI-assistenter.
Ett vanligt lagerindelat mönster är en ODS som håller rådata i nära realtid för operativa rapporter, med efterföljande lager som rensar, aggregerar och levererar. En vanlig design matar transaktionsdatabaser in i köer och sedan in i datalagrets lager, så att rapporteringen inte gör de system som ert team arbetar i långsammare. Den uppdelningen är den främsta anledningen till att inte peka dashboards direkt mot ert CRM eller er faktureringsdatabas.
Om era system redan publicerar ändringar som händelser kan samma flöde använda dem. Vår guide om händelsedriven arkitektur visar hur det fungerar och var det passar.
Vad ”nära realtid” betyder i siffror
De flesta team som ber om realtid behöver något mer blygsamt. Ett ramverk från praktiker anger färskhetsnivåer på under en sekund, sekunder till ungefär en minut, och minuter till dagligen. Ett annat beskriver nära realtid som ungefär en till 15 minuter, med mikrobatchar eller CDC.
Två verkliga exempel visar vad som är möjligt:
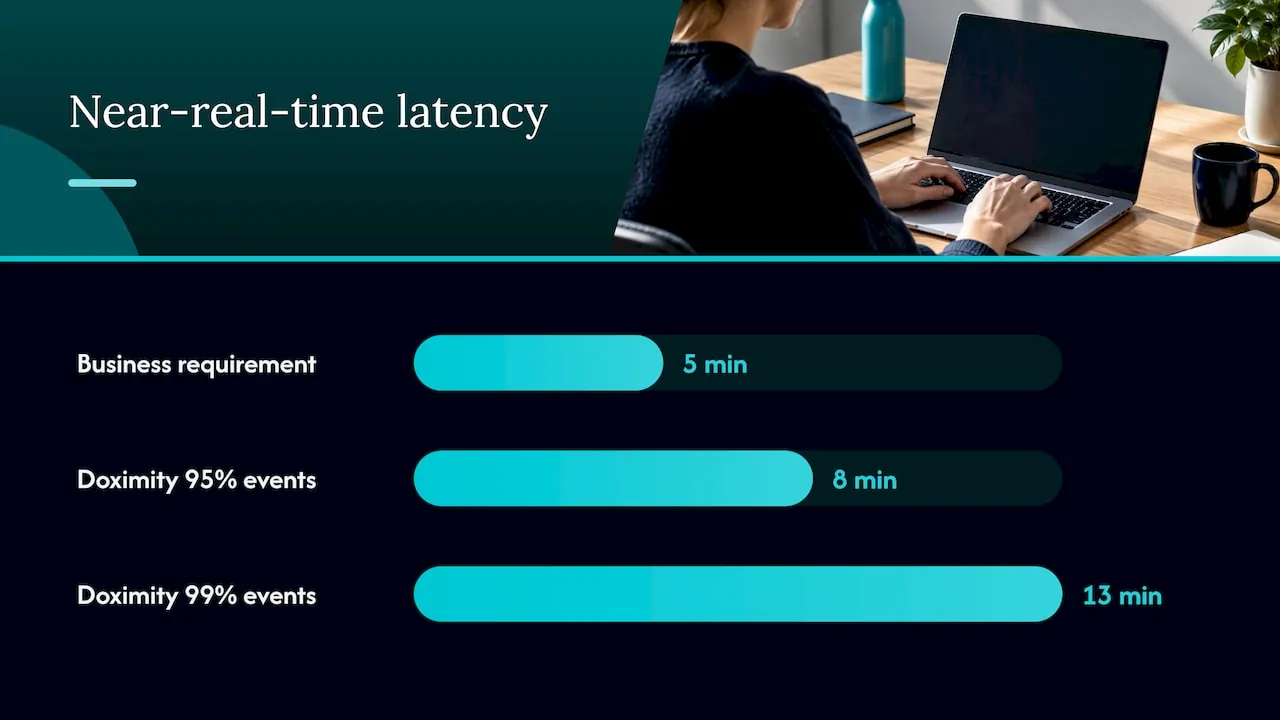
- Ett utvecklingsteam på Doximity rapporterade att deras CDC-pipeline gjorde ändringar sökbara inom några minuter. I ett urval över 12 dagar nådde 95% av händelserna det sökbara lagret inom åtta minuter och 99% inom 13 minuter.
- En universitetsuppsats byggde en CDC-pipeline med en genomsnittlig latens från början till slut på 0,6 sekunder vid cirka 30,000 poster per sekund, samtidigt som den noterade att verksamhetens rapporteringskrav var fem minuter.
Det andra exemplet är det användbara. Tekniken kan slå kravet med bred marginal, och den extra hastigheten ger verksamheten ingenting.
Det är också skillnad på att agera på data i rörelse och att fråga efter data som nyligen kommit in. Automatiserade bedrägeri- eller prisåtgärder kan behöva det förra, medan dashboards för människor oftast bara behöver färska data. En säljchef som går igenom pipelinen eller en finanschef som kontrollerar inkasso använder en dashboard för människor.
När du behöver ett, och när du inte gör det
Tidskänsliga operativa beslut är argumentet för det. Forskning om operativa datalager anger lager, bemanning, efterfrågeprognoser och prestandadashboards som exempel som stöds av data inom dygnet eller varje timme. Vanliga rapporteringsområden är liveförsäljningsdashboards, orderhantering, samlade kundvyer och övervakning.
Ett dedikerat operativt leveranslager är motiverat när datalagrets uppdateringsfördröjning är för långsam för livedashboards, bedrägerikontroller eller AI-kontext, och onödigt när alla användare är analytiker och timmar eller dagar är acceptabelt.
För ett SaaS-bolag med 20 till 200 anställda fungerar denna tumregel:
- Veckovis eller månadsvis ledningsrapportering: en daglig uppdatering till ett samlat lager räcker.
- Kundansvar, förnyelser, inkasso: färskhet på timmar eller minuter över CRM, ekonomi och support är där värdet finns.
- Automatiserade åtgärder som ändrar poster eller startar processer: färskhet plus behörigheter och godkännande, vilket behandlas nedan.
- Strömning under en sekund: sällan motiverat i er storlek.
Avvägningarna som avgör utformningen
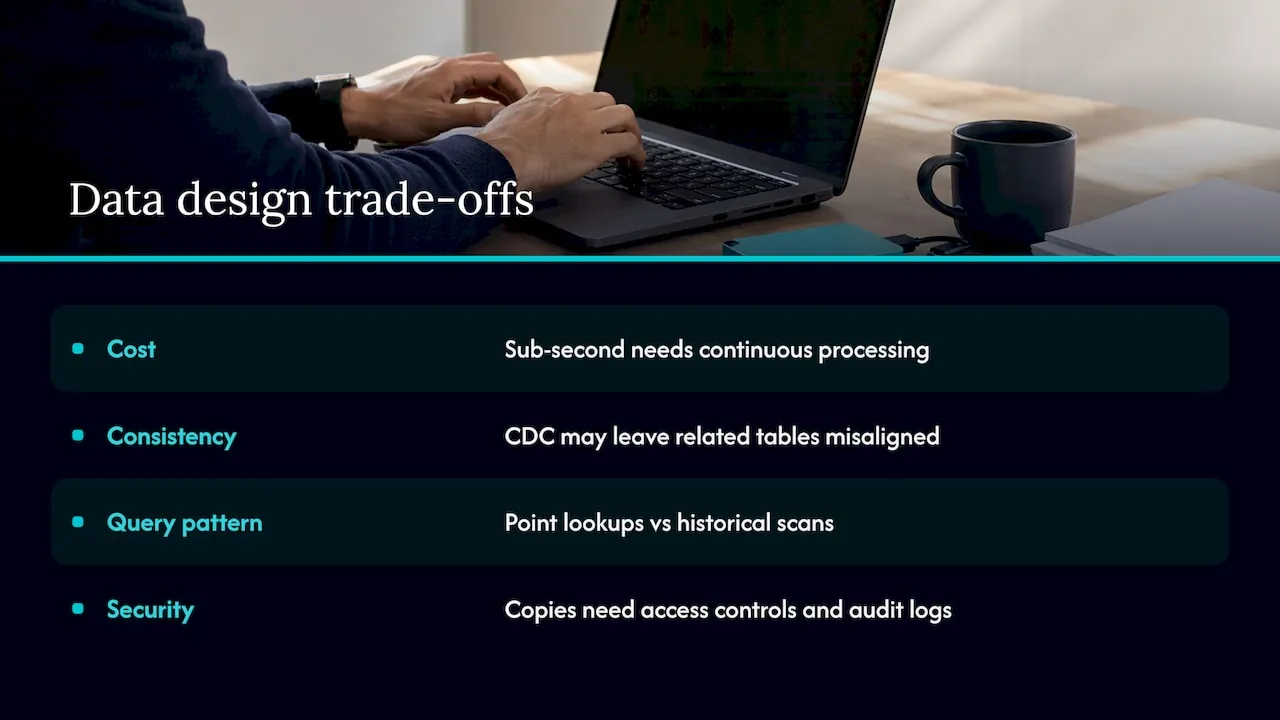
Kostnaden följer latensen. Färskhet under en sekund kräver ständigt pågående inhämtning, bearbetning och leverans med låg latens, medan batchkörning kan stanna när den är inaktiv. Strömning kräver också kompetens inom schemaändringar, övervakning av fördröjning, sena data och återhämtning. Rådet är att välja den lättaste lösning som uppfyller användarens krav, och att fastställa kravet skriftligt innan ni bygger.
Färskt är inte detsamma som konsekvent. CDC kan göra varje tabell färskare utan att garantera att relaterade tabeller speglar exakt samma ögonblick. En fakturasumma och en prenumerationspost kan tillfälligt skilja sig åt. Bestäm vilka rapporter som behöver en konsekvent ögonblicksbild och vilka som kan acceptera en liten fördröjning.
Frågemönstren skiljer sig åt. Ett strömningslager förberäknar små resultatmängder för punktuppslag, medan ett datalager skannar historik för ad hoc-analys. Kostnaderna styrs av olika faktorer, så åtkomstmönstret bör vägleda valet.
Säkerheten följer med datan. En replikerad kopia är inte en informell kopia. Rekommenderade kontroller omfattar åtkomst på roll-, tabell-, kolumn- och radnivå, kryptering i vila och under överföring, granskningsloggning och spårning av dataursprung. Om datan innehåller personuppgifter om kunder i EU gäller GDPR för kopian på samma sätt. Ert dataskyddsombud eller er juridiska rådgivare bör bekräfta vad det innebär för er lösning, eftersom den här artikeln inte är juridisk rådgivning.
Varför datagrunden kommer före AI
De flesta SaaS-team som frågar om ett operativt datalager har ett andra motiv: de vill att AI ska kunna svara på frågor om verksamheten. Det gör datalagerfrågan till en fråga om datakvalitet.
En AI-assistent som läser två system med två definitioner av ”aktiv kund” ger två säkra svar. Lösningen är inte en bättre modell. Den är att komma överens om vilket system som är sanningskällan för varje uppgift, oftast CRM för kunden och ekonomisystemet för pengar, och rensa datan så att den stämmer. Vi går igenom det i CRM och data foundation före AI-agenter och i vår guide till datasintegrationsstrategi för SaaS-team.
Vi arbetar i följande ordning:
- Data foundation. CRM, systemen runt det och Processor, som omvandlar datan till en enda överenskommen version av sanningen. Processor är där det arbetet sker.
- AI-lager. MCP kopplar den datan till den AI-assistent som ert företag redan använder.
- Avdelningsagenter. Specialbyggda agenter för ekonomi, sälj och customer success, som era medarbetare använder på vanligt språk för att hämta data (fråga, rapportera, slå upp) och skicka data (uppdatera poster, starta processer, ge åtkomst), inom ramen för behörigheter, med godkännande där det behövs och med spårbarhet. Se AI-agenter för ekonomi, sälj och customer success.
Ekonomisidan är där färska, integrerade data lönar sig först. Inkasso, kassaflödesprognoser och budgetuppföljning är alla beroende av att fakturerings-, CRM- och bankdata stämmer överens. För konkreta exempel på ekonomidashboards och beslut, se hur kassaflödesprognoser och resultatrapportering är beroende av aktuella siffror.
Där AI inte hör hemma
Att vara tydlig här sparar pengar.
- Där datan inte är överenskommen. Om försäljning och ekonomi inte är överens om intäkterna ska definitionerna åtgärdas först. AI ovanpå döljer bara oenigheten.
- Beslut som kräver åtgärd inom en sekund om pengar eller åtkomst utan godkännande eller revisionsspår. Ha alltid en människa med i processen.
- Juridisk bedömning. AI kan förbereda underlag. Den avgör inte vad GDPR, NIS2 eller EU:s AI-förordning (EU AI Act) kräver av er.
- Processer som är billiga och redan fungerar. AI införs en process i taget, med början i den dyraste, inte den mest trendiga.
NIS2 är EU-direktivet om nät- och informationssäkerhet, och EU AI Act ställer krav utifrån risknivån hos ett AI-system. Båda bör från början behandlas som designkrav, med loggning, åtkomstkontroll och dokumentation inbyggda. Inget verktyg eller ingen arkitektur garanterar efterlevnad på egen hand.
Var datan finns
För europeiska SaaS-bolag spelar kopians placering lika stor roll som dess struktur. När vi bygger, pilotkör och testar använder vi egendriven europeisk infrastruktur i Tyskland, och det vi bygger överförs till er: källkod, dokumentation och infrastruktur. Se skräddarsydd operativ programvara, driftad och ägd inom EU och varför det lönar sig att äga era operativa system för att undvika inlåsning.
Vår syn
Ett datalager är ett medel. Målet är att era CRM- och ekonomidata stämmer överens, att de som leder ekonomi, försäljning och customer success kan ställa en fråga med vanliga ord och få ett svar de litar på, och att någon äger resultatet.
Därför bygger vi i en fast ordning: först datagrunden, sedan AI-lagret som läser den, därefter avdelningsagenter. Vänder man på ordningen får man snabba svar på data som ingen har kommit överens om. Olika aktualitet för olika användare är ett designbeslut, och det bör fattas av en person som förstår både strategin och systemet, vilket är rollen för en fractional Chief AI Officer med operativ erfarenhet.
Vi börjar med den dyraste processen, mäter den och bygger bara där AI lönar sig.
Claus Nielsen
Så kan vi hjälpa till
Om AI redan används i ert bolag men ingen äger frågan, börja med en bild av var det lönar sig och vad era data kan bära. AI Readiness Assessment startar från €4,500 som engångsbelopp. Om ni vill att en namngiven person ska äga AI löpande startar abonnemanget för Fractional Chief AI Officer från €3,000 per månad. Ni kan också boka ett kostnadsfritt upptäcktssamtal på 30 minuter via vår webbplats.
Byggen prissätts antingen som 30% av första årets besparing, när den har mätts och bevisats, eller till ett fast pris som överenskoms innan arbetet börjar. Se priser för mer information.
FAQ
Är ett operativt datalager detsamma som en operational data store?
Inte exakt, även om begreppen överlappar. En ODS innehåller aktuella, detaljerade data från flera system för operativ rapportering. Ett datalager (warehouse) lagrar konsoliderad historik för analys. Vissa moderna datalager klarar båda uppgifterna, så team använder ofta “operativt datalager” om ett system som gör både och.
Hur aktuella behöver rapporteringsdata vara?
Anpassa det efter den person eller det system som använder datan. Människor som läser dashboards behöver oftast data som är några minuter till några timmar gammal. Det är i regel bara automatiserade åtgärder på snabbrörlig data som behöver sekunder. Fastställ kravet innan ni väljer verktyg, eftersom varje steg mot realtid ökar driftkostnaden och det operativa arbetet.
Kan jag rapportera direkt från mitt CRM- eller faktureringssystem?
För ett enda system och ett litet team, ja. När ni kombinerar CRM-, ekonomi- och produktdata, eller när tung rapportering börjar bromsa de system som människor arbetar i, håller ett separat lager rapporteringen åtskild från de dagliga transaktionerna och ger er en gemensam uppsättning definitioner.
Gör en operational data store mig GDPR-kompatibel?
Inget verktyg gör det på egen hand. En kopia av personuppgifter är fortfarande personuppgifter, så åtkomstkontroll, loggning och rättslig grund gäller även för den. Prata med ert dataskyddsombud eller er juridiska rådgivare om just er lösning.
Källor
- Översikt över operational data store
- Operational data store jämfört med datalager
- Typer av datalager och arkitekturer
- Operational data stores: syfte, fördelar och användningsfall
- Modernt förhållningssätt till operational data store
- Arkitekturdesign för HTAP-system
- Så utformar du en arkitektur för realtidsanalys
- Realtidsanalys: när du behöver den och när du inte gör det
- Från batchade ögonblicksbilder till nära realtidsdata
- Datapipeline i nära realtid med change data capture
- TDWI-rapport om operativa datalager
- Operativt datalager jämfört med datalager
- Fractional CFO och tjänster för finansiell rapportering