Um armazém de dados operacional reúne num único local os dados atuais dos seus sistemas de negócio, como CRM, faturação e suporte, para que as equipas possam elaborar relatórios sobre o que está a acontecer agora, e não no mês passado. Para uma empresa B2B SaaS com 20 a 200 pessoas, a questão raramente é qual o produto de armazém de dados a comprar. É que dados têm de estar atualizados, com que frequência, e quem é responsável pela versão única acordada desses dados. Se isto estiver bem resolvido, os relatórios funcionam. É também o passo que decide se a AI dá à sua equipa respostas em que pode confiar.
Em resumo
- Um armazém de dados operacional (ou repositório de dados operacionais, ODS) guarda dados atuais de vários sistemas para relatórios do dia a dia. Um armazém de dados clássico guarda o histórico consolidado para análise.
- “Quase em tempo real” significa normalmente minutos, não milissegundos. Os dashboards consultados por pessoas raramente precisam de mais, e uma maior rapidez custa mais a operar.
- Escolha a atualidade dos dados por utilizador: uma revisão financeira, uma previsão de vendas e uma ação automatizada têm necessidades diferentes.
- Acordar uma única versão dos dados de CRM e de finanças importa mais do que as ferramentas. Os agentes de AI leem essa versão, por isso os erros que aí existam transformam-se em respostas erradas.
- As regras de segurança, de registo e de acesso aplicam-se à cópia dos seus dados operacionais exatamente como ao original. Isto inclui as obrigações do GDPR.
Índice
- O que é um armazém de dados operacional
- Base de dados operacional, ODS, armazém de dados: as diferenças
- Como funciona a arquitetura de relatórios operacionais
- O que significa “quase em tempo real” em números
- Quando precisa de um e quando não precisa
- Os compromissos que decidem o desenho da solução
- Porque é que o alicerce de dados vem antes da AI
- Onde a IA não deve ser usada
- Onde residem os dados
- Como podemos ajudar
- FAQ
- Fontes
O que é um armazém de dados operacional
O termo é usado de forma imprecisa. Na prática, designa um repositório que centraliza os dados operacionais atuais de sistemas como CRM, contabilidade e vendas, além de fontes externas, para que possa elaborar relatórios sobre eles sem consultar cada sistema em separado.
Para uma empresa SaaS, as fontes são conhecidas:
- CRM: contas, contactos, pipeline, renovações.
- Finanças: faturas, pagamentos, subscrições, planos de reconhecimento de receita.
- Produto: utilização, licenças, adoção de funcionalidades.
- Suporte: tickets, escalonamentos, sinais de saúde da conta.
O valor não está no armazenamento. Está em que uma pergunta como “que contas com renovação neste trimestre têm escalonamentos em aberto e faturas por pagar?” tenha uma única resposta, e não três folhas de cálculo que se contradizem.
Base de dados operacional, ODS, armazém de dados: as diferenças
Quatro termos são frequentemente confundidos. É assim que se distinguem.
| Base de dados operacional | Repositório de dados operacionais (ODS) | Armazém de dados | |
|---|---|---|---|
| Finalidade | Executa um sistema transacional, como o seu CRM ou a sua ferramenta de faturação | Dados atuais e detalhados de vários sistemas para relatórios operacionais | Histórico consolidado e depurado para análise |
| Atualidade | Em produção | De segundos a minutos ou horas | De horas a dias |
| Histórico | O que a aplicação mantiver | Curto: dados atuais ou recentes | Longo: de meses a anos |
| Pergunta típica | “Atualize este registo” | “O que está em aberto hoje?” | “Como evoluiu a taxa de cancelamento ao longo de três anos?” |
As distinções seguem descrições publicadas: uma base de dados operacional está integrada num sistema transacional, um ODS reúne dados transacionais detalhados de vários sistemas com atualizações frequentes, e um armazém de dados é um arquivo de longo prazo mais estático. Um ODS situa-se entre os sistemas transacionais e o armazém de dados analítico, contendo dados atuais ou recentes atualizados de minutos a horas, para perguntas como as vendas do próprio dia ou os casos de suporte ativos.
Os intervalos de latência típicos são de segundos a minutos, com retenção de dias a semanas, num ODS, contra horas a dias, com meses a anos, num armazém de dados. Um ODS normalmente reproduz a estrutura dos sistemas de origem e é adequado para relatórios operacionais simples, ao passo que um armazém de dados aplica uma transformação mais completa e mantém um grande histórico.
Os armazéns de dados modernos na cloud esbatem a fronteira. Podem disponibilizar dados em tempo real e eliminar a necessidade de um ODS separado. Assim, “armazém de dados operacional” deve ler-se como uma descrição de função, não como um produto: dados atuais e integrados, suficientemente fiáveis para gerir o negócio.
Como funciona a arquitetura de relatórios operacionais
Sejam quais forem as ferramentas, a arquitetura tem as mesmas camadas.
- Origens. CRM, faturação, base de dados do produto, ferramenta de suporte.
- Ingestão. Os dados saem das origens. A captura de dados de alteração (CDC) envia apenas inserções, atualizações e eliminações, o que reduz o volume transferido e a carga na rede e nos sistemas de origem.
- Processamento. Os dados são limpos, cruzados entre sistemas (um cliente, um ID) e moldados segundo definições acordadas.
- Disponibilização. Um repositório que responde rapidamente às consultas das pessoas e das ferramentas que o utilizam.
- Consumo. Painéis, relatórios, alertas e assistentes de AI.
Um padrão em camadas comum é um ODS com dados em bruto quase em tempo real para relatórios operacionais, com camadas a jusante que limpam, agregam e disponibilizam. Um desenho frequente encaminha as bases de dados transacionais para filas e depois para as camadas do armazém de dados, para que os relatórios não abrandem os sistemas em que a sua equipa trabalha. Essa separação é a principal razão para não apontar painéis diretamente para o seu CRM ou para a base de dados de faturação.
Se os seus sistemas já publicam alterações como eventos, o mesmo fluxo pode assentar nisso. O nosso guia sobre arquitetura orientada a eventos mostra como funciona e onde se aplica.
O que significa “quase em tempo real” em números
A maioria das equipas que pedem tempo real precisa de algo mais modesto. Um quadro de referência de profissionais apresenta níveis de atualização de menos de um segundo, de segundos a cerca de um minuto, e de minutos a diário. Outro descreve o quase tempo real como aproximadamente de um a 15 minutos, com micro-lotes ou CDC.
Dois exemplos reais mostram o que é possível:
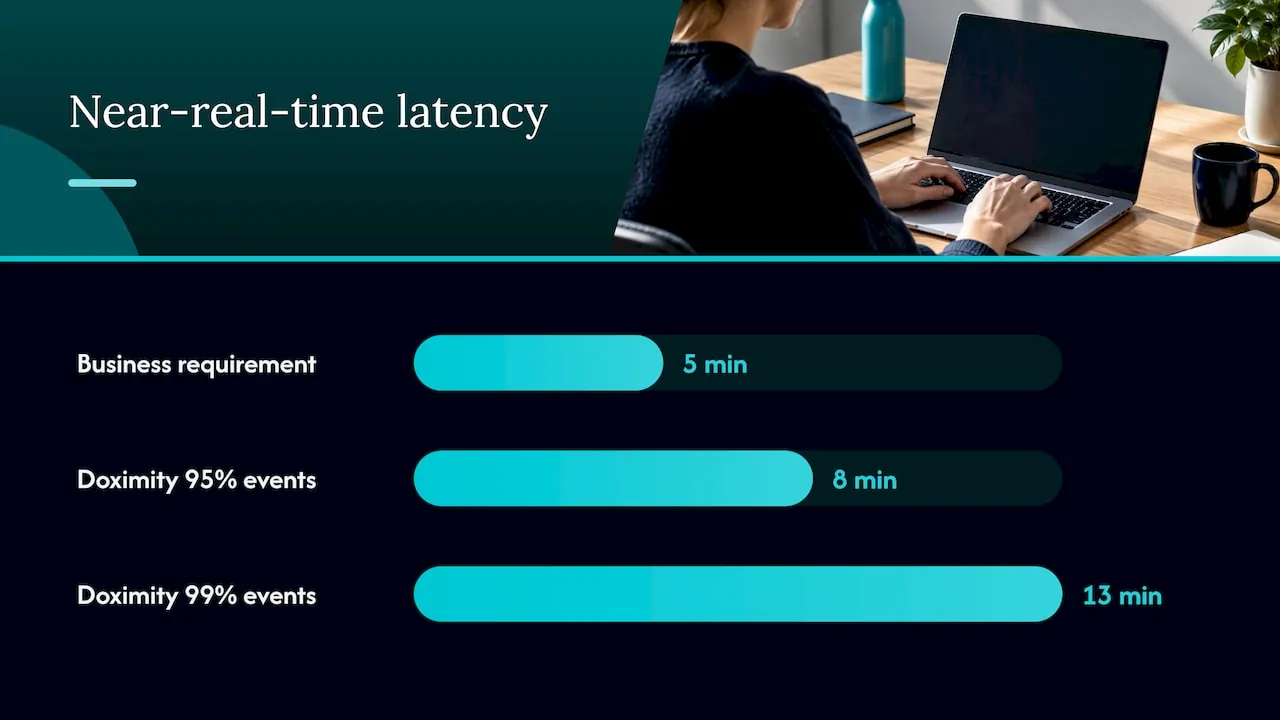
- Uma equipa de engenharia da Doximity relatou que o seu pipeline de CDC tornava as alterações consultáveis em minutos. Numa amostra de 12 dias, 95% dos eventos chegaram à camada consultável em oito minutos e 99% em 13 minutos.
- Uma tese universitária construiu um pipeline de CDC com latência média ponta a ponta de 0.6 segundos a cerca de 30,000 registos por segundo, observando ao mesmo tempo que o requisito de relatórios do negócio era de cinco minutos.
O segundo exemplo é o mais útil. A engenharia consegue superar o requisito por larga margem, e a velocidade extra não traz nada ao negócio.
Há também uma diferença entre agir sobre dados em movimento e consultar dados que chegaram recentemente. Ações automáticas de fraude ou de preços podem exigir o primeiro caso, ao passo que os painéis usados por pessoas normalmente só precisam de dados recentes. Um responsável de vendas a rever o funil de vendas ou um responsável financeiro a verificar as cobranças é um painel utilizado por pessoas.
Quando precisa de um e quando não precisa
As decisões operacionais sensíveis ao tempo são o caso para isso. A investigação sobre armazenamento de dados operacional enumera inventário, dotação de pessoal, previsão da procura e painéis de desempenho como exemplos suportados por dados intradiários ou horários. Os usos comuns em relatórios incluem painéis de vendas em direto, cumprimento de encomendas, vistas unificadas de clientes e monitorização.
Uma camada operacional de disponibilização dedicada é justificada quando o atraso de atualização do armazém de dados é demasiado lento para painéis em direto, verificações de fraude ou contexto de AI, e desnecessária quando todos os consumidores são analistas e horas ou dias são aceitáveis.
Para uma empresa SaaS com 20 a 200 pessoas, uma regra viável:
- Relatórios de gestão semanais ou mensais: uma atualização diária para um repositório consolidado é suficiente.
- Gestão de contas, renovações, cobranças: a atualização horária ou ao nível dos minutos entre CRM, finanças e suporte é onde está o valor.
- Ações automáticas que alteram registos ou desencadeiam processos: atualização, mais permissões e aprovação, abordadas abaixo.
- Transmissão contínua em menos de um segundo: raramente justificada à sua dimensão.
Os compromissos que decidem o desenho da solução
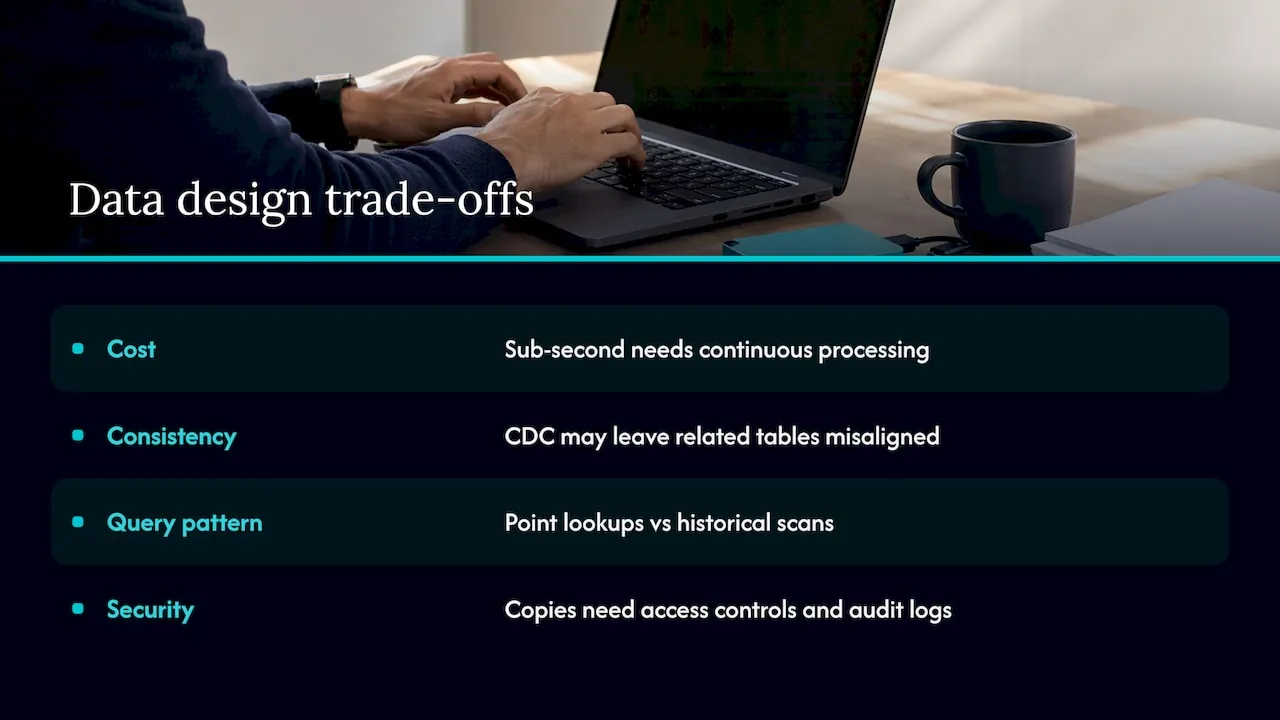
O custo acompanha a latência. Uma atualização abaixo do segundo exige ingestão, processamento e disponibilização de baixa latência em execução contínua, enquanto o processamento em lote pode parar quando está inativo. A transmissão contínua exige também competências em alterações de esquema, monitorização de atraso, dados tardios e recuperação. O conselho é escolher a solução mais leve que cumpra o requisito do consumidor e definir esse requisito por escrito antes de construir.
Atualizado não é o mesmo que consistente. O CDC pode tornar cada tabela mais atual sem garantir que as tabelas relacionadas reflitam exatamente o mesmo momento. O total de uma fatura e um registo de subscrição podem divergir por instantes. Decida que relatórios precisam de uma imagem consistente e quais podem aceitar um pequeno atraso.
Os padrões de consulta diferem. Uma camada de transmissão contínua pré-calcula pequenos conjuntos de resultados para consultas pontuais, enquanto um armazém de dados percorre o histórico para análise ad hoc. Os custos seguem fatores diferentes, pelo que o padrão de acesso deve orientar a escolha.
A segurança acompanha os dados. Uma cópia replicada não é uma cópia informal. Os controlos recomendados incluem acesso por função, tabela, coluna e linha, cifragem em repouso e em trânsito, registo de auditoria e rastreio de linhagem. Se os dados incluírem dados pessoais de clientes da UE, o RGPD aplica-se à cópia da mesma forma. O seu encarregado da proteção de dados ou o seu advogado devem confirmar o que isso significa para a sua configuração, porque este artigo não constitui aconselhamento jurídico.
Porque é que o alicerce de dados vem antes da AI
A maioria das equipas SaaS que perguntam por um armazém de dados operacional tem um segundo motivo: querem que a AI responda a perguntas sobre o negócio. Isso faz da questão do armazém de dados uma questão de qualidade dos dados.
Um assistente de AI que lê dois sistemas com duas definições de “cliente ativo” dá duas respostas confiantes. A solução não é um modelo melhor. É acordar qual é o sistema de referência para cada facto, normalmente o CRM para o cliente e as finanças para o dinheiro, e limpar os dados em conformidade. Tratamos disso em CRM e fundação de dados antes dos agentes de AI e no nosso guia de estratégia de integração de dados para equipas SaaS.
A ordem em que trabalhamos é:
- Fundação de dados. O CRM, os sistemas à sua volta e o Processor que transforma os dados numa versão única e acordada da verdade. O Processor é onde esse trabalho se concentra.
- Camada de AI. O MCP liga esses dados ao assistente de AI que a sua empresa já utiliza.
- Agentes departamentais. Agentes concebidos para Finanças, Vendas e Sucesso do Cliente, que as suas pessoas usam em linguagem corrente para extrair dados (perguntar, reportar, consultar) e enviar dados (atualizar registos, desencadear processos, atribuir acessos), dentro das permissões, com aprovação quando necessário e um registo de auditoria. Veja Agentes de AI para Finanças, Vendas e Sucesso do Cliente.
O lado financeiro é onde os dados atuais e integrados compensam primeiro. As cobranças, a previsão de tesouraria e o acompanhamento orçamental dependem todos de a faturação, o CRM e os dados bancários estarem de acordo. Para exemplos concretos de painéis e decisões financeiras, veja como a previsão do fluxo de caixa e os relatórios de desempenho dependem de números atuais.
Onde a IA não deve ser usada
Ser explícito aqui poupa dinheiro.
- Onde os dados não estão alinhados. Se as vendas e as finanças discordam sobre a receita, comece por corrigir as definições. A IA por cima apenas esconde a divergência.
- Decisões que exigem ação em menos de um segundo sobre dinheiro ou acessos sem aprovação nem registo de auditoria. Mantenha uma pessoa no circuito.
- Juízo jurídico. A IA pode preparar informação. Não decide o que o RGPD, a NIS2 ou o EU AI Act exigem de si.
- Processos baratos e que já funcionam. A IA adota-se um processo de cada vez, começando pelo mais dispendioso, não pelo mais na moda.
A NIS2 é a diretiva da UE relativa à segurança das redes e da informação, e o EU AI Act estabelece obrigações consoante o nível de risco de um sistema de IA. O melhor é tratar ambos como requisitos de conceção desde o início, com registo de atividade, controlo de acessos e documentação integrados. Nenhuma ferramenta ou arquitetura garante, por si só, a conformidade.
Onde residem os dados
Para as empresas SaaS europeias, a localização da cópia importa tanto como a sua estrutura. Quando construímos, fazemos pilotos e testamos, utilizamos infraestrutura europeia self-hosted na Alemanha, e aquilo que construímos é transferido para si: código-fonte, documentação e infraestrutura. Veja software operacional à medida, alojado e detido na UE e como ser proprietário dos seus sistemas operacionais evita a dependência de fornecedor.
A nossa perspetiva
Um data warehouse é um meio. O objetivo é que os dados do seu CRM e das finanças coincidam, que as pessoas que dirigem as Finanças, as Vendas e o Customer Success possam fazer uma pergunta em linguagem simples e obter uma resposta em que confiam, e que alguém seja responsável pelo resultado.
É por isso que construímos por uma ordem fixa: primeiro a base de dados (data foundation), depois a camada de IA que a lê, e só então os agentes por departamento. Inverta a ordem e obtém respostas rápidas sobre dados que ninguém validou. Atualidade diferente para consumidores diferentes é uma decisão de conceção, e deve ser tomada por uma só pessoa que compreenda tanto a estratégia como o sistema, que é o papel de um Fractional Chief AI Officer com experiência operacional.
Começamos pelo processo mais dispendioso, medimo-lo e construímos apenas onde a IA compensa.
Claus Nielsen
Como podemos ajudar
Se a IA já é usada na sua empresa mas ninguém é responsável por ela, comece por uma visão de onde compensa e do que os seus dados conseguem suportar. O AI Readiness Assessment começa em €4,500, pagamento único. Se quiser uma pessoa identificada como responsável pela IA de forma contínua, o serviço de Fractional Chief AI Officer começa em €3,000 por mês. Pode também marcar uma chamada de descoberta gratuita de 30 minutos através do nosso site.
Os projetos são cobrados ou a 30% da poupança do primeiro ano, depois de medida e comprovada, ou a um preço fixo acordado antes de o trabalho começar. Consulte os preços para mais detalhes.
FAQ
Um operational data warehouse é o mesmo que um operational data store?
Não exatamente, embora os termos se sobreponham. Um ODS contém dados atuais e detalhados de vários sistemas para reporting operacional. Um warehouse conserva o histórico consolidado para análise. Alguns warehouses modernos cumprem ambas as funções, pelo que as equipas usam frequentemente “operational data warehouse” para um único sistema que faz as duas coisas.
Com que atualidade precisam os dados de reporting de estar?
Ajuste-a à pessoa ou ao sistema que os utiliza. Quem lê dashboards precisa normalmente de dados com minutos ou horas. Só as ações automatizadas sobre dados que mudam depressa tendem a precisar de segundos. Defina o requisito antes de escolher ferramentas, porque cada passo em direção ao tempo real aumenta o custo de funcionamento e o esforço operacional.
Posso fazer reporting diretamente a partir do meu CRM ou sistema de faturação?
Para um único sistema e uma equipa pequena, sim. Quando combina dados de CRM, finanças e produto, ou quando o reporting intensivo começa a abrandar os sistemas em que as pessoas trabalham, uma camada separada mantém o reporting afastado das transações do dia a dia e dá-lhe um conjunto único de definições acordadas.
Um operational data store torna-me conforme com o RGPD?
Nenhuma ferramenta o faz por si só. Uma cópia de dados pessoais continua a ser dados pessoais, pelo que se lhe aplicam controlo de acessos, registo de atividade e uma base legal. Fale com o seu encarregado de proteção de dados ou com o seu consultor jurídico sobre a sua configuração concreta.
Fontes
- Visão geral do operational data store
- Operational data store vs. data warehouse
- Tipos e arquiteturas de data warehouse
- Operational data stores: finalidade, benefícios e casos de utilização
- Abordagem moderna ao operational data store
- Conceção da arquitetura de sistemas HTAP
- Como conceber uma arquitetura de análise em tempo real
- Análise em tempo real: quando é necessária e quando não é
- De snapshots em lote a dados em quase tempo real
- Pipeline de dados em quase tempo real com change data capture
- Relatório da TDWI sobre operational data warehousing
- Operational data layer vs data warehouse
- Serviços de Fractional CFO e de reporting financeiro